Context engineering - jak zarządzać kontekstem modelu, żeby agent AI nie gubił wątku
W czerwcu 2025 Andrej Karpathy zaproponował, żeby zamiast o „prompt engineeringu" mówić o „context engineeringu". Jego definicja szybko się przyjęła: to sztuka i nauka wypełniania okna kontekstu dokładnie tymi informacjami, których model potrzebuje w następnym kroku. Powód zmiany nazwy jest praktyczny. Prompt kojarzy się z krótkim poleceniem wpisanym w czat. W agencie AI, który przez kilkadziesiąt kroków wywołuje narzędzia, czyta pliki i zbiera wyniki, samo polecenie to drobna część tego, co model widzi. Resztę stanowią instrukcje systemowe, definicje narzędzi, wyniki wyszukiwania, historia rozmowy i notatki - i to właśnie ta reszta decyduje o jakości odpowiedzi.
Badanie Chroma pokazało, że wszystkie 18 testowanych modeli traci jakość wraz ze wzrostem długości kontekstu, a w agencie Manus na jeden token odpowiedzi przypada około 100 tokenów wejścia. Czym jest context engineering, dlaczego długi kontekst szkodzi, cztery techniki (zapisz, wybierz, skompresuj, rozdziel) i budżet kontekstu w praktyce.
Problem polega na tym, że więcej kontekstu nie znaczy lepiej. Badanie Chroma z lipca 2025 pokazało, że wszystkie 18 przetestowanych modeli, w tym GPT-4.1, Claude Opus 4 i Gemini 2.5, radzi sobie gorzej wraz ze wzrostem długości danych wejściowych, nawet przy prostych zadaniach. Agent, który „zapomina" wcześniejsze ustalenia albo zaczyna się mylić po godzinie pracy, zwykle nie ma za małego okna kontekstu, tylko źle nim zarządzane. W tym wpisie wyjaśniam, czym jest context engineering, dlaczego długi kontekst szkodzi, jakie są cztery podstawowe techniki i jak przełożyć je na budowę agentów w firmie.
/// DLACZEGO WIĘCEJ KONTEKSTU TO NIE ZAWSZE LEPIEJ
Czym jest context engineering
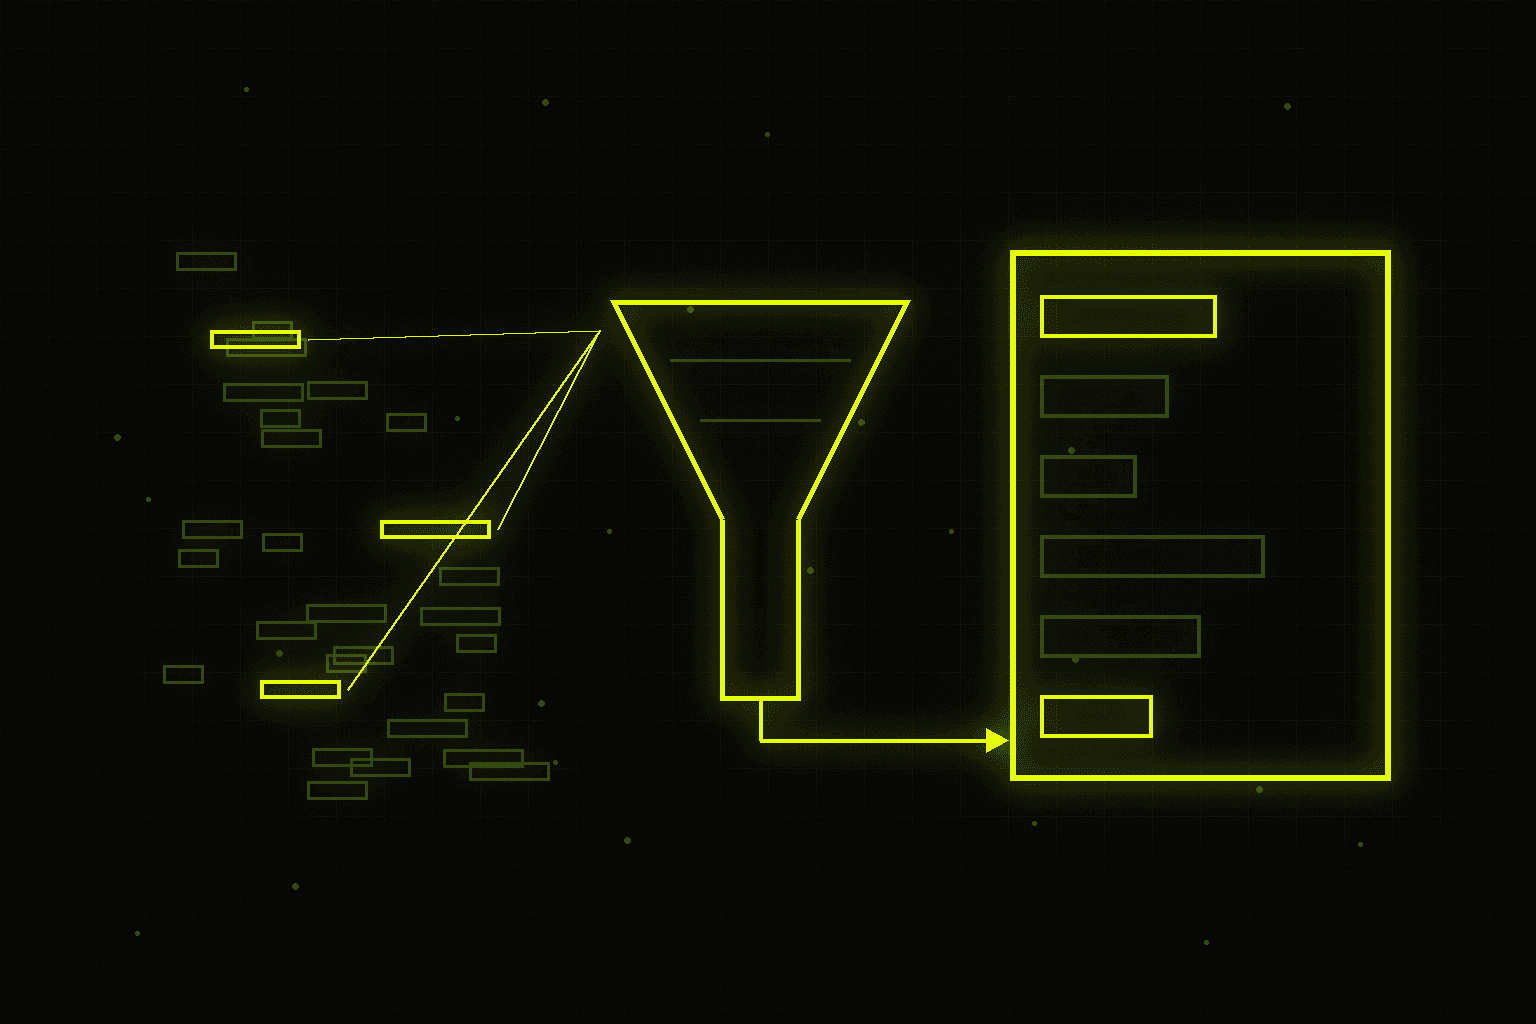
Okno kontekstu to wszystko, co model „widzi" w danym momencie: instrukcje, dane, historia i wyniki narzędzi. Model nie ma innej pamięci roboczej - jeśli czegoś nie ma w oknie, dla modelu to nie istnieje. Context engineering to projektowanie tego, co trafia do okna, w jakiej kolejności i w jakiej formie, na każdym kroku pracy agenta.
Różnicę widać najlepiej na przykładzie. Prompt engineering odpowiada na pytanie: jak sformułować polecenie, żeby model dobrze je zrozumiał. Context engineering odpowiada na pytanie: które z tysięcy dostępnych informacji model powinien zobaczyć teraz, a które lepiej trzymać poza oknem i pobrać dopiero wtedy, gdy będą potrzebne. Pisanie dobrych poleceń nadal ma znaczenie - opisałem je we wpisie o prompt engineeringu dla biznesu - ale przy agentach to tylko jedna warstwa z kilku.
Dlaczego długi kontekst szkodzi
Producenci modeli podają coraz większe okna kontekstu: 200 tysięcy, milion tokenów. Łatwo uznać, że wystarczy wrzucić do okna wszystko. Badania pokazują, że to błąd.
- Context rot. W badaniu Chroma jakość odpowiedzi spadała wraz z długością danych wejściowych u wszystkich 18 modeli i przy każdym testowanym przyroście długości. Spadek był nierówny i zależał m.in. od tego, ile w tekście jest podobnych, ale nieistotnych fragmentów.
- Zagubione w środku. Badanie Stanforda „Lost in the Middle" pokazało, że modele najlepiej wykorzystują informacje z początku i końca kontekstu, a najsłabiej te ze środka.
- Koszt i czas. Każdy token w oknie kosztuje przy każdym wywołaniu. W agencie Manus stosunek tokenów wejściowych do wyjściowych wynosi średnio około 100 do 1 - prawie cały koszt to czytanie kontekstu, a nie pisanie odpowiedzi.
Wniosek jest jeden: okno kontekstu to zasób o ograniczonej pojemności uwagi, a nie magazyn. Każdy niepotrzebny fragment obniża szansę, że model zauważy ten ważny.
Cztery techniki: zapisz, wybierz, skompresuj, rozdziel
Najczytelniejszy podział technik zaproponował zespół LangChain. Każda odpowiada na inne pytanie.
/// CZTERY TECHNIKI CONTEXT ENGINEERINGU
* Podział według zespołu LangChain (write, select, compress, isolate).
1. Zapisz poza oknem. Agent prowadzi notatki w plikach (np. NOTES.md albo lista zadań), zamiast trzymać wszystko w historii rozmowy. Po kilkudziesięciu krokach czyta notatki i od razu wie, na czym stanął. Manus opisuje ten sam wzorzec: system plików jako praktycznie nieograniczona pamięć, a lista zadań przepisywana na końcu kontekstu, żeby cel nie zginął w środku długiej sesji.
2. Wybierz tylko to, co potrzebne. Zamiast ładować na start wszystkie dokumenty, agent pobiera je „w momencie potrzeby": wyszukuje, czyta fragment, sprawdza. Anthropic nazywa to podejściem just-in-time i zaleca trzymanie w kontekście lekkich wskaźników (ścieżek plików, identyfikatorów, zapytań), a nie całych treści. To ta sama logika, na której opiera się zaawansowany RAG - dobre wyszukiwanie to połowa context engineeringu.
3. Skompresuj to, co już jest. Gdy okno się zapełnia, starsza część rozmowy jest streszczana, a agent kontynuuje z czystym oknem i streszczeniem. Anthropic zaleca, żeby prompt do streszczania najpierw maksymalizował kompletność, a dopiero potem usuwał zbędne szczegóły. Najprostsza i najbezpieczniejsza forma kompresji to usuwanie starych wyników narzędzi, które już zostały wykorzystane.
4. Rozdziel między agentów. Złożone zadanie dzielisz na podzadania dla osobnych agentów, z których każdy pracuje w czystym oknie i zwraca tylko krótkie podsumowanie. W systemie badawczym Anthropic taki układ wypadł o 90,2% lepiej od pojedynczego agenta w wewnętrznych testach, ale zużywał około 15 razy więcej tokenów niż zwykły czat. Rozdzielenie kontekstu kosztuje, więc opłaca się tam, gdzie wartość wyniku uzasadnia wydatek. Kiedy system wieloagentowy ma sens, a kiedy nie, opisałem we wpisie o multi-agent AI.
Budżet kontekstu w praktyce
Dobrze zaprojektowany agent ma jawny budżet: wiadomo, ile miejsca zajmuje każdy rodzaj informacji i co dzieje się, gdy budżet się kończy. Przykładowy układ okna dla agenta obsługującego zapytania klientów:
[1] Instrukcje systemowe i zasady stałe, na początku - korzystają z cache[2] Definicje narzędzi tylko te potrzebne w tym zadaniu[3] Notatki i pamięć krótkie, aktualizowane przez agenta[4] Wyniki wyszukiwania i pliki fragmenty, nie całe dokumenty[5] Historia rozmowy ostatnie kroki w całości, starsze streszczone[6] Bieżące zadanie na końcu okna, tuż przed odpowiedzią
Kolejność nie jest przypadkowa. Stałe elementy na początku pozwalają korzystać z cache, a bieżące zadanie na końcu trafia tam, gdzie model zwraca na informacje największą uwagę. Manus uważa trafienia w cache za najważniejszy wskaźnik agenta w produkcji: dla Claude Sonnet tokeny z cache kosztowały 0,30 USD za milion, a bez cache 3 USD, czyli dziesięć razy więcej. Wystarczy jeden zmieniony znak na początku instrukcji, na przykład znacznik czasu z sekundami, żeby unieważnić cache dla całej reszty. Więcej o obniżaniu kosztów API, w tym o cache, piszę we wpisie o optymalizacji kosztów OpenAI API.
Narzędzia też zajmują kontekst
Łatwo przeoczyć, że definicje narzędzi trafiają do okna przy każdym wywołaniu. Pojedyncza definicja narzędzia w MCP to zwykle od kilkuset do ponad tysiąca tokenów, a oficjalny serwer MCP GitHuba z 94 narzędziami zajmuje około 17,6 tysiąca tokenów samymi definicjami. Kilka podłączonych serwerów potrafi zjeść kilkadziesiąt tysięcy tokenów, zanim agent zrobi cokolwiek.
Rozwiązania są dwa. Pierwsze to wyszukiwanie narzędzi: agent dostaje na start tylko krótki spis i pobiera pełną definicję narzędzia dopiero wtedy, gdy chce z niego skorzystać. Drugie to wykonywanie kodu zamiast wielu wywołań: agent pisze krótki skrypt, który sam wywołuje narzędzia i przetwarza dane, a do kontekstu wraca tylko wynik. W przykładzie opisanym przez Anthropic takie podejście zmniejszyło zużycie ze 150 tysięcy do około 2 tysięcy tokenów. Szerzej o samym protokole piszę we wpisie o MCP, a o tym, jak agenci korzystają z narzędzi, we wpisie o agentach AI.
Pamięć w sesji a pamięć między sesjami
Context engineering dotyczy tego, co dzieje się w trakcie jednej sesji pracy agenta. Pamięć między sesjami - co agent wie o użytkowniku po tygodniu przerwy - to osobny problem, który opisałem we wpisie o pamięci agenta AI. Obie warstwy się łączą: notatki zapisane w trakcie sesji mogą stać się pamięcią długoterminową, a pamięć długoterminowa to kolejne źródło, z którego agent wybiera, co załadować do okna.
Dostawcy modeli zaczęli wbudowywać te mechanizmy w swoje platformy. Anthropic udostępnił automatyczne czyszczenie starych wyników narzędzi z okna i narzędzie pamięci oparte na plikach. W wewnętrznym teście wyszukiwania połączenie obu poprawiło wyniki o 39% względem wersji bazowej, a w teście ze 100 krokami wyszukiwania samo czyszczenie kontekstu zmniejszyło zużycie tokenów o 84% i pozwoliło ukończyć zadania, które wcześniej przerywało przepełnienie okna.
Wzorce z wdrożeń
Te same zasady widać w projektach, które budowałem. W systemie Konkret silnik wycen korzysta z 70 kosztorysów o łącznej wielkości 3,2 GB - żadne okno kontekstu tego nie zmieści, więc model dostaje tylko kilka najbardziej podobnych kosztorysów wybranych przez wyszukiwanie, a nie całe archiwum. W GiftFinderze kaskada modeli dzieli pracę tak, że tańszy model przetwarza dużo danych, a mocniejszy dostaje już tylko wybrane, uporządkowane wyniki do finalnej redakcji.
W obu przypadkach reguła jest ta sama: model na końcu łańcucha powinien widzieć mniej, ale lepiej dobranych informacji niż model na początku. Do tego dochodzi praktyka, którą stosuję wszędzie: wyniki narzędzi zwracane w ustalonej strukturze, a nie jako surowy tekst - opisuję to we wpisie o structured outputs. Uporządkowany wynik zajmuje mniej miejsca i łatwiej go streścić albo usunąć, gdy przestanie być potrzebny.
Najczęstsze błędy
- Wrzucanie wszystkiego „na wszelki wypadek". Całe dokumenty zamiast fragmentów, wszystkie narzędzia zamiast potrzebnych. Każdy nadmiarowy element obniża jakość.
- Zmienne elementy na początku instrukcji. Data, godzina czy identyfikator sesji w pierwszym zdaniu unieważniają cache przy każdym wywołaniu.
- Brak strategii na koniec budżetu. Agent działa do przepełnienia okna i przerywa zadanie albo zaczyna się mylić, zamiast streszczać i kontynuować.
- Streszczenia, które gubią szczegóły. Kompresja bez testów na prawdziwych przebiegach potrafi usunąć dokładnie tę informację, której agent będzie potrzebował za dziesięć kroków.
- Wieloagentowość tam, gdzie wystarczy jeden agent. Rozdzielanie kontekstu przy zadaniach mocno powiązanych zwiększa koszty i liczbę błędów przy przekazywaniu informacji.
Plan wdrożenia krok po kroku
- 1.Zmierz, co jest w oknie. Zapisz pełny kontekst kilku przebiegów agenta i sprawdź, ile zajmują instrukcje, narzędzia, wyniki i historia.
- 2.Ustaw stałą część na początku. Instrukcje i definicje narzędzi bez zmiennych elementów, żeby działał cache.
- 3.Ogranicz narzędzia do tych potrzebnych w danym zadaniu albo wprowadź wyszukiwanie narzędzi.
- 4.Pobieraj dane na żądanie zamiast ładować wszystko na start; trzymaj w oknie wskaźniki, nie całe treści.
- 5.Dodaj notatki poza oknem dla zadań dłuższych niż kilkanaście kroków.
- 6.Wprowadź kompresję: usuwanie starych wyników narzędzi, a przy długich sesjach streszczanie historii.
- 7.Testuj streszczenia na prawdziwych przebiegach, sprawdzając, czy agent nie traci potrzebnych informacji.
- 8.Rozważ podagentów tylko dla zadań, które da się dobrze rozdzielić, i policz koszt.
- 9.Monitoruj długość kontekstu, trafienia w cache i jakość wyników w czasie.
---
Projektuję i buduję agentów AI, którzy pracują stabilnie przez wiele kroków - od budżetu kontekstu i wyszukiwania danych na żądanie, przez kompresję i notatki, po monitorowanie kosztów. Robię to w ramach tworzenia aplikacji AI, a warsztat context engineeringu jest częścią kursu AI Engineer. Napisz do mnie - zacznę od analizy pełnego kontekstu kilku przebiegów Twojego agenta i listy rzeczy, które można z niego usunąć.
Warto przeczytać dalej:
- Pamięć agenta AI - jak sprawić, by chatbot i agent pamiętali użytkownika między sesjami
- Prompt Engineering dla Biznesu - jak rozmawiać z AI, żeby dawało wyniki
- Zaawansowany RAG - chunking strategy, hybrid search i reranking w produkcji
- Multi-agent AI - kiedy jeden agent to za mało i jak budować systemy wieloagentowe
/// RELATED_SERVICES
Potrzebujesz wdrożenia tych koncepcji? Zobacz usługi powiązane z tym tematem.
Budowa Aplikacji AI
Dedykowane oprogramowanie AI i aplikacje webowe z silnikiem AI — MVP, full stack development, programowanie systemów AI od zera do produkcji.
Zobacz usługęUsługaAI & Automatyzacja
Agenci AI 24/7, automatyzacja procesów z n8n i Make, chatboty, RAG z Twoimi danymi i custom LLM. Buduję systemy AI, które redukują ręczną pracę i zwiększają efektywność.
Zobacz usługę/// ŹRÓDŁA
- 01Anthropic - Effective context engineering for AI agents
- 02Chroma - Context Rot: How Increasing Input Tokens Impacts LLM Performance
- 03Manus - Context Engineering for AI Agents: Lessons from Building Manus
- 04ACL Anthology - Lost in the Middle: How Language Models Use Long Contexts
- 05Anthropic - How we built our multi-agent research system
- 06Claude Blog - Managing context on the Claude Developer Platform
- 07Anthropic - Code execution with MCP: building more efficient AI agents
- 08LangChain - Context Engineering
/// RELATED_RECORDS
Generowanie wideo i grafik AI w marketingu - narzędzia, koszty i prawa autorskie w 2026
OpenAI zamknęło Sorę niecały rok po premierze Sora 2, a Veo 3.1 kosztuje dziś od 0,05 do 0,40 USD za sekundę wideo. Jakie narzędzia do wideo i grafik AI działają w 2026, ile naprawdę kosztuje zaakceptowany materiał, kto ma prawa autorskie, jak oznaczać treści od sierpnia 2026 i jak zbudować proces z kontrolą człowieka.
Automatyzacja social media z AI - jeden materiał na wiele kanałów bez utraty głosu marki
Przycisk „Seems like AI slop” na LinkedIn kliknięto ponad milion razy w trzy tygodnie, a posty kopiowane prosto z czatu tracą około 40% wyświetleń. Jak zbudować w n8n pipeline, który przerabia jeden materiał na treści dla LinkedIn, newslettera i X, zachowuje głos marki i przechodzi przez akceptację człowieka.
Analiza umów z AI - przegląd ryzyk, porównanie wersji i checklista przed podpisem
W teście Vals z 2025 roku AI wygrało z prawnikami w ekstrakcji danych i streszczeniach, ale przegrało w nanoszeniu poprawek do umów (79,7% u prawników). Jak zbudować przegląd umów, w którym AI znajduje klauzule i ryzyka, a człowiek decyduje - plus playbook pod polskie prawo i ochrona przed ukrytymi poleceniami w dokumentach.
Signal received?
Przerwij
Ciszę
Zainicjuj protokół. Nawiąż połączenie. Zbudujmy coś głośnego.