WRÓĆ DO GEO – Pozycjonowanie w AI

Audyt Widoczności w AI – Audyt GEO Twojej Marki

Raport audytowy: jak ChatGPT, Gemini, Claude i Perplexity postrzegają i polecają Twoją markę. Co wiedzą LLM o Twoim biznesie i jak to zmienić.

Autor: Paweł Wiszniewski · Aktualizacja:

W skrócie

Raport audytowy: jak ChatGPT, Gemini, Claude i Perplexity postrzegają i polecają Twoją markę. Co wiedzą LLM o Twoim biznesie i jak to zmienić.

  • ›Raport z 100+ testami zapytań w ChatGPT, Gemini, Claude i Perplexity
  • ›Analiza porównawcza z top 5 konkurentami
  • ›Identyfikacja błędnych lub przestarzałych informacji o Twojej firmie w odpowiedziach LLM i rekomendacja jak je skorygować.

Cena: od 1 500 zł

SZCZEGÓŁY USŁUGI

Przeprowadzam systematyczny audyt widoczności Twojej marki w głównych asystentach AI (ChatGPT, Gemini, Claude, Perplexity, Copilot). Testuję 100+ branżowych zapytań, dokumentuję jak LLM opisują Twoją firmę, produkty i usługi, porównuję z Twoją konkurencją i dostarczam priorytetyzowany plan działań poprawiających pozycję w odpowiedziach generowanych przez AI.

› INVESTMENT:

od 1 500 zł
const module = new ExecutionProtocol();

// Initializing audyt-widocznosci-ai...
› Loading dependencies... OK
› Establishing connection... OK
› Ready for deployment... AWAITING_COMMAND

Paweł Wiszniewski · moje podejście

Co robię inaczej

Mój audyt nie polega na wpisaniu kilku pytań do ChatGPT i zrobieniu zrzutów ekranu. Pytania klientów puszczam przez kilka modeli i powtarzam pomiar, bo odpowiedzi AI są niedeterministyczne — jeden test potrafi wprowadzić w błąd. Odpowiedzi ocenia AnswerLyzer, moje narzędzie oparte na LLM-as-a-judge, a losową część sprawdzam ręcznie. Dostajesz nie tylko wynik, ale też listę źródeł, które w Twojej kategorii decydują o tym, kogo AI poleca — to zwykle najcenniejsza część raportu.

Case study: AnswerLyzer AI Analytics

Moje zdanie i przykład z rynku

Moje zdanie

Moim zdaniem narzędzia, które pokazują „pozycję w ChatGPT” jako jedną liczbę, wprowadzają w błąd. Odpowiedzi AI są losowe z natury, więc rzetelny pomiar wymaga wielu powtórzeń i patrzenia na udział marki, a nie na pojedyncze miejsce.

Z rynku

Badanie SparkToro i Gumshoe.ai, w którym prompty o rekomendacje marek uruchamiano po 60–100 razy w ChatGPT, Claude i AI Overviews, pokazało, że szansa na otrzymanie dwa razy tej samej listy marek wynosi mniej niż 1 na 100. Dlatego w moim audycie każde pytanie mierzę wielokrotnie i raportuję udział w odpowiedziach.

Źródła: Search Engine Land: rekomendacje AI powtarzają się rzadziej niż w 1% przypadków

Dla kogo jest ta usługa

  • Firmy, które chcą wiedzieć, czy i jak AI poleca ich markę, zanim zaczną inwestować w GEO.
  • Zarządy i działy marketingu, które potrzebują danych zamiast przeczuć o AI search.
  • Marki, o których asystenci AI podają nieaktualne lub błędne informacje.
  • Agencje i firmy porównujące swoją widoczność w AI z konkurencją.

Co dokładnie dostajesz

  • Zestaw pytań klientów w podziale na intencje: rekomendacje, porównania, problemy, marka.
  • Pomiar w ChatGPT, Gemini, Perplexity, Copilot i Google AI Mode.
  • Analizę: kto jest polecany, w jakiej kolejności, z jakim sentymentem i na podstawie jakich źródeł.
  • Listę błędów i luk w wiedzy modeli o Twojej firmie.
  • Raport z planem działań uszeregowanym według wpływu.

Jak mierzę efekty

  • Udział marki w odpowiedziach w podziale na asystentów i typy pytań.
  • Pozycja marki w odpowiedziach względem konkurencji.
  • Domeny najczęściej cytowane w Twojej kategorii.
  • Liczba błędów faktograficznych w odpowiedziach o marce.

Dlaczego warto?

Raport z 100+ testami zapytań w ChatGPT, Gemini, Claude i Perplexity — kompletna mapa jak AI postrzega Twoją markę dzisiaj.

Analiza porównawcza z top 5 konkurentami — kto jest cytowany częściej niż Ty, jakich treści i sygnałów używają do osiągnięcia tej pozycji.

Identyfikacja błędnych lub przestarzałych informacji o Twojej firmie w odpowiedziach LLM i rekomendacja jak je skorygować.

Mapa luk GEO: tematy branżowe, w których Twoja marka powinna być cytowanym autorytetem, ale nie jest — gotowa lista content opportunities.

Priorytetyzowany plan działań z estymacją trudności i potencjalnego wpływu każdego działania na widoczność w AI.

Jak to działa?

1

Projektowanie zestawu testowych zapytań

Tworzę zestaw 100+ zapytań obejmujący zapytania brandowe (nazwa firmy), kategoryczne (branża, usługi), informacyjne i porównawcze, dostosowany do Twojego rynku.

2

Testowanie w głównych LLM

Systematycznie testuję wszystkie zapytania w ChatGPT, Gemini, Claude, Perplexity i Copilot, dokumentuję każdą odpowiedź i częstotliwość wymieniania Twojej marki.

3

Analiza i benchmarking

Analizuję wyniki w porównaniu do konkurentów, identyfikuję wzorce w treściach i sygnałach które powodują częstsze cytowanie, dokumentuję błędy faktyczne w opisach.

4

Raport i plan działań

Dostarczam szczegółowy raport PDF z wynikami, analizą przyczyn i priorytetyzowaną listą działań GEO z estymacją ROI dla każdej rekomendacji.

Audyt widoczności w AI vs klasyczny audyt SEO vs brak audytu

KryteriumAudyt widoczności w AI (GEO)Klasyczny audyt SEOBrak audytu
Zakres analizyOdpowiedzi ChatGPT, Gemini, Claude, PerplexityPozycje i czynniki w GoogleBrak
Wykrywanie błędnych danych o marce w LLMTakNieNie
Benchmark z konkurencjąCytowalność w AIPozycje w SERPBrak
Mapa luk treściowych pod AITak — content opportunitiesCzęściowoBrak
Efekt końcowyPriorytetyzowany plan działań GEOLista poprawek technicznych SEOBrak wiedzy o stanie
Rekomendowana częstotliwośćKwartalnieKwartalnie/półrocznieBrak
Najlepszy dlaFirm chcących poznać swój obraz w AIFirm skupionych na GoogleFirm bez strategii widoczności

Najczęstsze błędy

  • Wnioski z pojedynczego zapytania wpisanego raz w ChatGPT.
  • Mierzenie tylko pytań z nazwą marki zamiast pytań, w których klient szuka rozwiązania.
  • Pominięcie Google AI Overviews i AI Mode, choć to dla wielu firm największe źródło odpowiedzi AI.
  • Brak porównania z konkurencją — sam wynik marki niewiele mówi.

Kiedy ta usługa nie ma sensu

  • Masz dopiero pomysł na firmę i nie ma jeszcze o niej informacji w sieci.
  • Nie planujesz żadnych działań po audycie — raport bez wdrożeń niewiele zmieni.
  • Działasz w kategorii, w której klienci w ogóle nie korzystają z AI przy wyborze.
/// PORADNIK

Audyt widoczności w AI – jak go przeprowadzam krok po kroku

Audyt widoczności w AI odpowiada na pytanie, czy asystenci tacy jak ChatGPT, Gemini, Perplexity, Copilot i Google AI Mode polecają Twoją markę, jak ją opisują i na podstawie jakich źródeł. Poniżej pokazuję, jak projektuję pomiar, żeby wynik był wiarygodny, jak oceniam odpowiedzi i błędy o marce, co sprawdzam technicznie i jak wygląda raport. Na końcu znajdziesz mini-audyt, który zrobisz sam w godzinę.

Co obejmuje audyt widoczności w AI – cztery warstwy

Rzetelny audyt GEO sprawdza cztery warstwy: co asystenci odpowiadają, na jakich źródłach się opierają, czy fakty o marce są prawdziwe i czy roboty wyszukiwarek AI w ogóle mają dostęp do Twojej strony. Sam pomiar odpowiedzi bez pozostałych warstw mówi, że jest problem, ale nie mówi, skąd się bierze.

WarstwaPytanie, na które odpowiadaCo konkretnie sprawdzam
OdpowiedziCzy i jak często AI wymienia markę?Udział w odpowiedziach, miejsce na liście, rola marki (polecana, wymieniona, odradzana), sentyment, konkurenci
ŹródłaNa czym model opiera odpowiedź?Cytowane domeny i adresy URL w podziale na asystentów i typy pytań, obecność marki na tych stronach
Fakty o marceCzy AI mówi o Tobie prawdę?Oferta, ceny, lokalizacje, właściciele, historia, pomylenia z innymi firmami, nieaktualne dane
Dostępność technicznaCzy asystent może przeczytać Twoją stronę?Roboty w robots.txt i w firewallu, indeks Binga i Google, treść bez JavaScriptu, dane z Bing Webmaster Tools i GA4

Każde zalecenie w raporcie wynika z jednej z tych warstw, więc od razu wiadomo, czy poprawka dotyczy treści, źródeł zewnętrznych, encji marki czy techniki. Szerszy kontekst, czyli jak asystenci wybierają źródła i czym GEO różni się od SEO, opisuję w przewodniku GEO – pozycjonowanie w AI.

Jak projektuję zestaw pytań do audytu

Zestaw pytań decyduje o wartości całego audytu: jeśli zawiera głównie pytania z nazwą marki, wynik będzie zawyżony i bezużyteczny. Większość pytań układam tak, jak klient pyta, zanim w ogóle zna Twoją firmę.

Proporcje, których się trzymam

  • Około dwie trzecie pytań bez nazwy marki – rekomendacje („jaką firmę wybrać do…”), porównania kategorii, problemy i koszty. To tu zapada decyzja, kogo klient w ogóle rozważy.
  • Pytania z nazwą marki – „co sądzisz o X”, „X czy Y”, „ile kosztuje usługa w X”. Służą głównie do wyłapania błędów i sentymentu.
  • Pytania kontrolne – kilka pytań, w których marka nie ma szans się pojawić. Przydają się przy kolejnych pomiarach, żeby odróżnić zmianę modelu od efektu działań.

Jak formułuję pytania

  • Piszę je językiem klienta, z kontekstem, który ludzie naprawdę dodają: miasto, budżet, wielkość firmy, branża, ograniczenia. Rozmowy z AI są dłuższe niż frazy wpisywane w Google.
  • Unikam pytań sugerujących odpowiedź. „Czy X to dobra firma?” prawie zawsze da odpowiedź pozytywną, więc nie mówi nic o realnej widoczności.
  • Zadaję pytania w języku, w którym szukają klienci. Dla polskiej firmy to zwykle polski, ale w B2B i branżach technicznych dokładam wersje angielskie, bo część decydentów pyta AI po angielsku.
  • Ustalam z Tobą listę 3–6 konkurentów, których obecność też liczę. Często dopisuję jednego lub dwóch, których AI poleca, a których nie traktowałeś jako konkurencji.
IntencjaPrzykład pytania (biuro rachunkowe)Co mierzę
RekomendacjaJakie biuro rachunkowe w Poznaniu polecasz dla spółki z o.o. z kilkunastoma pracownikami?Czy marka jest na liście, na którym miejscu, z jakim uzasadnieniem
PorównanieLepiej wziąć biuro rachunkowe czy księgową na etat przy 30 fakturach miesięcznie?Czy cytowana jest Twoja treść, czy treść konkurencji
KosztIle kosztuje pełna księgowość spółki z o.o. w 2026 roku?Czy model podaje Twoje ceny i czy są aktualne
ProblemJak przejść na KSeF, jeśli faktury wystawiam w Excelu?Czy marka pada jako ekspert, czy wygrywają portale
MarkaCo wiesz o biurze rachunkowym [nazwa]? Jakie ma opinie?Poprawność faktów, sentyment, źródła opinii

Przykład jest poglądowy, ale pokazuje zasadę: każde pytanie ma przypisaną intencję i to, co z niego odczytuję. Więcej o szukaniu takich pytań, także tych, których nie pokaże żadne narzędzie do słów kluczowych, piszę we wpisie o analizie słów kluczowych pod AI.

Warunki pomiaru – dlaczego te same pytania dają różne wyniki

Odpowiedź asystenta zależy nie tylko od pytania, ale też od modelu, włączonego wyszukiwania, lokalizacji, języka, historii konta i daty. Jeśli tych warunków nie kontrolujesz, porównujesz przypadkowe zrzuty ekranu, a nie widoczność marki.

ZmiennaJak wpływa na odpowiedźJak ją kontroluję
Model i jego wersjaRóżne modele i wersje mają inną wiedzę i inaczej korzystają z wyszukiwaniaZapisuję model i datę przy każdej odpowiedzi; porównuję tylko pomiary z tymi samymi ustawieniami
Wyszukiwanie na żywoZ wyszukiwaniem model cytuje bieżące strony, bez niego odpowiada z wiedzy treningowejMierzę oba tryby osobno, bo prowadzą do innych działań
LokalizacjaPytania lokalne i „w pobliżu” zależą od miejsca, z którego pada pytanieUstawiam lokalizację rynku docelowego, a przy kilku miastach mierzę je osobno
Personalizacja i pamięćHistoria rozmów i zapisane preferencje zmieniają odpowiedzi konkretnego użytkownikaMierzę w czystych sesjach bez pamięci i personalizacji, np. w ChatGPT w czacie tymczasowym bez personalizacji
LosowośćTo samo pytanie zadane dwa razy daje inną listę marekPowtarzam każde pytanie wielokrotnie i raportuję udział, nie pojedynczy wynik
InterfejsAplikacja, API i wyszukiwarka mogą odpowiadać inaczejWiększość pomiaru robię automatycznie, a próbkę odpowiedzi porównuję z tym, co widzi użytkownik w aplikacji

OpenAI opisuje w pomocy ChatGPT, że czat tymczasowy domyślnie nie korzysta z pamięci ani instrukcji niestandardowych, chyba że użytkownik wybierze wersję spersonalizowaną. To dobry punkt wyjścia do ręcznych testów, ale pamiętaj, że Twoi klienci zwykle pytają z własnych, spersonalizowanych kont. Dlatego wynik audytu traktuję jako obraz „przeciętnego” użytkownika, a nie dokładne odwzorowanie każdej rozmowy.

Ile powtórzeń wystarczy – trochę statystyki

Kilka powtórzeń pozwala odróżnić markę, która pojawia się często, od takiej, która pojawia się rzadko, ale nie pozwala precyzyjnie zmierzyć udziału w odpowiedziach. Precyzję daje dopiero suma wielu odpowiedzi na wiele pytań.

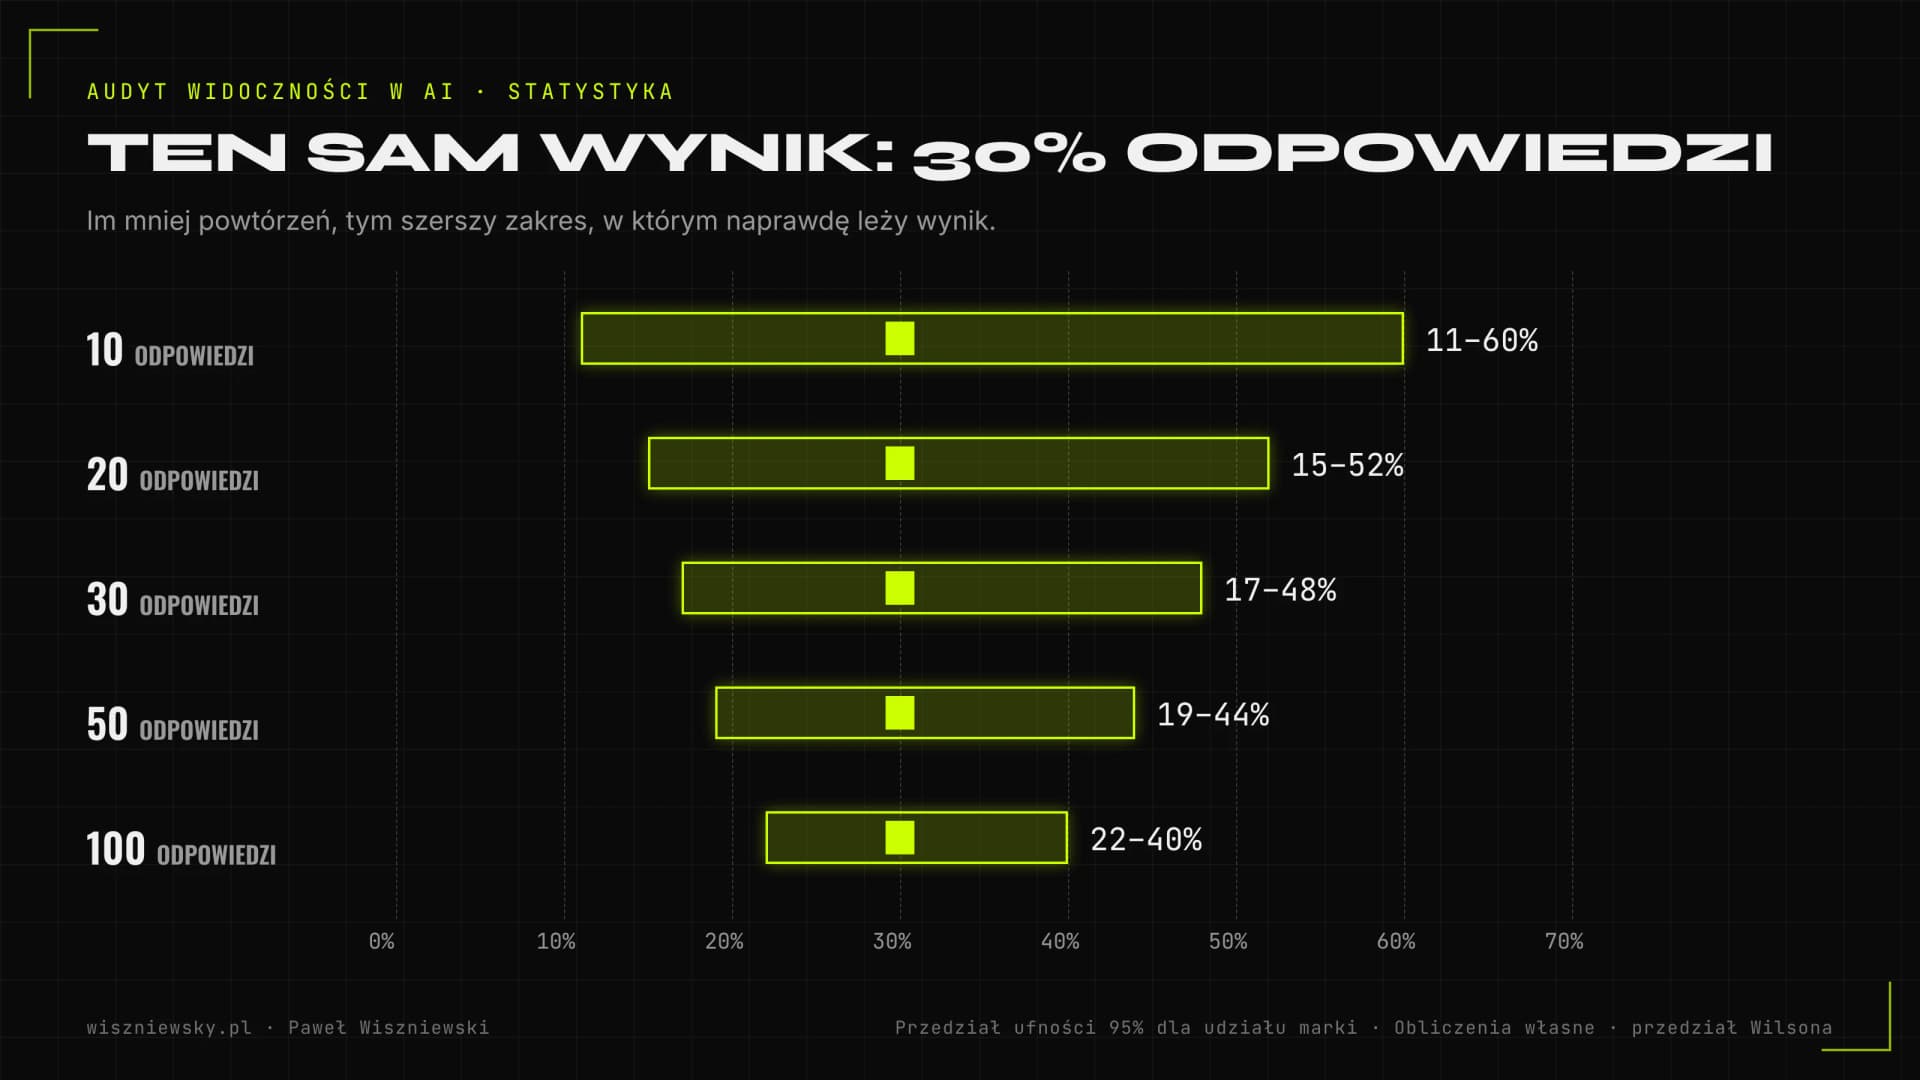
Udział marki w odpowiedziach to proporcja, więc można policzyć jego przedział ufności. Przykład: marka pojawia się w 30% odpowiedzi. Przy 10 odpowiedziach 95-procentowy przedział ufności (metoda Wilsona) to mniej więcej od 11% do 60%, przy 30 odpowiedziach od 17% do 48%, przy 100 od 22% do 40%. Innymi słowy: przy 10 powtórzeniach wynik „30%” równie dobrze może oznaczać 15%, jak 50%.

Wykres: 95-procentowy przedział ufności dla udziału marki 30% przy 10, 20, 30, 50 i 100 odpowiedziach; przedział zwęża się z 11–60% do 22–40%.
Ten sam wynik „30% odpowiedzi” przy różnej liczbie powtórzeń. Obliczenia własne, przedział Wilsona, poziom ufności 95%.

Co z tego wynika dla audytu

  • Przy pojedynczym pytaniu 5–10 powtórzeń w każdym asystencie wystarcza, żeby zaklasyfikować wynik jako „nigdy”, „czasem” lub „prawie zawsze”. Nie raportuję wtedy procentów z dokładnością do jednego punktu.
  • Wskaźniki zbiorcze, na przykład udział marki we wszystkich pytaniach rekomendacyjnych w ChatGPT, liczę z setek odpowiedzi, więc są dużo stabilniejsze.
  • Przy porównaniu z konkurencją patrzę, czy przedziały się nakładają. Jeśli tak, nie piszę, że marka „wyprzedza” konkurenta.
  • W kolejnych pomiarach zmiana o kilka punktów procentowych na małej próbie to zwykle szum, a nie efekt działań.

Dlaczego w ogóle trzeba powtarzać, pokazuje badanie SparkToro i Gumshoe.ai omówione w przewodniku na stronie GEO – pozycjonowanie w AI: listy polecanych marek prawie nigdy nie powtarzają się w identycznej formie.

Jak oceniam odpowiedzi – rubryka i kontrola jakości

Każdą odpowiedź oceniam według tej samej rubryki, a ocenę wykonuje model językowy (LLM-as-a-judge), którego pracę sprawdzam ręcznie na losowej próbie. Bez stałej rubryki dwie osoby, a nawet ta sama osoba w dwóch różnych dniach, oceniłyby te same odpowiedzi inaczej.

Pola, które wypełniam dla każdej odpowiedzi

  • Obecność marki – tak lub nie, osobno dla każdej marki z listy konkurentów.
  • Miejsce na liście – gdy odpowiedź wymienia kilka firm.
  • Rola – polecana wprost, wymieniona neutralnie, wymieniona z zastrzeżeniem albo odradzana.
  • Uzasadnienie – za co model chwali lub krytykuje markę. To często najlepsza wskazówka, co komunikować.
  • Poprawność faktów – czy dane o marce zgadzają się z arkuszem faktów, który przygotowujemy na starcie.
  • Źródła – cytowane adresy URL i domeny.

Dlaczego sprawdzam sędziego

Zheng i współautorzy w pracy „Judging LLM-as-a-Judge” (NeurIPS 2023) pokazali, że silny model w roli sędziego zgadzał się z ocenami ludzi w ponad 80% przypadków, czyli mniej więcej tak samo często, jak ludzie zgadzają się między sobą. Opisali też typowe skrzywienia: preferowanie odpowiedzi na określonej pozycji, dłuższych odpowiedzi i odpowiedzi własnego modelu. Dlatego sędziemu daję wąskie, zamknięte pytania (czy marka X pada w tekście, czy jest polecana), a nie ogólną ocenę „jak dobrze wypada marka”, i ręcznie weryfikuję losową część ocen. Gdy znajduję rozbieżności, poprawiam rubrykę i oceniam zestaw ponownie.

Błędy o marce w odpowiedziach AI – jak je klasyfikuję i skąd się biorą

Każdy błąd faktograficzny o marce dostaje wagę i hipotezę co do źródła, bo od źródła zależy sposób naprawy. Błąd z cytowanej strony poprawia się inaczej niż błąd, który model „pamięta” z danych treningowych.

WagaPrzykładyDlaczego to ważne
KrytycznyFirma opisana jako zamknięta, nieistniejąca usługa, zła cena lub zły adres, pomylenie z firmą o złej reputacjiBezpośrednio odbiera klientów albo naraża na reklamacje
PoważnyNieaktualna oferta, dawny właściciel, przypisanie cudzych opinii, zła specjalizacjaZniekształca obraz marki przy wyborze dostawcy
DrobnyStara nazwa, nieaktualna liczba pracowników, przybliżona data założeniaRzadko wpływa na decyzję, ale sygnalizuje niespójne dane w sieci

Jak szukam przyczyny

  1. Sprawdzam, czy odpowiedź z błędem cytuje źródło. Jeśli tak, otwieram je i szukam błędnej informacji: często to stary katalog firm, nieaktualny artykuł albo profil, o którym nikt nie pamiętał.
  2. Jeśli źródła nie ma, porównuję odpowiedzi z wyszukiwaniem i bez niego. Błąd tylko bez wyszukiwania wskazuje na dane treningowe i zwykle znika wolniej.
  3. Sprawdzam spójność danych w miejscach, które opisują markę: strona „O firmie”, dane strukturalne, profil firmy w Google, rejestry, LinkedIn, Wikidata.
  4. Przy pomyleniu z inną firmą szukam, co łączy obie encje: podobna nazwa, ta sama ulica, wspólna domena w przeszłości.

Naprawa błędów to najczęściej praca nad encją marki, czyli zakres inżynierii grafu wiedzy. Co zrobić krok po kroku, gdy ChatGPT mówi o firmie nieprawdę, opisuję we wpisie o reputacji marki w AI.

Analiza źródeł – która część raportu daje najwięcej

Lista domen cytowanych w Twojej kategorii zwykle okazuje się najbardziej praktyczną częścią audytu, bo wprost pokazuje, gdzie warto być. W raporcie zestawiam ją dla wszystkich pytań naraz i osobno dla każdego asystenta.

  • Ranking domen – które serwisy są cytowane najczęściej i przy jakich typach pytań.
  • Podział na kategorie – Twoja strona, strony konkurencji, media i rankingi, społeczności, bazy wiedzy, katalogi.
  • Lista „cytowane, a bez Ciebie” – konkretne adresy URL, które asystenci cytują przy pytaniach rekomendacyjnych, na których są Twoi konkurenci, a nie ma Twojej marki. To gotowa lista celów dla digital PR.
  • Twoje cytowane adresy – które podstrony już pracują jako źródło i przy jakich pytaniach. Często to nie te strony, które firma uważa za najważniejsze.

Każda platforma ma inne ulubione źródła, dlatego lista dla ChatGPT nie zastąpi listy dla Perplexity czy Google AI Overviews. Jak przekładam taką listę na plan działań poza stroną, opisuję przy usłudze strategii cytowań i pozycjonowania w ChatGPT.

Techniczna część audytu – czy asystenci mogą Cię przeczytać

Zanim zaczniesz poprawiać treści, trzeba wykluczyć najprostszą przyczynę braku cytowań: robot wyszukiwarki AI nie może pobrać strony albo nie ma jej w indeksie, z którego korzysta asystent. W audycie sprawdzam to w kilku miejscach, bo jedno źródło danych często nie wystarcza.

  • robots.txt – czy wpuszczasz roboty wyszukiwania (OAI-SearchBot, PerplexityBot, Claude-SearchBot, Bingbot, Googlebot), niezależnie od decyzji o robotach treningowych.
  • Firewall i CDN – czy reguły ochrony przed botami nie blokują tych samych robotów. Cloudflare od lipca 2025 r. domyślnie blokuje znane crawlery AI na nowych domenach (MIT Technology Review), więc poprawny robots.txt nie wystarcza.
  • Logi serwera – które boty faktycznie przychodzą i jakie kody odpowiedzi dostają.
  • Indeks Binga – ChatGPT w testach opierał wyszukiwanie mocno na Bingu, a Copilot działa na nim bezpośrednio. Sprawdzam indeksację w Bing Webmaster Tools.
  • Treść bez JavaScriptu – czy główna treść, ceny i dane kontaktowe są w HTML, a nie dopiero po wyrenderowaniu skryptów.
  • Raport AI Performance w Bing Webmaster Tools – od lutego 2026 r. pokazuje liczbę cytowań Twoich stron w Copilocie i podsumowaniach AI w Bingu, cytowane adresy oraz próbkę zapytań, które do nich doprowadziły.
  • GA4 – czy ruch z asystentów jest wydzielony. ChatGPT dodaje do odesłań parametr utm_source=chatgpt.com, co OpenAI opisuje w FAQ dla wydawców.

Konfigurację robotów omawiam we wpisie crawlery AI i robots.txt, a pomiar ruchu we wpisie jak mierzyć ruch z ChatGPT, Perplexity i AI Mode. Jeśli audyt pokaże problemy w tej warstwie, naprawiam je w ramach usługi pozycjonowania w Perplexity, Copilot i ChatGPT Search.

Co zawiera raport i jak ustalam priorytety

Raport kończy się listą działań uszeregowaną według wpływu, wysiłku i tego, kto może je wykonać. Wyniki pomiaru są tylko uzasadnieniem dla tej listy.

Struktura raportu

  1. Podsumowanie na jedną stronę: najważniejsze liczby, trzy największe problemy i trzy pierwsze działania.
  2. Udział marki w odpowiedziach na tle konkurencji, w podziale na asystentów i intencje, z zaznaczeniem niepewności pomiaru.
  3. Analiza źródeł z listą adresów „cytowane, a bez Ciebie”.
  4. Lista błędów faktograficznych z wagą, przykładami odpowiedzi i hipotezą co do źródła.
  5. Wyniki części technicznej.
  6. Plan działań i surowe dane: pytania, odpowiedzi i oceny, żebyś mógł powtórzyć pomiar u siebie albo z innym wykonawcą.

Jak szereguję działania

Typ działaniaTypowy wpływWysiłekKto wykonuje
Odblokowanie robotów, indeksacja w BinguDuży, jeśli to była przyczynaMałyJa lub Twój zespół IT
Poprawa błędnych danych w profilach i katalogachŚredni do dużego przy błędach krytycznychMały do średniegoTwój zespół z moją listą
Przebudowa kluczowych stron (odpowiedzi wprost, „dla kogo”, ceny)Średni do dużegoŚredniJa lub Twój zespół według specyfikacji
Nowe strony: porównania, koszty, zastosowaniaŚredniŚredni do dużegoJa lub copywriter
Wzmianki w cytowanych serwisach i rankingachDuży przy pytaniach rekomendacyjnychDuży, rozłożony w czasieWspólnie, digital PR
Praca nad encją markiDuży przy błędach i pomyleniachŚredniJa

Mini-audyt widoczności w AI, który zrobisz sam w godzinę

Prosty test na własną rękę nie zastąpi audytu, ale wystarczy, żeby sprawdzić, czy temat w ogóle dotyczy Twojej firmy. Potrzebujesz arkusza kalkulacyjnego i trzech asystentów.

  1. Wypisz 10 pytań: 7 bez nazwy marki (rekomendacje, porównania, koszty) i 3 z nazwą marki.
  2. Wybierz ChatGPT, Google (AI Mode lub AI Overviews) i jednego asystenta, z którego korzystają Twoi klienci, np. Perplexity albo Copilota.
  3. Zadaj każde pytanie trzy razy w każdym asystencie, za każdym razem w nowej, czystej sesji bez historii i personalizacji.
  4. W arkuszu zapisz: czy marka padła, którzy konkurenci padli, jakie domeny były cytowane, czy w opisie marki jest błąd.
  5. Policz, w ilu z 63 odpowiedzi na pytania bez nazwy marki pojawiłeś się Ty, a w ilu każdy z konkurentów.
  6. Zrób listę domen, które pojawiły się w cytowaniach co najmniej trzy razy.

Jak czytać wynik: jeśli konkurenci pojawiają się wyraźnie częściej, a Ciebie prawie nie ma, problem jest realny i warto go zbadać dokładniej. Pamiętaj jednak o ograniczeniach: 9 odpowiedzi na pytanie to za mało, żeby mierzyć zmiany miesiąc do miesiąca, a ręczne zapisywanie łatwo przekłamać. Kolejne kroki samodzielnego pomiaru opisuję we wpisie audyt widoczności w AI – jak zmierzyć AI Share of Voice.

Narzędzie do monitoringu czy audyt – co wybrać

Narzędzie do monitoringu widoczności w AI mierzy regularnie, ale nie mówi, dlaczego wynik jest taki, jaki jest. Audyt mierzy raz, dokładniej, i kończy się diagnozą oraz planem. W praktyce jedno uzupełnia drugie.

KryteriumNarzędzie SaaS do monitoringuAudyt widoczności w AI
CelŚledzenie trendu w czasieDiagnoza i plan działań
Zestaw pytańZwykle wpisujesz go samProjektowany pod Twoją kategorię i intencje klientów
Błędy o marceNajczęściej tylko sentymentLista błędów z wagą i hipotezą źródła
Część technicznaZwykle brakRoboty, firewall, indeks Binga, GA4
InterpretacjaPo Twojej stronieWnioski i priorytety w raporcie
Kiedy ma sensGdy wiesz już, co poprawiasz, i chcesz śledzić efektNa start albo gdy wyniki spadają i nie wiadomo dlaczego

Porównanie popularnych narzędzi (Profound, Peec, Otterly, Semrush) i kiedy warto zbudować własne rozwiązanie znajdziesz we wpisie narzędzia do monitorowania widoczności w AI.

Co dalej po audycie

Audyt ma sens tylko wtedy, gdy po nim coś się zmienia. Wyniki zwykle wskazują jeden lub dwa główne kierunki, a plan działań przypisuje je do konkretnych zadań.

Po wdrożeniu pierwszych zmian powtarzam pomiar na tym samym zestawie pytań i w tych samych warunkach, zwykle po około trzech miesiącach. Tylko wtedy porównanie „przed i po” ma wartość.

Najczęstsze pytania

Czy LLM mają aktualne dane o mojej firmie?

Zależy od trybu. Perplexity i ChatGPT Search (oraz inne asystenty z włączonym wyszukiwaniem) korzystają z aktualnego indeksu web. Sama wiedza modeli, bez wyszukiwania, kończy się na dacie odcięcia treningu (zazwyczaj 6–12 miesięcy wstecz). Audyt pokazuje, co wie każdy z modeli osobno.

Co mogę zrobić jeśli LLM mówią o mnie nieprawdziwe rzeczy?

Bezpośrednia korekta danych w LLM nie jest możliwa — ale można to naprawić przez zewnętrzne źródła. Aktualizacja wpisów w Wikidata, Wikipedia (jeśli kwalifikujesz), mediach branżowych i własnych treściach wpływa na następne cykle treningowe i RAG.

Jak często powinienem powtarzać audyt?

Rekomenduję audyt co kwartał — modele są aktualizowane, a nowe wersje mają inną wiedzę i zachowania. Dla firm aktywnie budujących GEO, comiesięczny monitoring jest standardem.

Jak sprawdzić jak AI widzi moją markę i co mówi o niej ChatGPT?

Audyt widoczności w AI polega na systematycznym testowaniu zestawu zapytań brandowych i branżowych w ChatGPT, Gemini, Claude i Perplexity. Analiza obecności marki w LLM obejmuje: jak model opisuje firmę, jakie produkty/usługi wymienia, czy informacje są aktualne i czy marka jest cytowana przy pytaniach kategorycznych. Audyt GEO strony dostarcza mapę stanu obecnego i plan działań naprawczych.

Co dokładnie dostanę w raporcie?

Wyniki dla zestawu pytań klientów w kilku asystentach AI: kto jest polecany, w jakiej kolejności, z jakim sentymentem, które domeny są cytowane, jakie błędy pojawiają się w opisie Twojej marki oraz plan działań uszeregowany według wpływu.

Jak długo trwa audyt widoczności w AI?

Zwykle kilka tygodni: ustalenie zestawu pytań, pomiar z powtórzeniami, analiza i przygotowanie rekomendacji. Termin zależy od liczby pytań i asystentów objętych pomiarem.

Ile kosztuje audyt widoczności w AI?

Audyt zaczyna się od 1 500 zł. Cena zależy od liczby pytań, asystentów i konkurentów objętych porównaniem.

/// KNOWLEDGE_BASE

Z bloga

AI & SEO

Audyt widoczności w AI - jak zmierzyć, czy ChatGPT poleca Twoją markę (AI Share of Voice)

Czy ChatGPT, Perplexity i AI Overviews polecają Twoją markę, czy konkurencję? Oficjalne raporty Google i Bing z 2026, jak zbudować zestaw pytań, pomiar na trzech poziomach ze skryptem, jak liczyć i czytać AI Share of Voice oraz audyt w jeden dzień.

12 min
AI & SEO

Narzędzia do monitorowania widoczności w AI - Profound, Peec, Otterly, Semrush czy własne rozwiązanie (porównanie)

Rynek narzędzi do monitoringu widoczności w AI zebrał ponad 300 mln dolarów finansowania w rok, a rozstrzał cen sięga od 29 do 499+ dolarów miesięcznie - przy czym różnice metodologiczne są większe niż cenowe: część narzędzi odpytuje modele syntetycznymi promptami, część opiera się na realnych zapytaniach. Porównuję Profound, Peec, Otterly, Semrush AI Toolkit, Ahrefs Brand Radar i spółkę, pokazuję darmową warstwę zerową (GSC, Bing) - i liczę, kiedy opłaca się zbudować własny monitoring na wzorcu LLM-as-a-judge, który znam od środka, bo takim narzędziem jest mój AnswerLyzer.

15 min
AI & SEO

Jak mierzyć ruch z ChatGPT, Perplexity i AI Mode - GA4 i logi serwera w praktyce

Ruch z AI konwertuje nawet ~4,4× lepiej niż klasyczny organik, a do sklepów urósł o ponad tysiąc procent - ale domyślny GA4 skutecznie go ukrywa: część ląduje w referralach, część w direct, a wejścia z AI Overviews są nierozróżnialne od zwykłego Google. Kompletny warsztat pomiaru: grupa kanałów AI w GA4 z gotowym regexem, ciemny ruch AI, sygnatura AI Overviews w GSC i logi serwera jako druga połowa obrazu.

13 min

Masz projekt?

Przerwij
Ciszę

Zainicjuj protokół. Nawiąż połączenie. Zbudujmy coś głośnego.

> OCZEKIWANIE_NA_SYGNAŁ...