Kompleksowy audyt techniczny SEO + naprawa Core Web Vitals (LCP, CLS, INP) w kodzie. Celem są dobre dane z rzeczywistych wizyt (CrUX, 28-dniowe okno), a nie sam wynik Lighthouse.
›Pełny audyt 100+ punktów kontrolnych obejmujący Core Web Vitals, crawlability, renderowanie JS, duplikaty treści, strukturę URL i linki wewnętrzne.
›Naprawa LCP, CLS i INP na poziomie kodu
›Audyt indeksowania w Google Search Console
Cena: od 2 400 zł
SZCZEGÓŁY USŁUGI
Przeprowadzam głęboki audyt techniczny SEO Twojej strony — od Core Web Vitals przez crawlability, renderowanie JavaScript, po strukturę URL i hreflang. Identyfikuję dokładne przyczyny problemów z Lighthouse i Search Console, a następnie naprawiam je na poziomie kodu. Wynikiem jest strona szybka jak błyskawica, w pełni indeksowalna i gotowa na ranking.
› INVESTMENT:
od 2 400 zł
constmodule = newExecutionProtocol();
// Initializing audyt-i-core-web-vitals... › Loading dependencies... OK › Establishing connection... OK › Ready for deployment... AWAITING_COMMAND
Paweł Wiszniewski · moje podejście
Co robię inaczej
Większość audytów kończy się PDF-em z listą błędów z Screaming Froga, który ląduje w szufladzie, bo nikt nie wie, jak to wdrożyć. Ja jestem jednocześnie specjalistą SEO i programistą Next.js, więc każdy problem diagnozuję w kodzie i od razu wiem, ile kosztuje poprawka. Raport dostajesz uszeregowany według stosunku wpływu do nakładu pracy, a nie według liczby ostrzeżeń w narzędziu. Ten serwis ma automatyczny test SEO uruchamiany przy każdej zmianie kodu: sprawdza H1, canonical, hreflang, dane strukturalne i martwe linki. Taki sam mechanizm mogę wdrożyć u Ciebie, żeby raz naprawione błędy nie wracały.
Uważam, że wynik 100/100 w Lighthouse to najdroższa próżność w SEO. Google ocenia dane z prawdziwych wizyt, a klienci kupują na wolnych telefonach przez słaby zasięg, nie na laptopie programisty. Wolę stronę z wynikiem 85 i szybkim LCP na kartach produktów niż idealny wynik strony głównej.
Z rynku
Vodafone przeprowadził test A/B dwóch identycznych landing page'y, które różniły się tylko optymalizacją Web Vitals. Wersja z LCP lepszym o 31% przyniosła 8% więcej sprzedaży. Z kolei badanie Deloitte pokazało, że przyspieszenie strony mobilnej o 0,1 sekundy zwiększało konwersję w retailu o 8,4%. Szybkość to nie metryka dla SEO-wców, tylko pieniądze.
Firmy, których ruch z Google spada lub stoi w miejscu mimo publikowania treści.
Strony z czerwonymi lub żółtymi Core Web Vitals w Search Console.
Serwisy na React, Next.js lub innych frameworkach JavaScript, które nie są pewne indeksacji.
Firmy przed redesignem lub migracją, które chcą znać stan wyjściowy.
Co dokładnie dostajesz
Raport z audytu ponad 100 punktów: indeksacja, renderowanie, architektura, linkowanie, duplikaty.
Diagnozę LCP, INP i CLS na poziomie kodu, a nie tylko wynik z narzędzia.
Listę poprawek uszeregowaną według wpływu na ruch i nakładu pracy.
Wdrożenie poprawek w kodzie albo precyzyjne instrukcje dla Twojego zespołu.
Weryfikację efektów w Search Console i monitoring po wdrożeniu.
Jak mierzę efekty
Core Web Vitals z danych CrUX dla kluczowych typów stron.
Liczba zaindeksowanych stron i błędów w raporcie Indeksowanie.
Ruch organiczny i wyświetlenia w Search Console.
Pozycje na frazy priorytetowe.
Dlaczego warto?
Pełny audyt 100+ punktów kontrolnych obejmujący Core Web Vitals, crawlability, renderowanie JS, duplikaty treści, strukturę URL i linki wewnętrzne.
Naprawa LCP, CLS i INP na poziomie kodu — nie tylko raport z problemami, ale faktyczna implementacja poprawek z mierzalnym wpływem na dane terenowe Core Web Vitals (CrUX), a nie tylko na wynik Lighthouse.
Audyt indeksowania w Google Search Console — identyfikuję strony zablokowane, z błędami 404, przekierowaniami łańcuchowymi i problemami crawl budget.
Analiza renderowania JavaScript — sprawdzam czy Google poprawnie renderuje Twoją aplikację React/Next.js i czy dynamiczne treści są widoczne dla Googlebot.
Pisemny raport priorytetów z estymacją wpływu każdej poprawki na ruch organiczny — wiesz co naprawić najpierw i dlaczego.
Jak to działa?
1
Automatyczny audyt narzędziami
Uruchamiam Screaming Frog, Lighthouse CI, PageSpeed Insights i Google Search Console, zbieram wszystkie błędy techniczne i pobieram dane historyczne ruchu.
2
Ręczna analiza i priorytetyzacja
Analizuję wyniki narzędzi w kontekście Twojego biznesu, priorytyzuję problemy według potencjalnego wpływu na widoczność i ruch, eliminuję false positives.
3
Implementacja poprawek
Wdrażam poprawki bezpośrednio w kodzie lub dostarczam developerowi gotowe instrukcje techniczne dla każdej zmiany — bez niejednoznaczności.
4
Weryfikacja i monitoring
Weryfikuję poprawki w Google Search Console, mierzę efekty w danych terenowych (CrUX w PageSpeed Insights) i konfiguruję monitoring Core Web Vitals z rzeczywistych wizyt.
Najczęstsze błędy
✕Traktowanie wyniku Lighthouse jako celu — Google ocenia dane z rzeczywistych wizyt (CrUX), a nie test laboratoryjny.
✕Naprawianie setek drobnych ostrzeżeń zamiast kilku problemów, które blokują indeksację stron sprzedażowych.
✕Audyt bez sprawdzenia, co Googlebot widzi po wyrenderowaniu JavaScriptu.
✕Brak monitoringu po wdrożeniu — po kolejnym release'ie te same błędy wracają.
Kiedy ta usługa nie ma sensu
—Strona ma kilka podstron i praktycznie zerowy ruch — wtedy lepiej zacząć od treści i wizytówki Google.
—Planujesz pełną przebudowę strony w ciągu najbliższych tygodni — audyt warto zrobić na nowej wersji przed startem.
—Nie masz możliwości wdrażania zmian w kodzie i nie chcesz, żebym robił to ja.
/// PORADNIK
Audyt SEO techniczny i Core Web Vitals – jak go przeprowadzam krok po kroku
Poniżej opisuję, co dokładnie dzieje się w trakcie mojego audytu technicznego: jakie dane zbieram, jak czytam raporty Search Console, jak rozkładam Core Web Vitals na przyczyny w kodzie i jak układam priorytety poprawek. To materiał dla osób, które chcą wiedzieć, za co płacą i jak ocenić każdy audyt, także cudzy. Liczby pochodzą z dokumentacji Google i web.dev, a źródła są na dole.
Zakres audytu technicznego – osiem obszarów, które sprawdzam
Audyt techniczny sprawdza, czy robot może stronę pobrać, wyrenderować, zrozumieć i zaindeksować, oraz czy prawdziwi użytkownicy dostają ją szybko. Ponad 100 punktów kontrolnych grupuję w osiem obszarów, bo przy każdym z nich inne są narzędzia i inne typowe przyczyny problemów.
Obszar
Przykładowe punkty kontrolne
Główne źródło danych
Dostępność i crawl
Kody odpowiedzi, robots.txt, przekierowania i łańcuchy, odpowiedzi 5xx, czas odpowiedzi serwera, statystyki indeksowania
Ta sama treść, linki i dane strukturalne na telefonie co na komputerze, treści ładowane dopiero po interakcji
Crawl z user-agentem smartfona
Dane strukturalne
Poprawność JSON-LD, zgodność z treścią widoczną na stronie, spójność encji (Organization, Person, Product)
Test wyników z elementami rozszerzonymi, walidator Schema.org, crawl
Wersje językowe i crawlery AI
Hreflang i jego wzajemność, robots.txt dla botów AI, treść dostępna bez JavaScriptu
Crawl, robots.txt, logi
Do tego dochodzą limity, o których mało kto pamięta, a które potrafią po cichu odciąć część strony. Google w dokumentacji Googlebota (aktualizacja z lutego 2026 roku) podaje, że robot pobiera pierwsze 2 MB pliku HTML, liczone po rozpakowaniu, a resztę pomija. Plik robots.txt jest czytany do 500 KiB, a pojedyncza mapa witryny może mieć maksymalnie 50 000 adresów lub 50 MB. Przy sklepach z ogromnym HTML-em kategorii albo stronach z dużym, wstrzykniętym w kod stanem aplikacji sprawdzam więc, czy najważniejsza treść i linki nie wypadają poza pierwsze 2 MB.
Jakie dane zbieram przed audytem i dlaczego sam crawl nie wystarcza
Crawler pokazuje, jak strona wygląda dla robota w dniu audytu, a Search Console i analityka pokazują, co z tego wynika dla Google i dla ruchu. Dopiero zestawienie obu źródeł pozwala odróżnić problem, który kosztuje ruch, od ostrzeżenia bez znaczenia.
Search Console: raport Strony (indeksowanie), Statystyki indeksowania, Podstawowe wskaźniki internetowe, Skuteczność z podziałem na katalogi i typy stron, ulepszenia danych strukturalnych, ręczne działania.
GA4: strony docelowe z ruchu organicznego i konwersje, żeby wiedzieć, które szablony zarabiają.
Dwa crawle Screaming Frogiem: jeden z renderowaniem JavaScriptu, drugi bez. Różnice między nimi to lista rzeczy, których nie zobaczy robot bez JS, w tym większość crawlerów AI.
Dane z wizyt (CrUX, PageSpeed Insights) dla kluczowych adresów i całej domeny, osobno dla telefonów i komputerów.
Logi serwera przy dużych serwisach: które adresy Googlebot faktycznie odwiedza, jak często i z jakim kodem odpowiedzi.
Lista szablonów i informacja biznesowa: które typy stron sprzedają, co planujesz zmieniać w najbliższych miesiącach i kto wdraża poprawki.
Lista szablonów jest ważniejsza niż liczba podstron. Błąd w szablonie karty produktu dotyczy wszystkich produktów naraz, więc audyt prowadzę na poziomie szablonów: wybieram reprezentatywne adresy z każdego typu strony i dopiero potem sprawdzam, czy problem występuje w całej grupie.
Diagnoza indeksowania – jak czytam raport Strony w Search Console
Statusy w raporcie Strony same w sobie nie są błędami, tylko objawami, a ten sam status może mieć kilka różnych przyczyn. Dlatego przy każdym statusie sprawdzam, jakie adresy się w nim znalazły, i dopiero wtedy szukam przyczyny w kodzie lub w konfiguracji.
Status w Search Console
Najczęstsza przyczyna, którą znajduję
Co sprawdzam
Strona wykryta – obecnie nie zindeksowana
Za słabe linkowanie wewnętrzne, zbyt wiele adresów niskiej wartości (filtry, parametry), wolny serwer
Głębokość kliknięć, liczba linków do adresu, Statystyki indeksowania, czas odpowiedzi
Strona zeskanowana, ale jeszcze nie zindeksowana
Strona za mało różni się od innych albo jest prawie pusta po pobraniu (treść dopiero po JS)
Wersja bez JavaScriptu, podobieństwo treści do innych podstron
Duplikat, użytkownik nie oznaczył strony kanonicznej
Te same treści pod kilkoma adresami: parametry, wielkość liter, ukośnik na końcu, wersje do druku
Canonical w szablonie, linki wewnętrzne do wariantów, sitemap
Duplikat, wybrana przez Google strona kanoniczna jest inna niż wybrana przez użytkownika
Sprzeczne sygnały: canonical wskazuje A, a linki, sitemap i przekierowania wskazują B
Spójność canonical, sitemap, linków i hreflang
Soft 404
Nieistniejący produkt lub pusta kategoria zwraca kod 200 z komunikatem „brak wyników”
Kody odpowiedzi dla usuniętych i pustych zasobów
Strona wykluczona za pomocą tagu „noindex”
Noindex pozostawiony po stagingu albo dodany warunkowo w JavaScripcie
HTML z serwera, nagłówek X-Robots-Tag, warunki w kodzie
Zaindeksowana, mimo że zablokowana przez plik robots.txt
Robots.txt blokuje pobranie, ale do adresu prowadzą linki, więc trafia do indeksu bez treści
Czy adres ma być w indeksie; jeśli nie, noindex i odblokowanie pobrania
Ostatni wiersz to częsty błąd koncepcyjny: robots.txt steruje pobieraniem, a nie indeksowaniem. Jeśli strona ma zniknąć z wyników, robot musi móc ją pobrać i zobaczyć noindex. Przy statusach z dużą liczbą adresów zawsze sprawdzam też trend. Rosnąca grupa „Strona wykryta – obecnie nie zindeksowana” w serwisie, który publikuje nowe treści, zwykle oznacza, że Google nie widzi powodu, żeby je pobierać, i to jest sygnał do pracy nad linkowaniem wewnętrznym albo nad crawl budgetem przy bardzo dużych serwisach.
Renderowanie JavaScriptu – test, który rozstrzyga najwięcej
Najważniejsze pytanie audytu brzmi: co robot dostaje w pierwszej odpowiedzi serwera, zanim wykona JavaScript. Google renderuje strony, ale w osobnej kolejce, a większość crawlerów AI JavaScriptu nie wykonuje wcale.
Dokumentacja Google o podstawach JavaScript SEO (aktualizacja z marca 2026 roku) opisuje kilka zasad, które w audycie zamieniam na konkretne testy:
Kolejka renderowania. Google kolejkuje do renderowania strony z kodem 200 i pisze, że strona może w niej czekać kilka sekund albo dłużej. Treść widoczna dopiero po renderowaniu trafia do indeksu później niż treść z HTML-u.
Linki tylko jako elementy a z href. Google odkrywa linki wyłącznie z elementów a z atrybutem href. Przyciski z obsługą kliknięcia i nawigacja na zdarzeniach JavaScriptu nie przekazują robotowi żadnych adresów.
Noindex w JavaScripcie. Gdy Google trafi na noindex w HTML-u, może w ogóle pominąć renderowanie, więc usunięcie noindexu skryptem nie zadziała.
Miękkie 404 w aplikacjach SPA. Przy routingu po stronie klienta nieistniejący adres często zwraca 200. Google zaleca wtedy przekierowanie do adresu, który zwraca 404, albo dodanie noindex.
Fragmenty w adresach. Treść ładowana po znaku # nie jest dla Google osobną stroną; potrzebne są normalne adresy obsługiwane przez History API.
Na co patrzę w projektach Next.js i React
W Next.js większość problemów nie wynika z frameworka, tylko z tego, gdzie trafiła treść. Sprawdzam, czy tytuł, opis, canonical i hreflang powstają po stronie serwera, czy kluczowa treść nie siedzi w komponentach klienckich ładowanych po interakcji, czy nieistniejące zasoby zwracają prawdziwy kod 404, czy linki w menu i paginacji są zwykłymi linkami i czy dane strukturalne są w HTML-u, a nie wstrzykiwane po załadowaniu. Szerzej opisuję to w artykule o JavaScript SEO i renderowaniu, a przebudowę architektury, gdy poprawki nie wystarczą, w usłudze migracji do Next.js.
Osobno sprawdzam wersję mobilną. Google indeksuje i ocenia strony na podstawie wersji pobranej smartfonem i w dokumentacji o indeksowaniu mobilnym zaznacza, że nie ładuje treści, które wymagają interakcji, takiej jak przesunięcie, kliknięcie czy wpisanie tekstu. Zakładki „opis / specyfikacja” ładowane dopiero po kliknięciu albo akordeony pobierające treść z API to typowe miejsca, w których treść znika z indeksu.
Core Web Vitals w audycie – od danych z wizyt do konkretnej linijki kodu
Core Web Vitals poprawiam w odwrotnej kolejności niż większość raportów: zaczynam od danych z prawdziwych wizyt, a test laboratoryjny służy mi tylko do odtworzenia i naprawy problemu. Wynik Lighthouse na laptopie programisty nie jest tym, co ocenia Google.
Grupy adresów w Search Console. Raport Podstawowe wskaźniki internetowe łączy adresy o podobnym doświadczeniu użytkownika w grupy, ocenia je na danych z ostatnich 28 dni, a status grupy wyznacza najgorszy z trzech wskaźników. Grupa zwykle odpowiada szablonowi, więc od razu wiem, gdzie szukać.
Dane z CrUX dla konkretnych adresów i całej domeny. Pamiętam o tym, skąd pochodzą: według metodologii CrUX dane zbiera Chrome na komputerach i Androidzie, a Chrome na iOS i inne przeglądarki oparte na Chromium, jak Edge, nie są uwzględniane. Mało popularne adresy w ogóle nie mają danych.
Odtworzenie w laboratorium. Lighthouse i panel Performance w DevTools z ograniczeniem procesora i sieci, na szablonie wskazanym przez dane z wizyt.
Rozbicie wskaźnika na części i wskazanie przyczyny w kodzie, a nie w narzędziu.
LCP – którą część czasu ładowania poprawiać
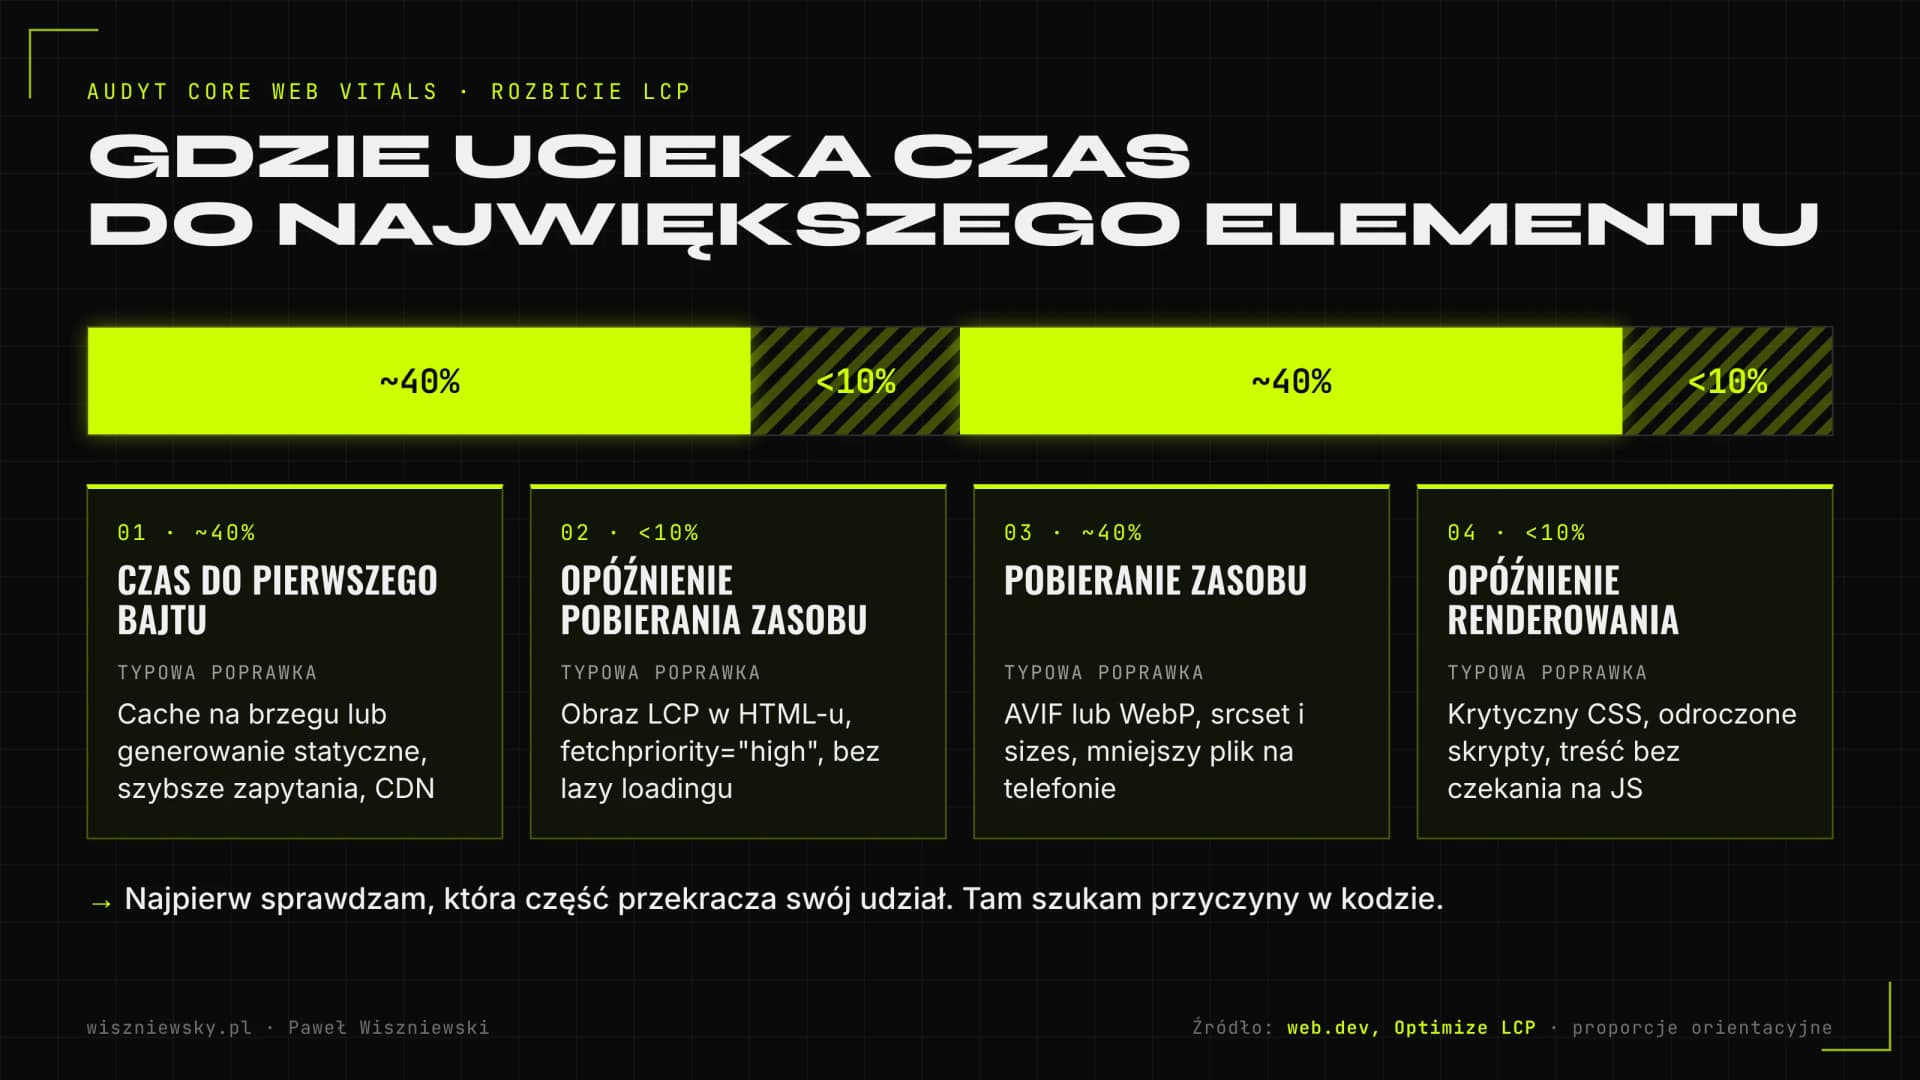
Web.dev w przewodniku po optymalizacji LCP dzieli ten czas na cztery części i podaje orientacyjne proporcje dla dobrze zoptymalizowanej strony: około 40% na czas do pierwszego bajtu (TTFB), poniżej 10% na opóźnienie rozpoczęcia pobierania zasobu, około 40% na samo pobieranie zasobu i poniżej 10% na opóźnienie renderowania elementu. Autorzy zaznaczają, że to wskazówki, a nie sztywne reguły. W praktyce ten podział od razu pokazuje, czy problem leży w serwerze, w kolejności ładowania, w wadze obrazu, czy w JavaScripcie blokującym wyświetlenie.
Rozbicie LCP na części pokazuje, gdzie szukać przyczyny. Proporcje orientacyjne według web.dev.
Część LCP
Typowa przyczyna
Typowa poprawka
Czas do pierwszego bajtu
Renderowanie strony przy każdym żądaniu bez cache, wolne zapytania do bazy, brak CDN
Generowanie statyczne lub cache na brzegu, optymalizacja zapytań, CDN
Opóźnienie pobierania zasobu
Obraz LCP odkrywany dopiero przez CSS lub JavaScript, lazy loading na pierwszym zdjęciu
Obraz w HTML-u, fetchpriority="high" na jednym lub dwóch obrazach, bez lazy loadingu powyżej linii przewijania
Pobieranie zasobu
Zbyt duży plik, zły format, obraz w pełnej rozdzielczości na telefonie
AVIF lub WebP, srcset i sizes, kompresja
Opóźnienie renderowania
CSS i skrypty blokujące, fonty, element ukryty do czasu hydratacji
Krytyczny CSS, odroczenie skryptów, treść widoczna bez czekania na JavaScript
INP – trzy fazy każdej interakcji
Web.dev rozkłada każdą interakcję na opóźnienie wejścia (zanim zacznie działać obsługa zdarzenia), czas przetwarzania (wykonanie obsługi zdarzenia) i opóźnienie prezentacji (do narysowania kolejnej klatki). W audycie nagrywam interakcje na najważniejszych szablonach, na przykład otwarcie filtra, dodanie do koszyka czy rozwinięcie menu, i sprawdzam, która faza dominuje. Długie opóźnienie wejścia oznacza zwykle zajęty wątek główny przez skrypty zewnętrzne. Długie przetwarzanie to ciężka logika w obsłudze kliknięcia, którą trzeba podzielić i oddawać sterowanie przeglądarce, jak zaleca web.dev. Długa prezentacja to zbyt duże zmiany w DOM po jednym kliknięciu.
CLS – przesunięcia, które da się przewidzieć
Najczęstsze przyczyny wymienione przez web.dev to obrazy bez wymiarów, reklamy, osadzenia i ramki bez zarezerwowanego miejsca, treść wstrzykiwana dynamicznie oraz fonty. Web.dev zwraca też uwagę na mechanizm back/forward cache: strona przywrócona z pamięci przeglądarki po cofnięciu nie generuje ponownie przesunięć, więc sprawdzam, czy coś (na przykład nasłuchiwanie zdarzenia unload albo nagłówki cache) nie wyklucza z niego strony. Progi wszystkich trzech wskaźników i ich wpływ na ranking opisuję na stronie pozycjonowania stron, a pełne techniki optymalizacji w przewodniku po Core Web Vitals.
Jak układam priorytety poprawek i jak wygląda jedna rekomendacja
Kolejność poprawek ustalam na podstawie tego, ile ruchu lub przychodu zależy od problemu, ile kosztuje poprawka i jakie niesie ryzyko, a nie według liczby ostrzeżeń w narzędziu. Sto przypadków brakującego atrybutu alt na stronach regulaminów ma mniejsze znaczenie niż jeden błąd canonical w szablonie kategorii.
Priorytet
Kiedy go nadaję
Przykład
P0 – natychmiast
Problem blokuje indeksowanie lub pobieranie stron, które zarabiają
Noindex na kategoriach, robots.txt blokujący katalog z produktami, błędy 5xx
P1 – w pierwszym sprincie
Problem dotyczy całego szablonu z ruchem i ma prostą poprawkę
Canonical wskazujący stronę główną, treść karty produktu dopiero po JavaScripcie
P2 – zaplanować
Wyraźny wpływ, ale wymaga większych zmian w kodzie lub treści
INP na listingu z filtrami, przebudowa linkowania wewnętrznego
P3 – przy okazji
Mały wpływ lub dotyczy stron bez ruchu
Brakujące opisy obrazów w archiwum bloga, drobne łańcuchy przekierowań
Każda rekomendacja w raporcie ma ten sam układ, żeby dało się ją od razu przenieść do systemu zadań zespołu:
Problem i dowód: przykładowe adresy, zrzut z Search Console lub wynik crawla.
Przyczyna: w którym szablonie, komponencie lub regule serwera powstaje błąd.
Poprawka: co zmienić, z fragmentem kodu lub konfiguracji, jeśli to możliwe.
Kryterium akceptacji: jak sprawdzić, że poprawka działa, na przykład „adres X zwraca 404”, „canonical w HTML-u z serwera wskazuje sam siebie”.
Weryfikacja w Google: który raport obserwować i w jakim czasie spodziewać się zmiany.
Kryterium akceptacji jest najważniejsze, bo pozwala zespołowi samodzielnie zamknąć zadanie, a mnie zweryfikować je bez dodatkowych spotkań. Gdy wdrażam poprawki sam, ten sam format służy jako dziennik zmian.
Weryfikacja po wdrożeniu i ochrona przed powrotem błędów
Audyt kończy się dopiero wtedy, gdy Google potwierdzi poprawki w swoich raportach, a błędy nie wracają przy kolejnych wdrożeniach. Dlatego weryfikacja ma u mnie trzy poziomy.
Natychmiast: narzędzie Sprawdzanie adresu URL i test na żywo dla przykładowych adresów z każdego szablonu, ponowny crawl i porównanie z crawlem sprzed zmian.
W ciągu kilku tygodni: walidacja poprawek w Search Console. Dla Core Web Vitals walidacja to 28-dniowa sesja monitorowania; problem uznaje się za rozwiązany, jeśli w tym czasie nie wystąpi na żadnym adresie z grupy.
Na stałe: automatyczny test SEO w procesie wdrażania i pomiar Core Web Vitals z prawdziwych wizyt.
Na tej stronie przed każdą publikacją zmian uruchamia się test, który sprawdza między innymi jeden nagłówek H1, unikalne tytuły i opisy, canonical wskazujący sam siebie, wzajemne hreflang, poprawność JSON-LD, martwe linki wewnętrzne i strony osierocone. Ten sam mechanizm wdrażam klientom, dopasowany do ich szablonów. Do tego dokładam budżety wydajności w Lighthouse CI dla kluczowych szablonów i zbieranie Core Web Vitals z wizyt z atrybucją, czyli informacją, który element lub skrypt odpowiada za wynik. Dzięki temu po wdrożeniu widać, który release pogorszył INP, zanim pokaże to Search Console z opóźnieniem 28 dni.
Audyt SEO strony na WordPressie, w sklepie i na Next.js – czym się różni
Lista kontrolna jest wspólna, ale miejsca, w których znajduję problemy, zależą od platformy. Na starcie audytu sprawdzam więc najpierw typowe słabe punkty danej technologii.
Platforma
Gdzie najczęściej szukam problemów
WordPress
Archiwa tagów, autorów i dat tworzące cienkie duplikaty, konflikty wtyczek SEO i cache, ciężkie motywy i kreatory stron psujące LCP i INP, skrypty wtyczek ładowane na każdej podstronie
WooCommerce, PrestaShop i inne sklepy
Filtry i sortowanie generujące tysiące adresów, paginacja kategorii, warianty produktów, produkty niedostępne i usunięte (kody 404, 410 lub przekierowania), dane strukturalne Product i ofert
Shopify
Te same produkty dostępne pod adresami w ramach kolekcji, ograniczona kontrola nad strukturą adresów i robots.txt, aplikacje doładowujące skrypty i pogarszające INP
Next.js i React
Treść w komponentach klienckich, metadane i hreflang generowane po stronie klienta, kody 404 i przekierowania w routingu, obrazy i fonty, rozmiar JavaScriptu na szablonach
Serwisy wielojęzyczne
Wzajemność hreflang, canonical między wersjami językowymi, automatyczne przekierowania po języku przeglądarki blokujące robota
Przy sklepach audyt łączę zwykle z analizą crawl budgetu, bo filtry i parametry to główny powód marnowania zasobów robota. Przy serwisach wielojęzycznych odsyłam do szczegółów w artykule o hreflang i SEO międzynarodowym. Jeśli w audycie wychodzą problemy z danymi strukturalnymi, ich poprawienie i rozbudowę wykonuję w ramach wdrażania Schema.org.
Co dodaję do audytu w 2026 roku z myślą o crawlerach AI i AI Overviews
Audyt pod odpowiedzi AI nie wymaga osobnych sztuczek, ale wymaga sprawdzenia kilku rzeczy, które w klasycznym audycie łatwo pominąć: treści bez JavaScriptu, dostępu botów AI, ustawień w Search Console i spójności danych o firmie. Google w przewodniku o optymalizacji pod funkcje generatywne (aktualizacja z lipca 2026 roku) pisze, że strona musi być zaindeksowana i kwalifikować się do wyświetlenia z fragmentem, a witryna musi być dodatkowo uwzględniona w generatywnych funkcjach AI w Search Console. Ten sam przewodnik podaje, że wyszukiwarka Google nie korzysta z plików llms.txt.
Treść w HTML-u z serwera. Według analizy Vercel z 2024 roku crawlery takie jak GPTBot czy ClaudeBot nie wykonują JavaScriptu. Strona renderowana tylko w przeglądarce jest dla nich pusta.
Robots.txt i firewall. Sprawdzam, czy reguły w robots.txt odpowiadają temu, co chcesz udostępnić, i czy CDN lub ochrona przed botami nie blokuje po cichu botów wyszukiwarek AI, których nie chcesz blokować. Opis poszczególnych botów jest w artykule o crawlerach AI i robots.txt.
Bing i IndexNow. Część asystentów AI korzysta z indeksu Bing, więc sprawdzam weryfikację w Bing Webmaster Tools i zgłaszanie zmian; szczegóły w artykule o Bing, Copilot i IndexNow.
Ustawienia Search Console. Sprawdzam, czy witryna jest uwzględniona w generatywnych funkcjach AI i czy kluczowe strony nie mają dyrektyw nosnippet lub max-snippet, które wykluczają je z wyświetlania z fragmentem.
Spójność encji. Nazwa firmy, adres, osoby i oferta muszą być takie same w treści, danych strukturalnych i profilach zewnętrznych.
Pomiar tego, czy marka faktycznie pojawia się w odpowiedziach ChatGPT, Perplexity czy AI Overviews, nie jest częścią audytu technicznego. To osobna usługa: audyt widoczności w AI, który można zlecić razem z tym audytem.
Audyt jednorazowy, audyt z wdrożeniem czy stała opieka – jak wybrać
Zakres zależy przede wszystkim od tego, kto ma wdrażać poprawki i jak często zmienia się strona. Cena audytu zaczyna się od 2 400 zł, a różnica między wariantami leży w tym, ile pracy wykonuję w kodzie.
Sytuacja
Co rekomenduję
Masz własny zespół developerski, który ma czas na poprawki
Audyt z raportem i rekomendacjami w formacie zadań, plus weryfikacja po wdrożeniu
Nie masz developera albo jest zajęty innym projektem
Audyt z wdrożeniem poprawek przeze mnie, jeśli mam dostęp do kodu lub CMS-a
Strona jest często rozwijana przez kilka osób lub zespołów
Audyt i wdrożenie automatycznego testu SEO w procesie publikacji, żeby błędy nie wracały
Planujesz przebudowę lub zmianę platformy w ciągu kilku miesięcy
Krótki audyt stanu obecnego jako punkt odniesienia, a pełną pracę przy migracji SEO
Technika jest w porządku, a mimo to przegrywasz z konkurencją
Zamiast kolejnego audytu technicznego analiza treści i autorytetu, w tym link building
Jeśli nie wiesz, który wariant pasuje, zacznij od dostępu do Search Console z prawem odczytu. Po pierwszym przeglądzie danych zwykle da się powiedzieć, czy problem jest techniczny, czy leży gdzie indziej. Więcej o tym, jak automatyzacja i agenci AI przyspieszają audyty, piszę w artykule o automatyzacji SEO.
Poprawa Core Web Vitals jest widoczna w Google Search Console po 28 dniach (cykl zbierania danych przez Google). Efekty rankingowe są zazwyczaj widoczne po 4–8 tygodniach od wdrożenia poprawek.
Czy naprawiasz problemy sam, czy tylko dostarczasz raport?
Zarówno jedno, jak i drugie — zależy od Twojego wyboru. Podstawowy audyt to szczegółowy raport z instrukcjami. W rozszerzonej wersji sam wdrażam poprawki bezpośrednio w kodzie strony.
Czy audyt obejmuje mobilną wersję strony?
Tak. Google stosuje Mobile-First Indexing, więc audyt skupia się przede wszystkim na wydajności i użyteczności mobilnej. Analizuję Core Web Vitals oddzielnie dla desktop i mobile.
Co muszę przygotować do audytu?
Dostęp do Google Search Console i GA4 (rola z prawem odczytu wystarczy), adres strony i informację, które podstrony są dla Ciebie najważniejsze biznesowo. Dostęp do repozytorium lub CMS-a jest potrzebny tylko wtedy, gdy mam wdrażać poprawki.
Czym Twój audyt różni się od raportu z narzędzia typu Semrush czy Screaming Frog?
Narzędzia pokazują symptomy i nie znają Twojego biznesu. Ja sprawdzam przyczyny w kodzie, odrzucam fałszywe alarmy i układam poprawki według wpływu na ruch i sprzedaż. Dostajesz też instrukcje wdrożenia albo gotowe poprawki, a nie tylko listę ostrzeżeń.
Ile kosztuje audyt SEO techniczny?
Audyt zaczyna się od 2 400 zł. Cena zależy od wielkości serwisu, liczby szablonów stron i tego, czy poprawki wdrażam sam, czy przygotowuję je dla Twojego zespołu.