WRÓĆ DO GEO – Pozycjonowanie w AI

Inżynieria Grafu Wiedzy – Entity SEO i Pozycjonowanie Semantyczne Encji

Budowanie encji Twojej marki w Google Knowledge Graph przez Schema.org i sameAs. Modele AI jak ChatGPT i Gemini zaczną rozpoznawać Cię jako autorytet w branży.

Autor: Paweł Wiszniewski · Aktualizacja:

W skrócie

Budowanie encji Twojej marki w Google Knowledge Graph przez Schema.org i sameAs. Modele AI jak ChatGPT i Gemini zaczną rozpoznawać Cię jako autorytet w branży.

  • ›Encja Twojej marki w Google Knowledge Graph
  • ›Powiązania sameAs z Wikidata, LinkedIn, Crunchbase, Google Business Profile
  • ›Schema.org Organization z pełnymi atrybutami: foundingDate, numberOfEmployees, areaServed, knowsAbout

Cena: od 3 000 zł

SZCZEGÓŁY USŁUGI

Buduję i optymalizuję obecność Twojej marki jako encji w Google Knowledge Graph i semantycznej sieci wiedzy. Wdrażam schematy Organization i Person z atrybutem sameAs powiązanym z Wikidata, LinkedIn, Crunchbase i branżowymi bazami danych. Kiedy modele językowe (np. te w ChatGPT i Gemini), trenowane na danych webowych, poszukają informacji o Twojej firmie, znajdą spójną, bogatą sieć encji — i łatwiej zaczną Was cytować.

› INVESTMENT:

od 3 000 zł
const module = new ExecutionProtocol();

// Initializing inzynieria-grafu-wiedzy...
› Loading dependencies... OK
› Establishing connection... OK
› Ready for deployment... AWAITING_COMMAND

Paweł Wiszniewski · moje podejście

Co robię inaczej

Encja marki to dla mnie fundament GEO: jeśli Google i modele AI nie wiedzą jednoznacznie, kim jesteś, żadna optymalizacja treści nie zadziała w pełni. Zaczynam od sprawdzenia, co dziś „wie” o Twojej marce Google (Knowledge Graph API) i co odpowiadają ChatGPT, Gemini i Perplexity, a potem porządkuję źródła, z których te systemy czerpią. Tę samą pracę wykonałem dla siebie: ta strona ma jedną encję autora powiązaną z Wikidata, LinkedInem i GitHubem, a dla marki modowej zbudowałem architekturę encji opisaną w case study.

Case study: Fashion Brand SEO/GEO

Moje zdanie i przykład z rynku

Moje zdanie

Moim zdaniem w erze AI nazwa marki bez encji to tylko ciąg znaków. Model, który nie może jednoznacznie połączyć Twojej nazwy z branżą, lokalizacją i ludźmi, będzie zgadywał — a zgadywanie kończy się pomyleniem z inną firmą.

Z rynku

Google opisał swój Knowledge Graph jako bazę ponad 500 miliardów faktów o 5 miliardach encji (Google, 2020), zbieraną z publicznych stron, otwartych i licencjonowanych baz danych. Jeśli informacji o Twojej marce nie ma w tych źródłach albo są sprzeczne, Google i modele AI nie mają z czego zbudować poprawnego obrazu firmy.

Źródła: Google: About the Knowledge Graph and knowledge panels

Dla kogo jest ta usługa

  • Marki, o których ChatGPT lub Gemini mówią niewiele, ogólnikowo albo z błędami.
  • Firmy i eksperci, którzy chcą mieć panel wiedzy w Google.
  • Marki z niespójnymi danymi w sieci: różne nazwy, adresy, opisy działalności.
  • Firmy po rebrandingu lub fuzji, które chcą, żeby wyszukiwarki połączyły starą i nową markę.

Co dokładnie dostajesz

  • Audyt encji: jak Google i modele AI rozpoznają dziś Twoją markę i osoby kluczowe.
  • Dane strukturalne Organization i Person z kompletnymi atrybutami i powiązaniami sameAs.
  • Rekord w Wikidata i spójne profile w bazach, katalogach i serwisach branżowych.
  • Stronę „O firmie” zaprojektowaną jako główne źródło faktów o marce.
  • Plan wzmianek, które wzmacniają powiązanie marki z kluczowymi tematami.

Jak mierzę efekty

  • Obecność i treść panelu wiedzy w Google.
  • Poprawność odpowiedzi modeli AI na pytania o markę.
  • Spójność danych o firmie w kluczowych źródłach.
  • Widoczność na frazy brandowe i łączące markę z tematem.

Dlaczego warto?

Encja Twojej marki w Google Knowledge Graph — dane strukturalne pomagają Google jednoznacznie zrozumieć, kim jesteś jako organizacja, co porządkuje wyniki dla branded queries (E-E-A-T nie jest bezpośrednim czynnikiem rankingowym).

Powiązania sameAs z Wikidata, LinkedIn, Crunchbase, Google Business Profile — spójność danych we wszystkich głównych bazach wiedzy, z których trenują modele AI.

Schema.org Organization z pełnymi atrybutami: foundingDate, numberOfEmployees, areaServed, knowsAbout — sygnały autentyczności dla Google i LLM.

Wzmocnienie widoczności w Knowledge Panel Google — panel wiedzy z logiem, opisem i linkami do social media dla branded searches na Twoją firmę.

Fundament dla GEO (Generative Engine Optimization) — bez encji w Knowledge Graph Twoja marka jest dla LLM nieznana; z nią staje się cytowanym źródłem w odpowiedziach AI.

Jak to działa?

1

Audyt obecności semantycznej

Sprawdzam czy Twoja marka ma wpis w Wikidata, Google Knowledge Panel i jakie atrybuty Schema.org są już wdrożone na stronie. Identyfikuję luki.

2

Budowanie encji i sameAs

Tworzę lub aktualizuję encję w Wikidata, konfiguruję Schema.org Organization z pełnymi atrybutami i dodaję sameAs powiązania ze wszystkimi istotnymi platformami.

3

Wdrożenie JSON-LD i ponowna indeksacja

Wdrażam schematy JSON-LD na stronie i proszę o ponowne zindeksowanie kluczowych adresów w Google Search Console. Encji nie da się zgłosić do Google — gdy pojawi się panel wiedzy, przejmuję go przez weryfikację i zgłaszam poprawki.

4

Monitorowanie Knowledge Panel

Monitoruję pojawienie się i zawartość Knowledge Panel w Google, weryfikuję, czy LLM (ChatGPT, Gemini) poprawnie opisują Twoją markę, i koryguję błędne informacje u źródeł.

Inżynieria grafu wiedzy (Entity SEO) vs klasyczne SEO vs brak działań

KryteriumInżynieria grafu wiedzy / Entity SEOKlasyczne SEO (słowa kluczowe)Brak działań
Rozpoznanie marki przez LLMWysokie — encja w Knowledge GraphPośrednieBrak — marka nieznana
Zrozumienie marki przez GoogleWysokie — jednoznaczna encja i faktyŚrednieNiskie
Knowledge Panel w GoogleCel bezpośredniRzadko jako efekt ubocznyZwykle brak
Spójność danych (Wikidata, sameAs)Pełna, kontrolowanaPomijanaBrak
Fundament pod GEOTak — warstwa encjiCzęściowoBrak
Horyzont efektówŚrednio- i długoterminowyŚrednioterminowyBrak
Najlepszy dlaMarek budujących cytowalność w AIRuchu z klasycznego wyszukiwaniaFirm bez ambicji widoczności w AI

Najczęstsze błędy

  • Różne nazwy firmy, adresy i opisy działalności w katalogach, social media i na stronie.
  • Tworzenie wpisu w Wikidata bez wiarygodnych źródeł, które go potwierdzają.
  • Linki sameAs do profili, które są puste, nieaktualne lub należą do kogoś innego.
  • Strona „O nas” bez konkretów: daty założenia, ludzi, lokalizacji, specjalizacji.

Kiedy ta usługa nie ma sensu

  • Marka dopiero powstaje i nie ma jeszcze żadnych zewnętrznych wzmianek — najpierw trzeba je zdobyć.
  • Twoja nazwa jest bardzo ogólna lub dzielona z inną dużą marką i nie planujesz rebrandingu.
  • Oczekujesz panelu wiedzy w kilka dni — to proces zależny od Google, nie od jednego wdrożenia.
/// PORADNIK

Inżynieria grafu wiedzy – jak buduję encję marki krok po kroku

Inżynieria grafu wiedzy to uporządkowanie wszystkich faktów o marce tak, żeby Google i modele AI mogły ją jednoznacznie rozpoznać, odróżnić od innych i opisać bez zgadywania. Poniżej pokazuję, co dokładnie sprawdzam w audycie encji, jak wygląda arkusz faktów i graf danych strukturalnych, jak podchodzę do Wikidata i panelu wiedzy oraz jak mierzę postęp. Teorię encji opisuję osobno w artykule Entity SEO i graf wiedzy, tu skupiam się na praktyce wdrożenia.

Audyt encji – co sprawdzam na starcie

Audyt encji odpowiada na jedno pytanie: co Google i modele AI „wiedzą” dziś o Twojej marce i skąd to wiedzą. Zanim cokolwiek zmienię, zbieram obraz z kilku miejsc naraz, bo każde z nich pokazuje inną warstwę tego samego problemu.

ŹródłoJak sprawdzamCo zapisuję
Wyniki na nazwę marki (brand SERP)Wyszukiwanie nazwy, nazwy z miastem i nazwy z branżą, w trybie incognitoCzy jest panel wiedzy, które z 10 wyników należą do marki, czy pojawiają się obce firmy o podobnej nazwie
Knowledge Graph Search APIZapytanie o nazwę marki i osób kluczowychIdentyfikator encji (w formacie kg:/m/ lub kg:/g/), typ, opis, wynik dopasowania; brak wyniku też jest informacją
Wikidata i WikipediaWyszukanie nazwy i jej wariantów, także starych nazwCzy istnieje element, czy są duplikaty, jakie twierdzenia i referencje ma rekord
Profil firmy w Google i mapyWyszukanie wizytówki i porównanie danych ze stronąNazwa, kategoria, adres, godziny, link do strony
Rejestry i bazyKRS lub CEIDG, katalogi branżowe, serwisy z opiniamiNazwa prawna, data rejestracji, adres, opis działalności i rozbieżności
Profile marki i ludziLinkedIn firmy i założycieli, YouTube, inne oficjalne kanałyCzy opis działalności jest ten sam, czy profile są aktywne i wskazują na stronę
Asystenci AIStały zestaw pytań w ChatGPT, Gemini, Perplexity i CopilotCo modele mówią o marce, jakie podają źródła, gdzie się mylą

Do Knowledge Graph Search API podchodzę ostrożnie. Dokumentacja Google opisuje je jako interfejs tylko do odczytu, który zwraca pojedyncze encje bez powiązań między nimi, i zaznacza, że nie nadaje się do zastosowań krytycznych produkcyjnie. Używam go więc jako wskaźnika (czy encja istnieje, jak jest opisana, czy zmienia się w czasie), a nie jako wyroczni.

Pytania, które zadaję asystentom AI

  1. Czym zajmuje się [marka]? (sprawdzam kategorię i opis)
  2. Kto założył [markę] i kto nią kieruje? (sprawdzam osoby)
  3. Gdzie działa [marka] i od kiedy? (lokalizacja, data)
  4. Jakie firmy oferują [usługę] w [mieście lub kraju]? (czy marka pojawia się w rekomendacjach)
  5. [marka] czy [konkurent] – czym się różnią? (z czym model kojarzy markę)

Każde pytanie zadaję kilka razy, bo pojedyncza odpowiedź modelu jest losowa. Szczegóły metody opisuję w audycie widoczności w AI, który często robię razem z tą usługą.

Arkusz faktów marki – jedno źródło prawdy

Arkusz faktów to tabela, w której każdy fakt o marce ma jedną zatwierdzoną wartość, źródło, które go potwierdza, i listę miejsc, gdzie występuje. To najważniejszy produkt audytu, bo wszystkie późniejsze kroki (strona „O firmie”, JSON-LD, Wikidata, profile) kopiują wartości z tego arkusza, a nie z pamięci.

FaktPrzykład wartościPo co
Nazwa kanonicznaJedna forma, zawsze ta sama pisowniaPodstawa rozpoznania encji
Nazwa prawnaPełna nazwa z rejestruŁączy markę z KRS lub CEIDG
Nazwy alternatywneSkrót, stara nazwa, wersja bez polskich znakówPozwala połączyć warianty w jedną encję
Opis w jednym zdaniuKim jesteś, co robisz, dla kogo, gdzieTen sam tekst na stronie, w profilach i w Wikidata
Data założeniaRok lub pełna data z rejestruFakt łatwy do sprawdzenia, często błędny w katalogach
Osoby kluczoweZałożyciele, zarząd, eksperci z imienia i nazwiskaEncje Person powiązane z firmą
Lokalizacja i obszar działaniaSiedziba, oddziały, rynkiOdróżnia od firm o tej samej nazwie w innym miejscu
IdentyfikatoryNIP, REGON, KRSNajmocniejszy sygnał jednoznaczności
Kategoria i tematyBranża, specjalizacje, technologieWiąże markę z tematami, w których ma być rozpoznawana
Oficjalne profileLista URL-i, które naprawdę należą do markiLista kandydatów do sameAs

Przy każdym fakcie zapisuję status: potwierdzony, sprzeczny (z listą miejsc, gdzie jest inna wartość) albo brakujący. Lista sprzeczności to gotowy plan poprawek, uszeregowany według tego, jak ważne jest dane źródło dla Google i dla odpowiedzi AI.

Entity home – strona, która definiuje markę

Entity home to jedna strona w Twojej witrynie, zwykle „O firmie”, która podaje wszystkie fakty z arkusza w formie czytelnej dla człowieka i maszyny. Inne źródła mają ją potwierdzać, a ona ma do nich linkować.

Projektuję ją jak stronę z faktami, a nie jak stronę wizerunkową. Typowy układ:

  • Pierwszy akapit to opis z arkusza faktów: nazwa, czym się zajmujesz, dla kogo, gdzie i od kiedy.
  • Ludzie z imienia i nazwiska, z rolą i linkiem do ich profili lub stron autorów.
  • Dane rejestrowe w stopce lub w osobnym bloku: nazwa prawna, NIP, KRS lub CEIDG, adres.
  • Specjalizacje nazwane wprost, tymi samymi słowami, których używasz w ofercie i profilach.
  • Potwierdzenia zewnętrzne: publikacje, wystąpienia, nagrody, z linkami do źródeł.
  • Linki do oficjalnych profili, widoczne dla użytkownika, a nie tylko ukryte w kodzie.

Google w dokumentacji danych strukturalnych Organization zaleca umieszczenie ich na stronie głównej albo na jednej stronie opisującej organizację. Ja wybieram jedno z tych miejsc jako definicję encji, a na pozostałych podstronach tylko się do niej odwołuję.

Graf JSON-LD – Organization, Person i WebSite połączone przez @id

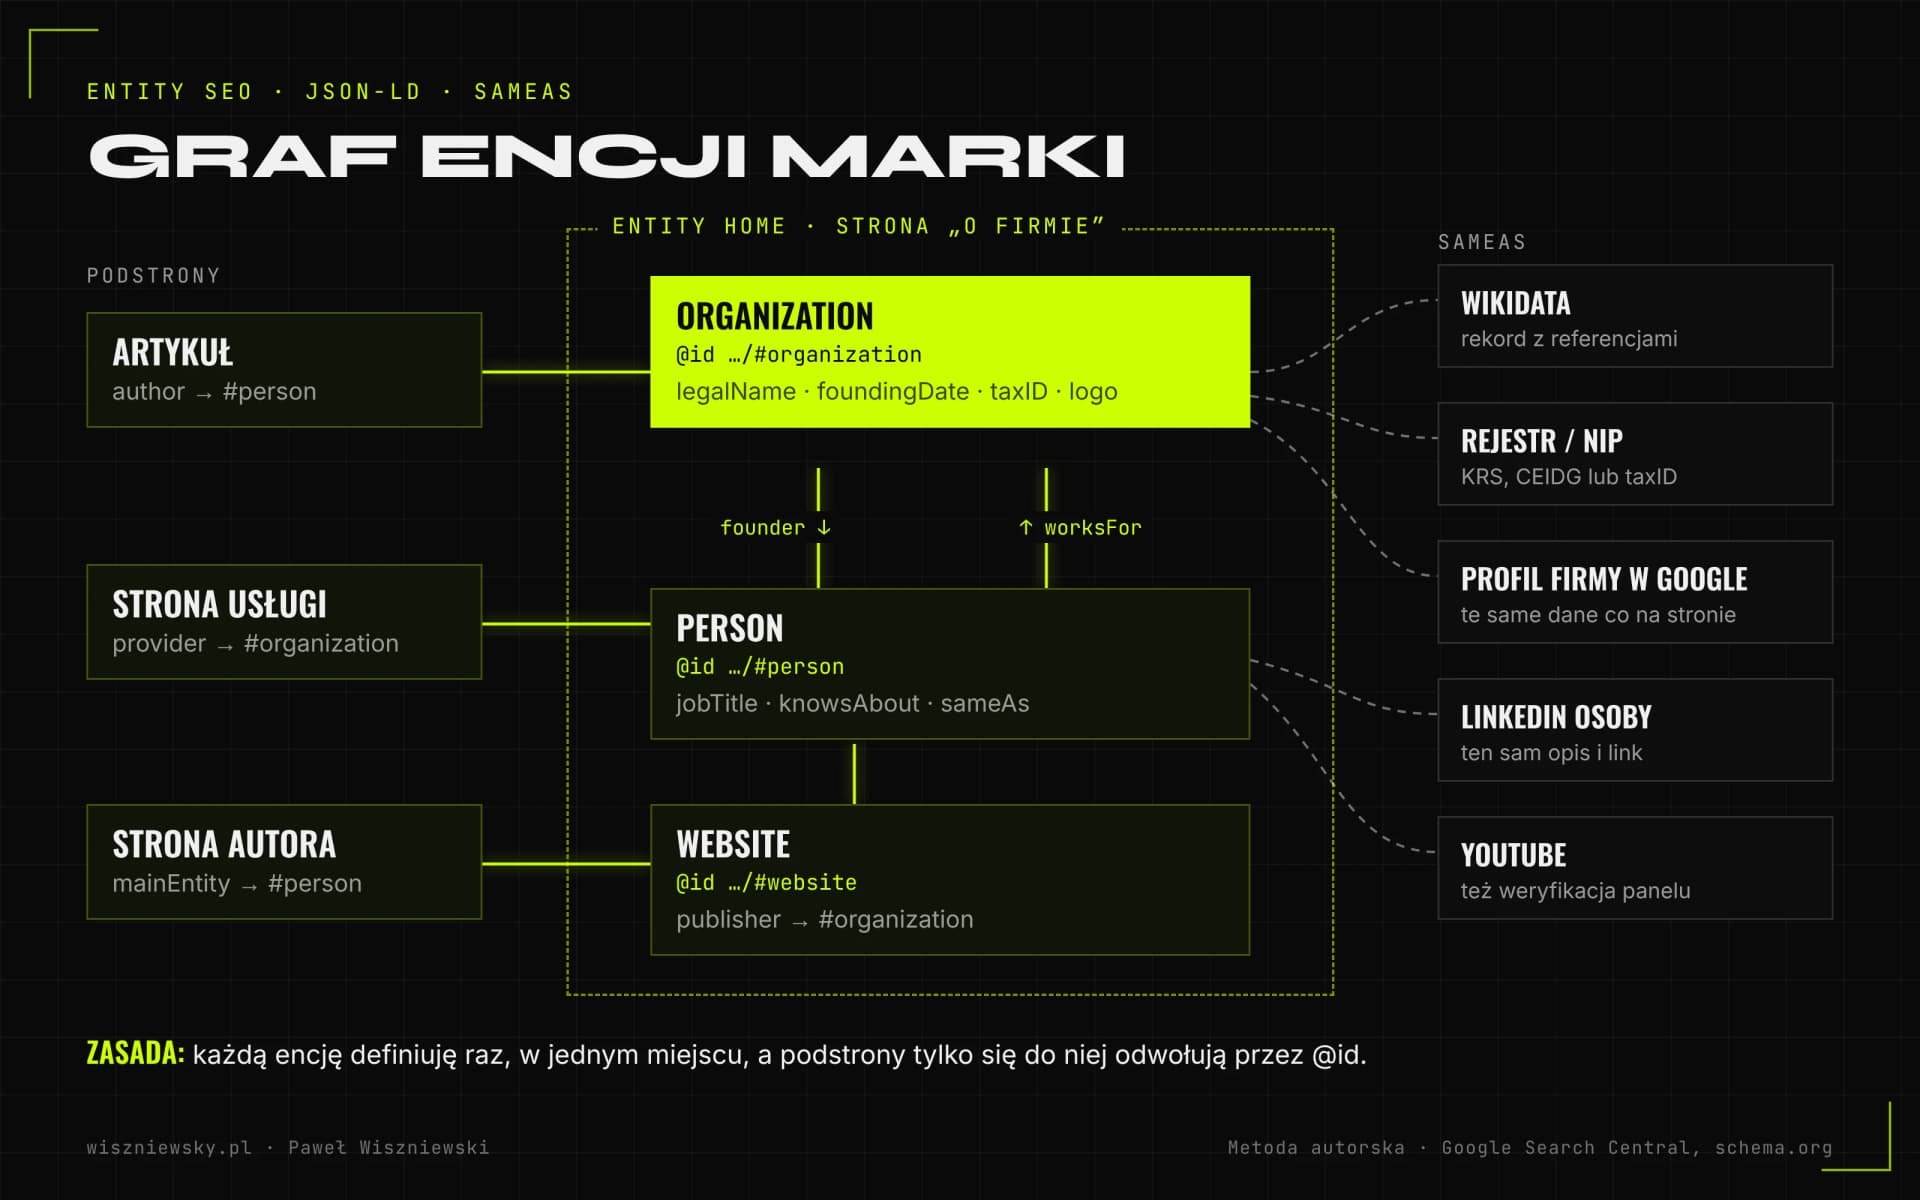
Graf JSON-LD to zestaw danych strukturalnych, w którym każda encja (firma, osoba, witryna) ma stały identyfikator @id, jest zdefiniowana raz, a inne strony i encje odwołują się do niej. Dzięki temu cała witryna opisuje jedną, spójną firmę, a nie dziesiątki niepowiązanych bytów.

Graf encji: strona „O firmie” z encjami Organization, Person i WebSite połączonymi przez @id oraz linki sameAs do Wikidata, rejestru, LinkedIna i Google.
Jak łączę encje na stronie i poza nią; metoda autorska oparta na dokumentacji Google (Organization, Article) i schema.org.

Właściwości, które wypełniam

Google w dokumentacji Organization (aktualizacja z września 2026 r.) nie wymaga żadnej właściwości, ale rekomenduje m.in. name, alternateName, legalName, url, logo, description, address, contactPoint, sameAs, foundingDate, numberOfEmployees oraz identyfikatory: vatID, taxID, iso6523Code i naics. O dwóch ostatnich pisze, że pomagają odróżnić organizację od innych, a o logo, że pomaga Google wybrać logo pokazywane w wynikach i panelu wiedzy.

EncjaKluczowe właściwościPowiązania
Organization (lub podtyp, np. ProfessionalService, LocalBusiness)name, legalName, alternateName, description, foundingDate, address, logo, taxID, vatID, sameAsfounder i employee wskazują @id osób
Person (założyciel, ekspert, autor)name, jobTitle, description, image, knowsAbout, sameAsworksFor wskazuje @id firmy
WebSitename, url, inLanguagepublisher wskazuje @id firmy lub osoby
Article lub BlogPosting na podstronachheadline, datePublished, dateModifiedauthor i publisher jako odwołania do @id

Tak jest zbudowana ta strona: jedna encja Person z identyfikatorem https://wiszniewsky.pl/#person i encja firmy, które wskazują się nawzajem (founder i worksFor), a w sameAs osoby jest m.in. rekord w Wikidata. Wpisy na blogu nie definiują autora od nowa, tylko odwołują się do tego @id. Dla Google zalecenia dotyczące autora w Article są proste: każdy autor osobno, w author.name samo imię i nazwisko, a author.url lub sameAs prowadzi do strony, która tę osobę identyfikuje.

Ważna granica: Google pisze w dokumentacji funkcji AI w wyszukiwarce, że do pojawienia się w AI Overviews i AI Mode nie trzeba żadnych specjalnych znaczników. Graf JSON-LD nie jest więc „przepustką”, tylko maszynowo czytelną wersją faktów, które i tak są na stronie. Wdrożenie robię bezpośrednio w kodzie, tak jak w usłudze wdrażania Schema.org, a typy i składnię opisuję w przewodniku po danych strukturalnych.

sameAs – które profile dodać, a których nie

Do sameAs dodaję tylko adresy, które jednoznacznie wskazują tę samą markę lub osobę i które marka kontroluje albo które są uznanymi bazami wiedzy. schema.org definiuje sameAs jako URL strony, która jednoznacznie wskazuje tożsamość obiektu, więc każdy błędny link osłabia, a nie wzmacnia encję.

Typ profiluCzy dodajęWarunek
WikidataTakRekord istnieje, ma referencje i opisuje właściwą encję
WikipediaTakTylko jeśli hasło już istnieje i dotyczy tej marki
LinkedIn firmy lub osobyTakProfil aktywny, z tym samym opisem i linkiem do strony
YouTube, X, Facebook, InstagramTakOficjalne konto, regularnie używane
Rejestr firm (KRS, CEIDG)WybiórczoTylko jeśli rejestr ma stały, publiczny adres strony tej firmy; w przeciwnym razie identyfikator trafia do taxID lub vatID
Katalogi branżowe i serwisy z opiniamiWybiórczoTylko uznane w branży i z kompletnym profilem
Profile porzucone, fanpage pracownika, artykuły o marceNieTo nie są strony tożsamości; artykuły to wzmianki, nie profile

Wikidata w praktyce – kryteria i ryzyka

Rekord w Wikidata ma sens wtedy, gdy marka spełnia zasady przyjmowania elementów i istnieją publiczne, poważne źródła, które ją opisują. Bez tego wpis zostanie zgłoszony do usunięcia, a próba „przepchnięcia” go zostawia ślad w historii edycji.

Zasady notability Wikidata wymieniają trzy kryteria, z których wystarczy spełnić jedno: element ma link do strony w projekcie Wikimedia (np. Wikipedii), opisuje jasno identyfikowalną encję, którą da się opisać na podstawie poważnych i publicznie dostępnych źródeł, albo jest potrzebny strukturalnie, żeby uzupełnić twierdzenia w innych elementach. Firmy bez hasła w Wikipedii zwykle opierają się na drugim kryterium, dlatego źródła przygotowuję przed utworzeniem rekordu.

  • Źródła, które sprawdzają się jako referencje: wpis w rejestrze, artykuły w mediach branżowych lub lokalnych, publikacje, informacje o nagrodach.
  • Źródła słabe: własna strona jako jedyne potwierdzenie, komunikaty prasowe przedrukowane bez redakcji, profile społecznościowe.
  • Opis elementu ma odróżniać encję od innych o tej samej nazwie (np. „polska firma programistyczna, Białystok”), a nie reklamować.
  • Pętla potwierdzenia: w rekordzie wskazuję oficjalną stronę, a na stronie dodaję URL rekordu do sameAs.

Pełną instrukcję tworzenia rekordu, z właściwościami i kolejnością, opisuję w artykule Wikipedia, Wikidata i panel wiedzy. Wikipedii nie edytuję w imieniu klientów: to pole konfliktu interesów i jedyne, co realnie mogę zrobić, to pomóc zdobyć niezależne źródła, na których hasło mogłoby kiedyś powstać.

Panel wiedzy – jak go przejąć i poprawić

Panelu wiedzy nie da się zamówić ani „zgłosić” przez Search Console. Pojawia się, gdy Google ma dość potwierdzonych informacji o encji, a dopiero wtedy można go przejąć i zgłaszać poprawki.

Według pomocy Google proces wygląda tak:

  1. Wyszukujesz markę lub osobę i znajdujesz panel wiedzy.
  2. Na dole panelu (czasem w sekcji z informacjami) klikasz przycisk przejęcia panelu, w angielskiej wersji „Claim this knowledge panel”.
  3. Logujesz się na jedno z oficjalnych kont wskazanych przez Google, np. YouTube lub Search Console witryny. Jeśli Google nie może powiązać żadnego konta, prosi o dodatkowe potwierdzenie tożsamości.
  4. Po weryfikacji zgłaszasz zmiany przez opcję opinii (Feedback) pod panelem: zaznaczasz konkretny fakt, opisujesz, co ma się zmienić, i dodajesz linki, które to potwierdzają.
  5. Zweryfikowany właściciel może dodać kolejne osoby do zarządzania panelem.

Search Console pełni tu tylko rolę jednego ze sposobów weryfikacji. Dlatego przy wdrożeniu pilnuję, żeby witryna była zweryfikowana w Search Console na koncie, do którego firma ma dostęp, a oficjalny kanał YouTube był podpięty w sameAs. Skraca to drogę, gdy panel się pojawi.

Encje osób – założyciele, eksperci i autorzy

W wielu firmach, zwłaszcza usługowych i eksperckich, to osoba założyciela jest najbardziej rozpoznawalną encją. Model, który pyta „kto jest ekspertem od [tematu]”, szuka ludzi, nie tylko firm, dlatego encje Person traktuję jako część tej samej pracy.

  • Strona autora lub eksperta w witrynie z biogramem, specjalizacją, zdjęciem i linkami do profili.
  • Person w JSON-LD z jednym @id, powiązany z firmą przez worksFor i founder.
  • Spójny podpis we wszystkich artykułach, wywiadach i wystąpieniach: to samo imię i nazwisko, ta sama rola.
  • Profile zewnętrzne (LinkedIn, profile autorskie w mediach) z tym samym opisem i linkiem do strony firmy.

Jak budować rozpoznawalność eksperta w odpowiedziach AI, opisuję w artykule Marka osobista eksperta. Zakres usługi obejmuje osoby kluczowe, jeśli ustalimy to na starcie, bo od liczby osób zależy część kosztu.

Trudne przypadki – rebranding, fuzja i nazwa wspólna z inną firmą

Najwięcej pracy wymagają sytuacje, w których dane o marce są nie tylko niepełne, ale i sprzeczne z definicji: zmiana nazwy, połączenie firm albo nazwa, którą nosi też ktoś inny.

SytuacjaRyzykoCo robię
RebrandingModele i katalogi długo używają starej nazwy, panel może pokazywać stare logoStara nazwa w alternateName i w aliasach Wikidata, informacja o zmianie nazwy na entity home, aktualizacja profili od najważniejszych, przekierowania 301 ze starej domeny
Fuzja lub przejęcieDwie encje zamiast jednej albo pomylone fakty obu firmDecyzja, która encja zostaje główna, opis relacji na stronie, aktualizacja rekordów w Wikidata zgodnie z faktami i źródłami
Nazwa wspólna z inną firmąModel miesza fakty albo poleca konkurentaMocny opis rozróżniający (branża, miasto, identyfikatory), konsekwentne używanie nazwy z doprecyzowaniem w profilach, budowa wzmianek łączących nazwę z tematem
Firma z wieloma lokalizacjamiRozjazd danych między oddziałamiJedna encja organizacji i osobne encje lokalizacji powiązane z nią, każda z kompletną wizytówką
Marka osobista i firma pod inną nazwąModel nie łączy osoby z firmąDwukierunkowe powiązanie Person i Organization w JSON-LD oraz na stronie i w profilach

Przy zmianie domeny encja jest tylko jednym z elementów. Jeśli rebranding obejmuje nowy adres strony, łączę tę pracę z migracją SEO, żeby nie stracić pozycji przy okazji porządkowania danych. Gdy model powtarza nieprawdziwe informacje, pomocny będzie też wpis o tym, co zrobić, gdy ChatGPT mówi o firmie nieprawdę.

Powiązanie marki z tematami – wzmianki, które budują encję

Encja, która jest rozpoznana, ale nie jest kojarzona z żadnym tematem, nie trafi do rekomendacji. Drugim celem tej usługi jest więc powiązanie nazwy marki z kategoriami, w których chcesz być polecany.

Robię to na trzy sposoby: konsekwentnie łącząc nazwę z tematami na własnej stronie (opis, specjalizacje, knowsAbout w danych strukturalnych), dbając o to, żeby profile zewnętrzne opisywały te same specjalizacje, oraz planując wzmianki w miejscach, które piszą o Twojej kategorii. Plan wzmianek jest częścią wyników usługi, ale samo pozyskiwanie publikacji to osobna praca, opisana w strategii cytowań LLM i we wpisie o digital PR i wzmiankach o marce.

Przykład pełnej ścieżki, od architektury encji przez treści po wzmianki w mediach branżowych, pokazuje case study marki modowej, w którym wyszukiwania nazwy marki wzrosły z 840 do 2 350 miesięcznie.

Jak mierzę postęp w budowaniu encji

Postęp mierzę stałym zestawem wskaźników, sprawdzanych przed wdrożeniem i potem co miesiąc, a nie pojedynczym zrzutem ekranu panelu wiedzy.

WskaźnikJak mierzęCo oznacza zmiana
Obecność encji w Knowledge GraphKnowledge Graph Search API: czy jest wynik, jaki typ i opisGoogle rozpoznał markę jako encję lub zmienił jej opis
Panel wiedzyWyszukiwanie nazwy, zrzut i lista faktów w paneluGoogle ma dość potwierdzonych danych, by pokazać panel
Brand SERPIle z 10 pierwszych wyników to strony i profile markiKontrola nad tym, co widzi osoba szukająca nazwy
Poprawność odpowiedzi AIStały zestaw pytań o fakty, każde zadane kilka razy; odsetek odpowiedzi bez błędówModele korzystają z poprawionych źródeł
Spójność źródełLiczba sprzeczności w arkuszu faktówPostęp porządków poza stroną
Wyszukiwania brandoweZapytania z nazwą marki w Search ConsoleRosnąca rozpoznawalność, także poza AI

Do testów odpowiedzi AI używam własnego narzędzia opisanego w case study AnswerLyzer, które ocenia odpowiedzi modeli metodą LLM-as-a-judge. Ręczną wersję takiego pomiaru opisuję w artykule o audycie widoczności w AI.

Harmonogram – co zależy ode mnie, a co od Google i modeli AI

Część pracy ma przewidywalny termin, bo wykonuję ją sam. Reszta zależy od tego, kiedy Google ponownie przetworzy strony i kiedy zewnętrzne źródła oraz modele uwzględnią zmiany, i tego terminu nikt uczciwie nie zagwarantuje.

EtapKto ma wpływCzego się spodziewać
Audyt encji i arkusz faktówJa, z Twoją akceptacją faktówGotowe na początku współpracy
Entity home i graf JSON-LDJa (wdrożenie w kodzie lub CMS)Wdrożone po akceptacji arkusza
Poprawki w profilach i katalogachJa lub Ty, zależnie od dostępówCzęść od razu, część czeka na weryfikację serwisów
Rekord w WikidataJa, ale ostatecznie społeczność WikidataUtworzony, gdy są źródła; może być dyskutowany przez edytorów
Ponowne przetworzenie strony przez GoogleGoogleOd kilku dni do kilku tygodni
Panel wiedzy i poprawne odpowiedzi AIGoogle i dostawcy modeliProces liczony raczej w miesiącach, bez gwarancji

Usługa jest częścią szerszego GEO, czyli pozycjonowania w AI. Jeśli nie wiesz, od czego zacząć, zwykle proponuję najpierw audyt widoczności, bo pokazuje, czy problemem jest encja, treści czy brak wzmianek.

Najczęstsze pytania

Czy każda firma może mieć wpis w Knowledge Graph?

Tak, ale Google preferuje organizacje z wystarczającą widocznością webową — linki z wiarygodnych źródeł, wzmianki prasowe, wpis w Wikidata lub branżowych bazach danych. Dla bardzo nowych firm najpierw buduję te sygnały.

Jak sprawdzić czy moja firma jest w Knowledge Graph?

Wpisz nazwę firmy w Google. Jeśli po prawej stronie pojawia się panel wiedzy (Knowledge Panel) z logiem, opisem i linkami — jesteś w KG. Brak panelu nie oznacza jednak, że encji tam nie ma: pewniej sprawdzisz to przez Google Knowledge Graph Search API.

Jaki to ma związek z ChatGPT i Gemini?

Modele stojące za ChatGPT i Gemini trenowane były na miliardach stron webowych, w tym danych strukturalnych Schema.org i Wikidata. Firmy z bogatą encją w KG są rozpoznawane przez LLM jako wiarygodne źródła i są cytowane w odpowiedziach AI znacznie częściej niż nieznane marki.

Czym jest Entity SEO i jak inżynieria grafu wiedzy wpływa na SEO i widoczność w AI?

Entity SEO Polska to podejście, w którym optymalizuję markę nie przez słowa kluczowe, lecz przez budowanie encji — rozpoznawalnej tożsamości semantycznej w Google Knowledge Graph i Wikidata. Pozycjonowanie semantyczne encji pomaga Google jednoznacznie zrozumieć markę jako organizację (E-E-A-T nie jest bezpośrednim czynnikiem rankingowym), a LLM łatwiej cytują ją w odpowiedziach. Inżynieria grafu wiedzy to fundament budowania autorytetu marki dla LLM.

Ile trwa, zanim Google i AI zaczną poprawnie rozpoznawać markę?

Zmiany na stronie i w danych strukturalnych Google widzi po ponownym zaindeksowaniu, zwykle w ciągu kilku tygodni. Panel wiedzy i poprawne odpowiedzi modeli AI wymagają spójnych sygnałów z wielu źródeł, więc to proces liczony raczej w miesiącach.

Czy moja firma może mieć wpis w Wikidata?

Jeśli istnieją niezależne, wiarygodne źródła, które ją opisują (media, rejestry, publikacje branżowe), zwykle tak. Kryteria są łagodniejsze niż w Wikipedii. Pomagam przygotować wpis zgodny z zasadami, żeby nie został usunięty.

Ile kosztuje inżynieria grafu wiedzy?

Usługa zaczyna się od 3 000 zł. Cena zależy od liczby źródeł do uporządkowania, stanu danych o marce w sieci i tego, czy obejmuje też osoby kluczowe, np. założycieli lub ekspertów.

Masz projekt?

Przerwij
Ciszę

Zainicjuj protokół. Nawiąż połączenie. Zbudujmy coś głośnego.

> OCZEKIWANIE_NA_SYGNAŁ...