WRÓĆ DO AI & Automatyzacja

Fine-tuning LLM dla Firm – Custom LLM i Dedykowane Modele AI

Fine-tuning otwartych modeli (Qwen3, Llama, Mistral, Bielik) na Twoich danych z LoRA/QLoRA. Model specyficzny dla Twojej domeny wdrożony na Twojej infrastrukturze przez API vLLM.

Autor: Paweł Wiszniewski · Aktualizacja:

W skrócie

Fine-tuning otwartych modeli (Qwen3, Llama, Mistral, Bielik) na Twoich danych z LoRA/QLoRA. Model specyficzny dla Twojej domeny wdrożony na Twojej infrastrukturze przez API vLLM.

  • ›Model specyficzny dla domeny trenowany na Twoich danych
  • ›Trening LoRA/QLoRA
  • ›Automatyczny zestaw ewaluacyjny z metrykami specyficznymi dla zadania (dokładność, F1, BLEU, ROUGE lub własne rubryki) do obiektywnego pomiaru poprawy.

Cena: od 9 100 zł

SZCZEGÓŁY USŁUGI

Przeprowadzam fine-tuning otwartych modeli LLM (np. Qwen3, Llama, Mistral, Bielik 11B v3) na Twoich własnościowych danych przy użyciu LoRA/QLoRA do efektywnego treningu na GPU A100. Fine-tuning tworzy model mówiący językiem Twojej domeny, stosujący Twój format wyjściowy i przewyższający ogólne LLM w Twoim specyficznym zadaniu — przy niższym koszcie niż API dużego modelu w skali. Wytrenowany model wdrażam na Twojej infrastrukturze przez vLLM lub TGI, w pełni pod Twoją kontrolą.

› INVESTMENT:

od 9 100 zł
const module = new ExecutionProtocol();

// Initializing llm-fine-tuning...
› Loading dependencies... OK
› Establishing connection... OK
› Ready for deployment... AWAITING_COMMAND

Paweł Wiszniewski · moje podejście

Co robię inaczej

Najczęściej zaczynam rozmowę o fine-tuningu od odradzenia go — w większości przypadków lepszy prompt, kilka przykładów albo RAG dają ten sam efekt taniej i szybciej. Fine-tuning ma sens, gdy potrzebujesz stałego formatu i stylu przy dużym wolumenie, gdy dane nie mogą opuścić Twojej infrastruktury albo gdy koszt API zaczyna być realnym problemem. Zanim zaczniemy trening, robię test: ten sam zestaw zadań na modelu bazowym z dobrym promptem. Jeśli wynik wystarcza, oszczędzasz budżet. Szczegóły tej decyzji opisuję na blogu.

Przeczytaj mój przewodnik na blogu

Moje zdanie i przykład z rynku

Moje zdanie

Mam zdanie, które obniża mi sprzedaż: fine-tuning to najczęściej przepłacone rozwiązanie w AI. Zanim zaproponuję trening modelu, buduję zestaw testowy i sprawdzam, ile da dobry prompt z przykładami.

Z rynku

Sam OpenAI w dokumentacji optymalizacji modeli opisuje proces, który zaczyna się od napisania ewaluacji i promptowania, a fine-tuning traktuje jako krok dla wybranych zastosowań — sprawdzany tymi samymi testami. Jeśli dostawca modelu zaleca zaczynanie od ewaluacji, a nie od treningu, warto go posłuchać.

Źródła: OpenAI: Model optimization (evals, prompty, fine-tuning)

Dla kogo jest ta usługa

  • Firmy, którym gotowe modele nie radzą sobie z branżowym słownictwem lub formatem odpowiedzi.
  • Produkty z dużym wolumenem zapytań AI, w których koszt API zaczyna boleć.
  • Organizacje z danymi, które muszą zostać na własnej infrastrukturze.
  • Zespoły, które potrzebują przewidywalnego stylu i struktury odpowiedzi.

Co dokładnie dostajesz

  • Ocenę, czy fine-tuning to właściwe rozwiązanie, czy wystarczy RAG lub lepszy prompt.
  • Przygotowanie i czyszczenie danych treningowych w formacie instrukcja–odpowiedź.
  • Trening metodą LoRA/QLoRA i porównanie z modelem bazowym.
  • Zestaw ewaluacyjny z metrykami dopasowanymi do zadania.
  • Wdrożenie modelu przez API zgodne z OpenAI (vLLM lub TGI) na Twojej infrastrukturze.

Jak mierzę efekty

  • Jakość odpowiedzi na wydzielonym zbiorze testowym względem modelu bazowego.
  • Koszt obsługi jednego zapytania.
  • Czas odpowiedzi modelu pod obciążeniem.
  • Zgodność odpowiedzi z wymaganym formatem i stylem.

Dlaczego warto?

Model specyficzny dla domeny trenowany na Twoich danych — w Twoim konkretnym zadaniu może dorównać dużemu modelowi w API lub go przewyższyć, przy niższym koszcie wnioskowania w skali (sprawdzam to na zestawie testowym).

Trening LoRA/QLoRA — fine-tuning modelu 7B lub 13B na jednym GPU A100 w ciągu kilku godzin, czyniąc własne LLM ekonomicznie opłacalnymi dla każdej skali.

Automatyczny zestaw ewaluacyjny z metrykami specyficznymi dla zadania (dokładność, F1, BLEU, ROUGE lub własne rubryki) do obiektywnego pomiaru poprawy.

Serwer wnioskowania gotowy do wdrożenia (vLLM lub TGI) z API kompatybilnym z OpenAI — zamiennik dla istniejących wywołań API dużego modelu.

Pełna własność modelu — Twoje wytrenowane wagi są Twoje, można je wdrożyć on-premise lub w prywatnej chmurze, bez bieżących kosztów API za token.

Jak to działa?

1

Przygotowanie i kontrola jakości danych

Zbieram, czyszczę i formatuję Twoje dane w pary instrukcja-odpowiedź. Przeglądam jakość danych i oznaczam próbki, które nauczyłyby model złych zachowań przed rozpoczęciem treningu.

2

Trening

Przeprowadzam fine-tuning modelu bazowego z użyciem LoRA na GPU A100 z ciągłym monitorowaniem loss, metrykami walidacyjnymi i wczesnym zatrzymaniem zapobiegającym nadmiarowej optymalizacji.

3

Ewaluacja i iteracja

Testuję model na wydzielonym zbiorze testowym używając metryk specyficznych dla zadania, porównuję z linią bazową i iteruję hiperparametrami lub danymi treningowymi do osiągnięcia celów.

4

Wdrożenie i konfiguracja API

Wdrażam wytrenowany model na vLLM lub TGI z API REST kompatybilnym z OpenAI, konfiguruję ograniczenia szybkości i uwierzytelnianie, dokumentuję API dla Twojego zespołu inżynierów.

Fine-tuning własnego modelu vs RAG vs API dużego modelu

KryteriumFine-tuning (Qwen/Llama/Mistral)RAG na dokumentachAPI dużego modelu (ogólne)
Koszt wnioskowania przy skaliNiski — własna infrastrukturaŚredniWysoki — opłata za token
Własność modeluPełna — Twoje wagiCzęściowa (zależy od LLM)Brak
Specyficzny styl i formatBardzo wysokiOgraniczonyŚredni
Aktualizacja wiedzy faktycznejWymaga ponownego treninguNatychmiastowaBrak kontroli
Prywatność danychPełna — on-premiseWysoka (self-hosted)Dane u dostawcy
Czas i nakład wdrożeniaWysoki — dane i treningŚredniNiski
Najlepszy dlaStałego, dużego wolumenu i własnego styluPytań o aktualne fakty z dokumentówSzybkiego startu i niskiego wolumenu

Najczęstsze błędy

  • Fine-tuning po to, żeby model „znał” wiedzę firmy — do faktów lepiej służy RAG.
  • Trening na małej liczbie przypadkowych przykładów niskiej jakości.
  • Brak zestawu ewaluacyjnego, przez co nie wiadomo, czy model jest lepszy od bazowego.
  • Pominięcie kosztów utrzymania: serwera, monitoringu i ponownego treningu.

Kiedy ta usługa nie ma sensu

  • Masz niski wolumen zapytań i koszt API nie jest problemem.
  • Twoja wiedza zmienia się co tydzień — fine-tuning ją zamrozi.
  • Nie masz danych z przykładami dobrych odpowiedzi i nie da się ich przygotować.
/// PORADNIK

Fine-tuning LLM dla firmy – jak decyduję, czy trenować model, i jak to robię w 2026

Ten poradnik opisuje decyzje, które w projekcie fine-tuningu zapadają przed pierwszą godziną na GPU: czy trening w ogóle rozwiąże problem, który model bazowy wybrać przy polskich danych, jaką metodą trenować, jak sprawdzić dane i jak udowodnić, że wytrenowany model jest lepszy. Opisuję też zmiany z 2026 roku u dostawców API, koszty utrzymania i kwestie prawne. Tam, gdzie piszę o swojej metodzie, mówię wprost, że to moja praktyka; liczby mają podane źródło.

Czy fine-tuning rozwiąże Twój problem – diagnoza, którą robię przed wyceną

Fine-tuning zmienia zachowanie modelu: format, styl, sposób klasyfikowania i terminologię. Nie jest dobrym sposobem na dodanie modelowi wiedzy o firmie. Dlatego pierwsze pytanie brzmi: czy model nie wie, czy wie, ale robi to źle?

Dobrze pokazuje to badanie Google Research i Technion „Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations?” (Gekhman i in., EMNLP 2024). Autorzy sprawdzili, co się dzieje, gdy dane treningowe zawierają fakty, których model nie znał. Model uczył się ich wyraźnie wolniej niż przykładów zgodnych z jego wiedzą, a gdy już je przyswoił, rosła jego skłonność do halucynacji. Wniosek autorów: wiedzę model zdobywa głównie w pretreningu, a fine-tuning uczy go lepiej z niej korzystać. Cennik, oferta czy procedury powinny więc trafiać do modelu przez wdrożenie RAG, a nie przez trening.

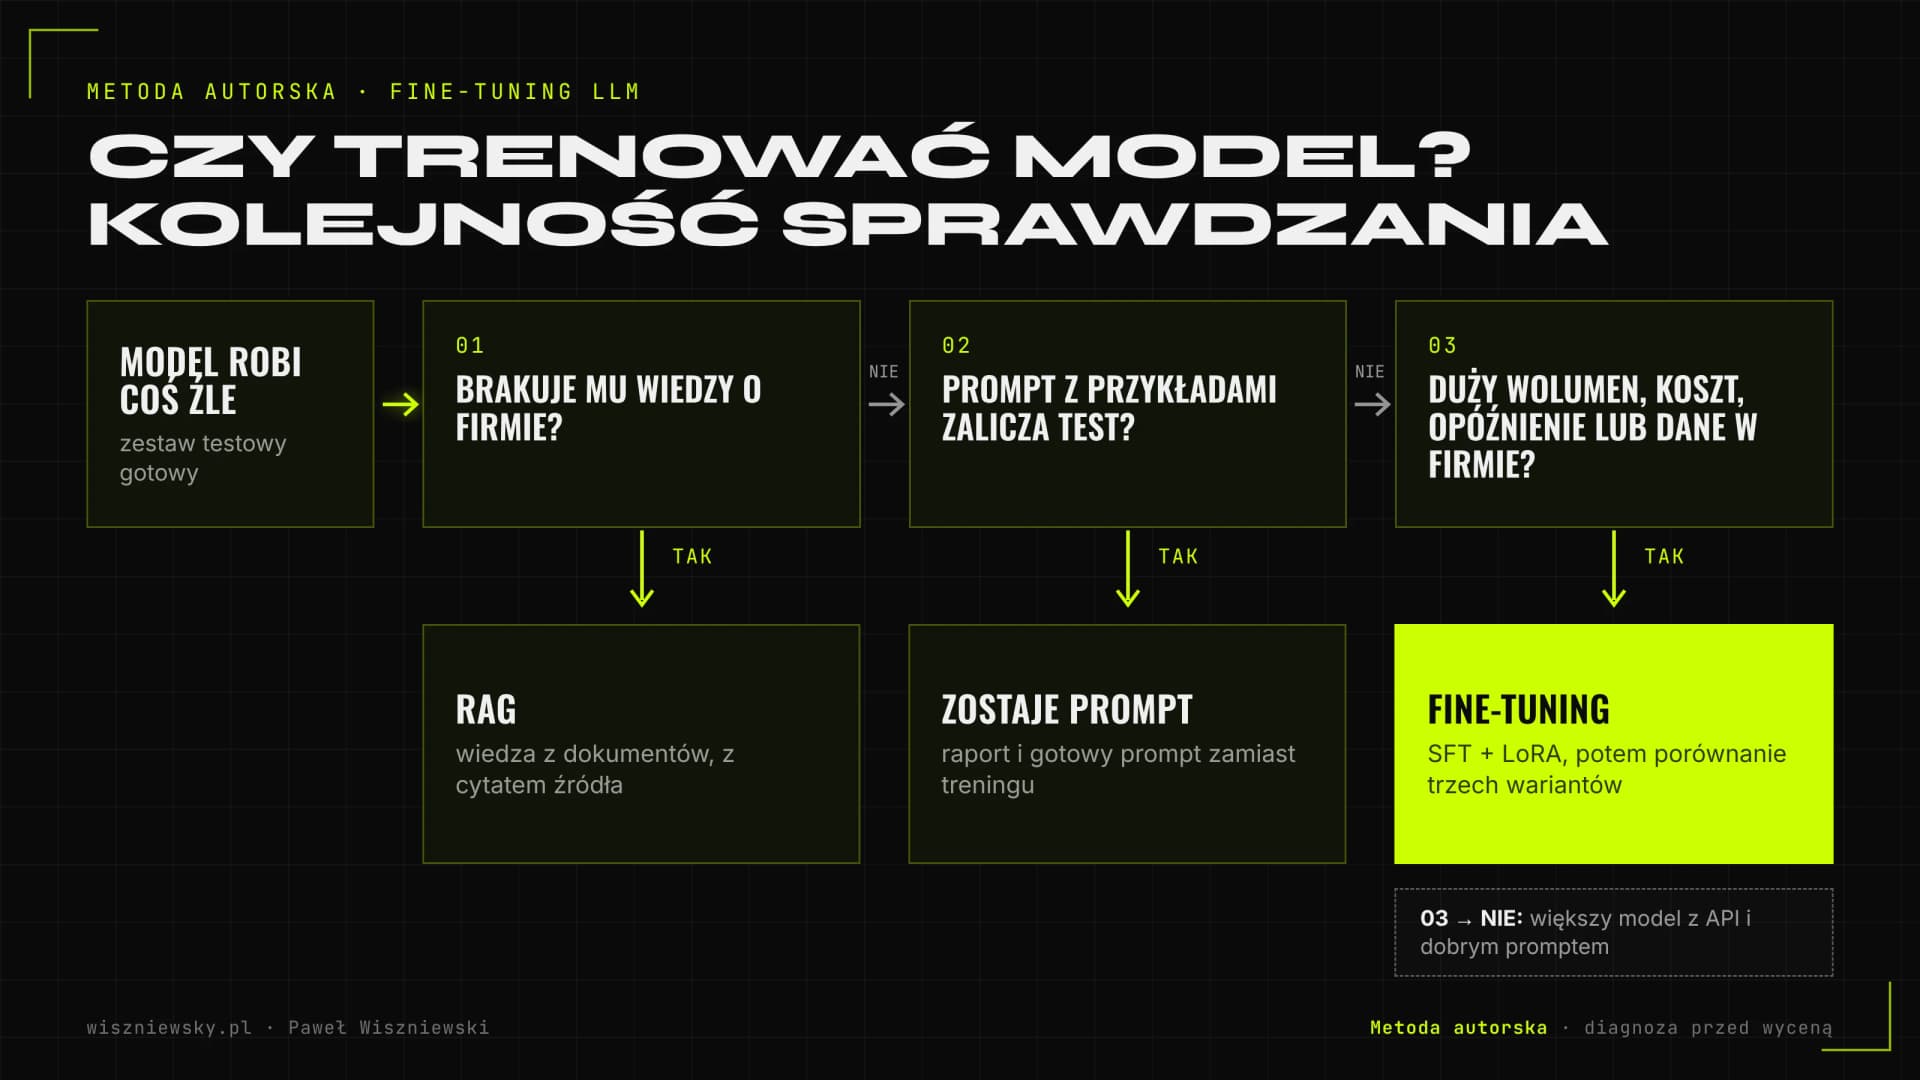
Drzewo decyzji fine-tuningu: brak wiedzy prowadzi do RAG, problem z formatem najpierw do promptu z przykładami, a fine-tuning dopiero przy niezaliczonym teście, dużym wolumenie lub wymogu własnej infrastruktury
Kolejność, w jakiej sprawdzam rozwiązania przed treningiem. Metoda autorska.

Objawy i co sprawdzam najpierw

ObjawNajczęstsza przyczynaCo testuję najpierwKiedy przechodzę do fine-tuningu
Model podaje nieaktualne lub zmyślone fakty o firmieBrak wiedzyRAG z cytowaniem źródełPrawie nigdy; ewentualnie razem z RAG, żeby utrwalić format odpowiedzi
JSON lub raport czasem ma złą strukturęSłaba specyfikacja formatuStructured outputs i schemat odpowiedziGdy format jest złożony, a schemat i przykłady nie dają stabilnych wyników
Odpowiedzi poprawne, ale w „asystenckim” styluPrompt nie oddaje styluPrompt z 5–20 wzorcowymi przykładamiGdy styl ma być stały przy tysiącach odpowiedzi dziennie
Klasyfikacja zgłoszeń myli podobne kategorieGranice kategorii znane tylko ludziomLepsze definicje kategorii i przykłady graniczneGdy jest kilkaset oznaczonych przykładów i wynik promptu nie przechodzi progu
Koszt lub czas odpowiedzi dużego modelu za wysokiZa duży model do prostego zadaniaMniejszy model z tym samym promptemGdy mały model bez treningu nie zalicza testu, a duży zalicza: wtedy destylacja
Dane nie mogą opuścić firmyWymóg prawny lub umownyOtwarty model na własnym serwerze bez treninguGdy otwarty model z promptem odstaje jakością od modelu z chmury

OpenAI w dokumentacji optymalizacji modeli (2026) wymienia te same powody, dla których fine-tuning ma sens: więcej przykładów, niż zmieści się w jednym zapytaniu, krótsze prompty przy dużej skali i mniejszy, tańszy model do konkretnego zadania. Do strukturyzowania odpowiedzi bez treningu wracam w artykule Structured outputs w produkcji, a do pracy z przykładami w promptach w tekście Prompt engineering dla biznesu.

Fine-tuning w 2026 – co zmieniło się u dostawców API

W 2026 roku fine-tuning przez API dużych dostawców stał się mniej pewną drogą. OpenAI wygasza swoją platformę fine-tuningu, więc model wytrenowany u dostawcy trzeba traktować jako zależność z datą ważności, a otwarte wagi jako rozwiązanie, które zostaje pod Twoją kontrolą.

Według strony wycofań OpenAI (komunikat z 7 maja 2026) wygaszanie przebiega etapami: od 7 maja 2026 nowe organizacje nie mogą tworzyć zadań treningowych, od 2 lipca 2026 tracą tę możliwość organizacje, które przez 60 dni nie korzystały z wytrenowanego modelu, a od 6 stycznia 2027 nowych treningów nie uruchomią także aktywni klienci. Wytrenowane modele działają dalej, ale tylko do wycofania ich modelu bazowego. Dokumentacja optymalizacji modeli OpenAI potwierdza, że nowi użytkownicy nie mają już dostępu do platformy.

Inni dostawcy nadal oferują trening, ale w ograniczonym zakresie. Google udostępnia w Vertex AI nadzorowany tuning wybranych modeli Gemini, a Anthropic w 2024 roku udostępnił fine-tuning modelu Claude 3 Haiku przez Amazon Bedrock. Lista modeli, które można trenować, zmienia się razem z cyklem życia modeli, więc przed projektem sprawdzam ją w aktualnej dokumentacji.

KryteriumFine-tuning przez API dostawcyFine-tuning otwartego modelu (LoRA)
Kto ma wagiDostawca; dostajesz identyfikator modeluTy; adapter i wagi możesz przenieść na dowolny serwer
Co się dzieje przy wycofaniu modelu bazowegoModel przestaje działać, trening trzeba powtórzyć na nowym modeluModel działa, dopóki chcesz go utrzymywać
InfrastrukturaZero; płacisz za trening i za tokenyWłasny lub wynajęty GPU, serwer inferencji, monitoring
DaneTrafiają do dostawcy na czas treninguMogą nie opuszczać Twojej infrastruktury
Jakość punktu startowegoZwykle silniejszy model bazowySłabszy model ogólny, ale często wystarczający w wąskim zadaniu

Dla klientów oznacza to jedną praktyczną zasadę: zbiór treningowy i zestaw ewaluacyjny są cenniejsze niż sam wytrenowany model. Trzymam je w otwartym formacie (JSONL), niezależnym od dostawcy, żeby przy zmianie modelu bazowego powtórzyć trening i porównać wyniki w kilka dni, a nie budować wszystko od nowa. Jak porównuję modele różnych dostawców i otwarte wagi, opisuję w artykule Jak wybrać model LLM w 2026.

Wybór modelu bazowego do fine-tuningu – licencja, rozmiar i język polski

Model bazowy wybieram według trzech kryteriów w tej kolejności: licencja pozwalająca na Twoje zastosowanie, jakość na Twoich polskich danych przed treningiem i najmniejszy rozmiar, który zalicza test. Ranking z internetu jest tylko listą kandydatów.

Licencje modeli różnią się bardziej, niż sugeruje słowo „otwarty”

Rodzina modeliLicencjaNa co zwracam uwagę
Llama 4 (Meta)Llama 4 Community LicenseFirmy z ponad 700 mln aktywnych użytkowników miesięcznie potrzebują osobnej licencji; produkt musi pokazywać „Built with Llama”, a udostępniany model trenowany na Llamie musi mieć „Llama” na początku nazwy
Qwen3 (Alibaba)Apache 2.0 (np. Qwen3-8B)Karta modelu deklaruje obsługę ponad 100 języków i dialektów; licencję sprawdzam dla każdego konkretnego wariantu, bo kolejne generacje bywają wydawane na różnych warunkach
Bielik 11B v3 (SpeakLeash, ACK Cyfronet AGH)Apache 2.0Model zoptymalizowany pod polski; pobranie wymaga udostępnienia danych kontaktowych na Hugging Face
PLLuM (konsorcjum polskich instytucji)Zależnie od wariantu: Apache 2.0, CC-BY-NC-4.0 lub licencja Llama 3.1Warianty „nc” wykluczają użycie komercyjne; licencję czytam na karcie konkretnego modelu

Bielik 11B v3 jest opisany w raporcie technicznym z grudnia 2025 roku (arXiv): autorzy zbudowali go na architekturze Mistral 7B v0.2 przez zwiększenie głębokości sieci i deklarują, że przewyższa inne modele wyspecjalizowane w polskim oraz wiele modeli od 2 do 6 razy większych. To deklaracja autorów, dlatego i tak testuję go razem z modelem wielojęzycznym na danych klienta.

Jak porównuję kandydatów przed treningiem

  1. Wybieram 2–3 modele o licencji zgodnej z planowanym użyciem i rozmiarze, który zmieści się na docelowym serwerze.
  2. Puszczam na każdym ten sam zestaw testowy z najlepszym promptem. Z mojego doświadczenia model, który bez treningu wypada najlepiej, zwykle prowadzi także po treningu.
  3. Sprawdzam tokenizację polskich tekstów: ile tokenów zajmuje typowy dokument. Więcej tokenów to dłuższy trening, wolniejsze odpowiedzi i mniej treści w oknie kontekstu.
  4. Dopiero wtedy wybieram rozmiar. Zaczynam od najmniejszego modelu, który ma szansę zaliczyć test, bo każdy krok w górę podnosi koszt serwera na cały czas działania modelu.

Uruchamianie otwartych modeli na własnym sprzęcie, w tym różnice między Ollama a vLLM, opisuję w artykule Ollama, vLLM i self-hosted LLM.

SFT, DPO, GRPO i destylacja – którą metodę treningu wybieram

W większości projektów biznesowych zaczynam od nadzorowanego fine-tuningu (SFT) z adapterem LoRA. Inne metody dokładam wtedy, gdy dane mają inny kształt: pary lepszej i gorszej odpowiedzi, automatycznie sprawdzalny wynik albo odpowiedzi większego modelu do skopiowania.

MetodaJakie dane są potrzebneCo zmienia w modeluKiedy ją stosuję
SFT (supervised fine-tuning)Pary: wejście i wzorcowa odpowiedźUczy formatu, stylu i sposobu wykonania zadaniaDomyślny start: klasyfikacja, ekstrakcja, stały format raportu
DPO (direct preference optimization)Pary: odpowiedź lepsza i gorsza na to samo wejściePrzesuwa model w stronę preferowanych odpowiedziGdy styl i dobór treści są ważniejsze niż sam format, np. streszczenia
GRPO i inne metody RLZadania z automatycznie sprawdzalnym wynikiem (test, reguła, ocena)Wzmacnia ścieżki rozumowania, które prowadzą do dobrego wynikuZadania wieloetapowe, gdzie da się napisać sprawdzarkę; rzadko w typowej firmie
DestylacjaOdpowiedzi dużego modelu na Twoje wejściaPrzenosi zachowanie dużego modelu do mniejszegoGdy duży model zalicza test, ale jest za drogi lub za wolny przy danym wolumenie

DPO opisali Rafailov i in. (NeurIPS 2023) jako metodę, która zastępuje klasyczne RLHF jednym etapem treningu na parach preferencji, bez osobnego modelu nagrody. Biblioteka TRL od Hugging Face, której używam, ma osobne trenery dla SFT, DPO, GRPO, modelowania nagrody i destylacji. OpenAI w swojej dokumentacji ograniczał reinforcement fine-tuning do modeli rozumujących i zaznaczał, że eksperci oceniający muszą zgadzać się co do idealnej odpowiedzi. Ten warunek dotyczy każdej metody RL: jeśli dwóch Twoich specjalistów oceni tę samą odpowiedź różnie, model nie ma czego się nauczyć.

LoRA czy pełny fine-tuning

LoRA trenuje małe macierze dołączone do zamrożonego modelu, a QLoRA dodatkowo przechowuje model bazowy w 4 bitach. Autorzy QLoRA (Dettmers i in., NeurIPS 2023) pokazali, że w ten sposób da się dostroić model 65B na jednym GPU z 48 GB pamięci przy zachowaniu jakości pełnego 16-bitowego treningu w ich testach. Praca „LoRA Learns Less and Forgets Less” (Biderman i in., TMLR 2024) dodaje ważny niuans: w programowaniu i matematyce LoRA uczyła się nowych umiejętności wyraźnie słabiej niż pełny fine-tuning, ale lepiej zachowywała ogólne zdolności modelu. Dla firmowych zadań, w których chodzi o format i styl, a nie o nową dziedzinę wiedzy, to korzystny kompromis.

Audyt danych treningowych – co sprawdzam, zanim cokolwiek trafi do treningu

Model po fine-tuningu powtarza wzorce z danych, także błędy, sprzeczności i dane osobowe. Dlatego zanim przygotuję plik treningowy, przechodzę przez listę kontrolną pochodzenia, jakości i ryzyka danych.

Lista kontrolna

  • Pochodzenie i podstawa prawna: skąd pochodzą przykłady (helpdesk, maile, dokumenty) i czy firma może ich użyć do treningu. Przy danych osobowych potrzebna jest podstawa z RODO, często także DPIA.
  • Dane osobowe w treści: usuwam lub zastępuję nazwiska, adresy, numery telefonów, PESEL i numery kont, zanim tekst trafi do treningu.
  • Spójność oznaczeń: na próbce sprawdzam, czy dwie osoby oznaczyłyby przykład tak samo. Jeśli nie, najpierw ustalamy zasady, potem trenujemy.
  • Aktualność: stare ceny, wycofane produkty i nieobowiązujące procedury usuwam, bo model nauczy się ich jako wzorca.
  • Duplikaty i przecieki: usuwam prawie identyczne przykłady i pilnuję, żeby podobne przypadki nie trafiły jednocześnie do zbioru treningowego i testowego. Zbiór testowy dzielę według czasu lub klienta, a nie losowo.
  • Pokrycie przypadków granicznych: rzadkie, ale ważne sytuacje (reklamacja z groźbą sądu, pytanie poza zakresem) muszą mieć własne przykłady, w tym przykłady odmowy.
  • Dane syntetyczne: gdy uzupełniam zbiór przykładami wygenerowanymi przez inny model, sprawdzam warunki dostawcy. Warunki korzystania z usług OpenAI zabraniają na przykład używania wyników do rozwijania modeli konkurujących z OpenAI; czy dotyczy to danego projektu, ocenia prawnik klienta.
  • Format zgodny z modelem: przykłady zapisuję w szablonie czatu, którego używa wybrany model bazowy; inny szablon przy treningu i przy inferencji to częsta przyczyna słabych wyników.

Dlaczego dane osobowe są w treningu większym problemem niż w RAG

Modele potrafią zapamiętywać fragmenty danych treningowych. Carlini i in. (USENIX Security 2021) wydobyli z modelu GPT-2 setki dosłownych fragmentów tekstu treningowego, w tym imiona i nazwiska, numery telefonów i adresy e-mail, mimo że część z nich występowała w danych tylko w jednym dokumencie. Z RAG usuwa się konkretny fragment z indeksu; z wag modelu danych nie da się po prostu wyjąć, trzeba trenować ponownie na oczyszczonym zbiorze. Dlatego anonimizację robię przed treningiem, a nie po nim. Praktyczne zasady pracy z danymi osobowymi w projektach AI opisuję w artykule RODO a AI w praktyce, a porządkowanie danych przed jakimkolwiek wdrożeniem w tekście Przygotowanie danych pod AI.

Ewaluacja modelu po fine-tuningu – trzy modele, jeden zestaw testowy

O tym, czy trening się udał, decyduje porównanie na zestawie testowym zamrożonym przed treningiem. Zawsze porównuję trzy warianty: model bazowy z najlepszym promptem, model po fine-tuningu i duży model z chmury z tym samym promptem jako punkt odniesienia dla jakości i kosztu.

Spadek straty (loss) na wykresie treningu nie mówi, czy model jest lepszy w Twoim zadaniu. Mówi tylko, że coraz lepiej odtwarza zbiór treningowy, co przy zbyt długim treningu oznacza przeuczenie. Dlatego decyzje podejmuję na podstawie metryk zadania, a nie krzywych treningu.

Metryki zależne od typu zadania

Typ zadaniaGłówna metrykaCo dodatkowo sprawdzam
Klasyfikacja i routingTrafność i F1 dla każdej klasy osobnoMacierz pomyłek: które kategorie się mylą i ile kosztuje każda pomyłka
Ekstrakcja danych z dokumentówPrecyzja i kompletność na poziomie pojedynczych pólOdsetek poprawnych technicznie JSON-ów i zachowanie przy brakującym polu
Generowanie w stylu firmyŚlepe porównanie parami przez specjalistów firmyOcena modelu-sędziego skalibrowana na próbce ocen ludzi
Każde zadanieZestaw regresji: pytania ogólne i przypadki odmowyCzy model nie stracił ogólnych umiejętności i nie przestał odmawiać tam, gdzie powinien
Każde zadanieCzas odpowiedzi i koszt na 1000 zapytańPomiar pod obciążeniem zbliżonym do produkcyjnego

Progi akceptacji ustalam z klientem przed treningiem, na przykład: model po fine-tuningu musi mieć co najmniej taki wynik jak duży model z chmury w głównej metryce i nie gorszy wynik w zestawie regresji. Klient dostaje raport z wynikami wszystkich trzech wariantów, także wtedy, gdy wygrywa wariant bez treningu. Metodę oceny modelem-sędzią opisuję w artykule Ewaluacja LLM – LLM-as-a-judge, a włączenie testów do procesu wdrożeń w tekście Jak pisać testy dla aplikacji AI.

Koszt fine-tuningu i kiedy własny model się zwraca

Projekt fine-tuningu zaczyna się u mnie od 9 100 zł, ale o opłacalności decyduje koszt utrzymania modelu, a nie jednorazowy trening. Sam trening adaptera LoRA to zwykle najmniejsza pozycja; najwięcej kosztują przygotowanie danych, ewaluacja i serwer, który działa przez cały czas.

Z czego składa się cena projektu

  • Przygotowanie danych: eksport, anonimizacja, czyszczenie i oznaczanie przykładów. Im bardziej rozproszone i niespójne dane, tym więcej pracy.
  • Ewaluacja: budowa zestawu testowego, kalibracja oceny i porównanie trzech wariantów.
  • Trening i iteracje: liczba podejść zależy od tego, jak szybko model przechodzi progi.
  • Wdrożenie: serwer inferencji, API, uwierzytelnianie, monitoring i dokumentacja dla zespołu.

Jak liczę próg opłacalności własnego modelu

  1. Liczę obecny miesięczny koszt API: liczba zapytań razy średnia liczba tokenów wejścia i wyjścia razy cena modelu. Najpierw sprawdzam, ile da się obniżyć cache, trybem wsadowym i tańszym modelem, bo to porównanie z najlepszą wersją API, a nie z obecną.
  2. Liczę koszt własnego modelu: GPU przez wszystkie godziny, w których model musi być dostępny (przy obsłudze klientów zwykle całą dobę), plus czas na utrzymanie, monitoring i ponowne treningi.
  3. Porównuję oba koszty przy obecnym wolumenie i przy wolumenie za rok. Serwer GPU kosztuje tyle samo, gdy jest zajęty i gdy stoi, więc przy małym ruchu API prawie zawsze wygrywa.
  4. Doliczam wartości, których nie widać w fakturze: wymóg, żeby dane nie opuszczały firmy, i niezależność od wycofywania modeli przez dostawcę.

Ekonomikę zmienia jeszcze jedna rzecz: na jednym modelu bazowym można obsługiwać kilka adapterów LoRA. Dokumentacja vLLM opisuje dobór adaptera dla każdego zapytania osobno, więc jeden serwer może obsługiwać klasyfikację zgłoszeń, ekstrakcję z faktur i generowanie odpowiedzi, każde z własnym adapterem. Sposoby obniżania kosztów API, z którymi zawsze porównuję własny model, opisuję w artykule Optymalizacja kosztów API modeli AI.

Wdrożenie i utrzymanie modelu po fine-tuningu

Wytrenowany model udostępniam przez API zgodne z OpenAI, żeby aplikacja mogła przejść na niego przez zmianę adresu i nazwy modelu. Po starcie model wymaga monitoringu i planu ponownego treningu, bo zmieniają się dane wejściowe, oferta firmy i dostępne modele bazowe.

Co wchodzi w skład wdrożenia

  • Serwer inferencji: vLLM lub TGI; adapter LoRA ładowany do modelu bazowego albo scalony z nim, zależnie od tego, ile adapterów ma działać na jednym serwerze.
  • Kwantyzacja do inferencji: mniejsza precyzja wag pozwala zmieścić model na tańszym GPU; jej wpływ na jakość sprawdzam tym samym zestawem testowym.
  • Wersjonowanie: każda wersja modelu ma przypisany zbiór treningowy, konfigurację i wynik ewaluacji. Dzięki temu da się wrócić do poprzedniej wersji w kilka minut.
  • Wdrożenie stopniowe: nowa wersja dostaje najpierw część ruchu, a pełny ruch dopiero po porównaniu wyników z poprzednią.
  • Bezpieczeństwo: uwierzytelnianie, limity zapytań i logi, bez zapisywania danych osobowych tam, gdzie nie są potrzebne.

Kiedy trenuję ponownie

  • Zmienia się format wyjścia, lista kategorii lub styl komunikacji firmy.
  • Cotygodniowa próbka odpowiedzi z produkcji oceniana według tej samej rubryki co w ewaluacji pokazuje spadek jakości.
  • Pojawia się wyraźnie lepszy model bazowy. Adapter LoRA działa tylko z modelem, na którym go wytrenowano, więc zmiana bazy oznacza nowy trening na tym samym zbiorze i nowe porównanie.

Metryki, tracing i alerty dla aplikacji LLM opisuję szerzej w artykule Monitoring AI na produkcji. Gdy model ma być częścią większego systemu z backendem, kolejkami i integracjami, to zakres usługi programowanie systemów AI.

Fine-tuning a AI Act i licencje – kiedy stajesz się dostawcą modelu

Typowy fine-tuning metodą LoRA nie czyni firmy dostawcą modelu ogólnego przeznaczenia w rozumieniu AI Act. Obowiązki wynikają jednak z tego, do czego model jest używany, oraz z licencji modelu bazowego.

Komisja Europejska w wytycznych dla dostawców modeli AI ogólnego przeznaczenia (18 lipca 2025) przyjęła prosty próg: podmiot, który modyfikuje taki model, staje się jego dostawcą, jeśli moc obliczeniowa użyta do modyfikacji przekracza jedną trzecią mocy użytej do wytrenowania oryginalnego modelu. Trening adaptera na kilku tysiącach przykładów jest bardzo daleko od tego progu. Nie zwalnia to z obowiązków wynikających z zastosowania: model, który ocenia kandydatów do pracy albo zdolność kredytową, podlega wymogom dla systemów wysokiego ryzyka niezależnie od tego, czy był trenowany.

Co przekazuję klientowi po projekcie

  • Wagi adaptera lub scalonego modelu (przy otwartych modelach).
  • Zbiór treningowy, zestaw ewaluacyjny i skrypty treningowe, żeby trening można było powtórzyć bez mnie.
  • Raport z ewaluacji z wynikami wszystkich porównywanych wariantów.
  • Notatkę o obowiązkach licencyjnych modelu bazowego, np. oznaczenie „Built with Llama” i nazwę modelu przy modelach Llama.

Szerzej o obowiązkach firm wynikających z AI Act piszę w artykule AI Act w praktyce.

Co przygotować przed projektem fine-tuningu – lista dla firmy

Najszybciej idą projekty, w których firma przed startem potrafi pokazać zadanie na przykładach i wskazać osobę, która oceni wyniki. Bez tego pierwsze tygodnie schodzą na ustalanie, czym jest dobra odpowiedź.

  1. Opis zadania i 20–30 wzorcowych odpowiedzi przygotowanych lub zatwierdzonych przez specjalistę.
  2. Dostęp do danych historycznych (eksport z helpdesku, CRM lub archiwum dokumentów) i informacja, które z nich są aktualne.
  3. Obecny prompt i przykłady, w których model zawodzi, jeśli firma już korzysta z AI.
  4. Szacunek wolumenu: liczba zapytań dziennie teraz i za rok oraz wymagany czas odpowiedzi.
  5. Wymagania dotyczące danych i hostingu: czy dane mogą trafić do chmury, czy model musi działać na własnych serwerach.
  6. Osoba po stronie firmy z czasem na ocenę wyników testów w kolejnych iteracjach.

Jeśli nie wiesz jeszcze, czy firma ma dane i procesy gotowe na taki projekt, dobrym pierwszym krokiem jest audyt gotowości na AI. Gdy model ma nie tylko odpowiadać, ale też wykonywać zadania w systemach, to zakres usługi agenci AI dla firm. Szerszy obraz automatyzacji, w tym wybór procesów i koszty, opisuję na stronie AI i automatyzacja, a techniczne szczegóły treningu QLoRA z kodem w artykule Fine-tuning LLM na danych firmy.

Najczęstsze pytania

Ile danych treningowych potrzebuję?

Minimum 100–500 wysokiej jakości przykładów do podążania za instrukcjami lub adaptacji stylu. Dla złożonych zadań rozumowania 1000–10 000 przykładów daje najlepsze rezultaty. Jakość zawsze bije ilość — mniejszy, czysty zestaw danych przewyższa duży, zaszumiony.

Kiedy wybrać fine-tuning zamiast RAG?

Fine-tuning gdy model musi stosować specyficzny format wyjściowy, pisać w konkretnym stylu lub wykonywać zadanie, z którym model bazowy sobie nie radzi. RAG gdy potrzebujesz dokładnego wyszukiwania konkretnych faktów z bazy wiedzy. Wiele systemów produkcyjnych używa obu razem.

O ile tańszy jest lokalny model od dużego modelu w API?

Przy dużym, stałym wolumenie zwykle wyraźnie tańszy, bo płacisz za serwer GPU, a nie za każdy token. Self-hosted model 7B na jednym A100 obsługuje 1000+ tokenów/sekundę. Dokładna różnica zależy od cennika wybranego modelu w API, wolumenu i wykorzystania GPU — liczę ją na Twoich danych przed decyzją, bo przy małym wolumenie API bywa tańsze.

Czym jest custom LLM i kiedy firma potrzebuje dedykowanego modelu AI?

Custom LLM to model językowy wytrenowany (fine-tuning) na własnych danych firmy — dokumentach, historiach rozmów, specyficznym słownictwie domeny. Dedykowane modele AI dla przedsiębiorstw są potrzebne gdy: (1) standardowe LLM nie rozumieją specjalistycznej terminologii, (2) firma przetwarza wrażliwe dane, które nie mogą opuszczać infrastruktury, (3) koszty API rosną powyżej 4 300 zł/mies. Fine-tuning w chmurze dostawcy nadal oferuje m.in. Google (modele Gemini w Vertex AI), ale OpenAI wygasza samoobsługowy fine-tuning: od 7 maja 2026 r. nie jest dostępny dla nowych organizacji, a od 6 stycznia 2027 r. nie da się tworzyć nowych zadań treningowych. Dlatego najczęściej pracuję na modelach otwartych.

Na jakiej infrastrukturze uruchomisz model?

Na Twoich serwerach z GPU, w prywatnej chmurze (np. AWS, GCP) lub u wyspecjalizowanych dostawców GPU. Model udostępniam przez API zgodne z OpenAI, więc aplikacje mogą z niego korzystać bez dużych zmian.

Czy model po fine-tuningu będzie moją własnością?

Przy treningu otwartych modeli (np. Llama, Mistral) wytrenowane wagi należą do Ciebie i możesz je uruchomić na własnej infrastrukturze. Przy fine-tuningu przez API dostawcy model pozostaje na jego platformie.

Ile kosztuje fine-tuning LLM?

Projekt zaczyna się od 9 100 zł. Cena zależy od przygotowania danych, wielkości modelu, liczby iteracji treningu i sposobu wdrożenia.

Masz projekt?

Przerwij
Ciszę

Zainicjuj protokół. Nawiąż połączenie. Zbudujmy coś głośnego.

> OCZEKIWANIE_NA_SYGNAŁ...