WRÓĆ DO Pozycjonowanie Stron i SEO Techniczne

Wdrażanie Schema.org

Implementacja JSON-LD (Schema.org) generująca Rich Snippets: gwiazdki, ceny, FAQ, breadcrumbs. Widoczność w SERP wzrasta o 20–40% CTR bez zmiany pozycji.

Autor: Paweł Wiszniewski · Aktualizacja:

W skrócie

Implementacja JSON-LD (Schema.org) generująca Rich Snippets: gwiazdki, ceny, FAQ, breadcrumbs. Widoczność w SERP wzrasta o 20–40% CTR bez zmiany pozycji.

  • ›Rich Snippets w Google: gwiazdki recenzji, ceny produktów, stany magazynowe, FAQ bezpośrednio w wynikach wyszukiwania
  • ›Wzrost CTR o 20–40% dzięki wizualnemu wyróżnieniu w SERP
  • ›Zgodność z wytycznymi Google Rich Results Test i Schema Markup Validator

Cena: od 1 800 zł

SZCZEGÓŁY USŁUGI

Wdrażam zaawansowane ustrukturyzowane dane Schema.org w JSON-LD dla każdego typu strony: Product (gwiazdki, ceny, stan magazynowy), FAQPage (akordeony bezpośrednio w wynikach), Article (autor, data, miniatura), LocalBusiness i Organization. Wynik: Twoje wyniki w Google zajmują więcej miejsca na ekranie, wyróżniają się wizualnie i generują 20–40% wyższy CTR bez zmiany pozycji rankingowej.

› INVESTMENT:

od 1 800 zł
const module = new ExecutionProtocol();

// Initializing wdrazanie-schema-org...
› Loading dependencies... OK
› Establishing connection... OK
› Ready for deployment... AWAITING_COMMAND

Paweł Wiszniewski · moje podejście

Co robię inaczej

Większość wdrożeń schema to wtyczka, która dodaje kilka niezależnych bloków JSON-LD, często sprzecznych ze sobą. Ja buduję dane strukturalne jako jeden graf ze stałymi identyfikatorami @id: firma, autor, strona, usługa i artykuł wskazują na siebie nawzajem, dzięki czemu Google i modele AI widzą spójną encję. Tak samo zbudowany jest ten serwis — jedna encja autora, do której odwołują się wszystkie artykuły i usługi. Pilnuję też zasady, której wtyczki nie pilnują: dane strukturalne muszą odpowiadać temu, co widać na stronie.

Case study: Fashion Brand SEO/GEO

Moje zdanie i przykład z rynku

Moje zdanie

Uważam, że dane strukturalne przestały być sposobem na gwiazdki i ozdobniki w wynikach, a stały się słownikiem dla maszyn. Dziś wdrażam je przede wszystkim po to, żeby Google i modele AI jednoznacznie zrozumiały, kim jesteś i co sprzedajesz.

Z rynku

W sierpniu 2023 r. Google ograniczył wyniki rozszerzone FAQ do autorytatywnych serwisów rządowych i medycznych, a HowTo do wersji desktopowej. Tysiące stron z dnia na dzień straciły rozwijane pytania pod wynikiem. Ci, którzy wdrażali schema tylko dla efektu wizualnego, stracili wszystko; ci, którzy budowali spójną encję, nie stracili nic.

Źródła: Google Search Central: zmiany w wynikach FAQ i HowTo (2023)

Dla kogo jest ta usługa

  • Sklepy, które chcą pokazywać w Google ceny, dostępność i oceny produktów.
  • Firmy usługowe i lokalne budujące wiarygodność marki w wynikach wyszukiwania.
  • Wydawcy i blogi, które chcą, żeby Google i AI poprawnie rozumiały autora i datę.
  • Strony z danymi strukturalnymi, które generują błędy w Search Console.

Co dokładnie dostajesz

  • Audyt obecnych danych strukturalnych i błędów w Search Console.
  • Plan typów schema dla każdego szablonu: Organization, Product, Article, FAQ, Breadcrumb i inne.
  • Wdrożenie JSON-LD jako spójnego grafu ze stabilnymi identyfikatorami @id.
  • Walidację w Rich Results Test i Schema Markup Validator.
  • Dokumentację, jak utrzymać dane przy dodawaniu nowych stron.

Jak mierzę efekty

  • Liczba stron z prawidłowymi danymi w raportach Search Console.
  • Wyświetlenia i CTR wyników rozszerzonych.
  • Liczba błędów i ostrzeżeń w danych strukturalnych.
  • Poprawność informacji o marce w panelu wiedzy i odpowiedziach AI.

Dlaczego warto?

Rich Snippets w Google: gwiazdki recenzji, ceny produktów, stany magazynowe, FAQ bezpośrednio w wynikach wyszukiwania — wyróżnienie na tle konkurencji bez zmiany pozycji.

Wzrost CTR o 20–40% dzięki wizualnemu wyróżnieniu w SERP — więcej klikalności z tego samego miejsca w rankingu, więcej ruchu bez dodatkowych kosztów.

Zgodność z wytycznymi Google Rich Results Test i Schema Markup Validator — wdrażam poprawnie walidujące schematy, które Google faktycznie wyświetla.

Schematy dla wszystkich typów stron: Product, FAQPage, Article, BreadcrumbList, Organization, LocalBusiness, Event, Course — dostosowane do Twojego modelu biznesowego.

Wsparcie dla GEO (Generative Engine Optimization) — schematy JSON-LD są kluczowym sygnałem dla modeli językowych (np. w ChatGPT i Gemini), które rozumieją dane strukturalne lepiej niż zwykły tekst.

Jak to działa?

1

Audyt obecnych danych strukturalnych

Sprawdzam co jest już wdrożone, weryfikuję poprawność w Google Rich Results Test i Bing Webmaster Tools, identyfikuję typy stron z największym potencjałem dla Rich Snippets.

2

Projekt architektury schematu

Definiuję schematy JSON-LD dla każdego typu strony, planuję hierarchię Organization/WebSite/WebPage i implementuję sameAs do powiązania z encjami Knowledge Graph.

3

Implementacja JSON-LD

Wdrażam schematy w kodzie strony (lub konfiguracji CMS), testuję każdy typ schematu w Rich Results Test Google i walidatorem Schema.org.

4

Monitorowanie w Search Console

Konfiguruję monitoring Rich Results w Google Search Console, weryfikuję pojawienie się Rich Snippets w wynikach i naprawiam ewentualne błędy zgłaszane przez Google.

Najczęstsze błędy

  • Dodawanie schema z ocenami lub FAQ, których nie ma w widocznej treści — ryzyko ręcznej kary.
  • Kilka obiektów Organization lub Person o różnych nazwach i adresach na jednej stronie.
  • Wdrożenie przez wtyczkę bez walidacji po każdej aktualizacji szablonu.
  • Liczenie na gwiazdki w wynikach dla typów, dla których Google już ich nie pokazuje.

Kiedy ta usługa nie ma sensu

  • Strona ma kilka statycznych podstron bez produktów, artykułów i usług — podstawowe Organization wystarczy.
  • Platforma nie pozwala na edycję kodu ani nagłówka strony.
  • Oczekujesz, że same dane strukturalne podniosą pozycje — to sygnał pomocniczy, nie czynnik rankingowy.
/// PORADNIK

Wdrażanie Schema.org – jak projektuję i wdrażam dane strukturalne krok po kroku

Ten poradnik pokazuje, jak wygląda wdrożenie danych strukturalnych od środka: jakie typy przypisuję do jakich szablonów, skąd biorą się wartości w JSON-LD, jak testuję poprawność i jak mierzę efekt. Ogólne wprowadzenie do Schema.org i listę wycofanych wyników rozszerzonych znajdziesz w moim przewodniku po danych strukturalnych. Tutaj skupiam się na tym, co robię w projekcie.

Co realnie dają dane strukturalne w 2026 roku

Dane strukturalne dają uprawnienie do wyników rozszerzonych i jednoznaczny opis encji dla maszyn. Nie dają gwarancji wyświetlenia ani wyższej pozycji. O tym, czy gwiazdki lub cena faktycznie pojawią się w wynikach, decyduje Google, nawet gdy test przechodzi bez błędów.

Google na stronie wprowadzającej do danych strukturalnych publikuje kilka studiów przypadku: Rotten Tomatoes po oznaczeniu 100 000 stron zmierzył o 25% wyższy CTR stron z wynikami rozszerzonymi, a Nestlé podał o 82% wyższy CTR stron wyświetlanych jako wynik rozszerzony w porównaniu ze zwykłymi wynikami. To dane z materiałów Google, zebrane na dużych serwisach i dla typów, które dają widoczny dodatek w wynikach. Traktuję je jako dowód, że efekt istnieje, a nie jako prognozę dla konkretnej strony.

Druga korzyść jest mniej widowiskowa, ale trwalsza: spójny opis firmy, autora, produktów i usług, który wyszukiwarka może połączyć z resztą swojej wiedzy. Ta część nie znika, gdy Google wycofuje kolejny typ wyniku rozszerzonego, co w ostatnich latach zdarzało się regularnie.

Czego się nie spodziewać

  • Wzrostu pozycji tylko dzięki markupowi. Według ogólnych wytycznych Google ręczne działanie za dane strukturalne odbiera uprawnienie do wyników rozszerzonych, ale nie wpływa na ranking strony. Działa to w obie strony: sam markup rankingu też nie podnosi.
  • Rozwijanych pytań FAQ pod wynikiem na zwykłej stronie firmowej. Od 2023 roku Google pokazuje je tylko autorytatywnym serwisom rządowym i medycznym.
  • Gwiazdek z opinii o własnej firmie na stronie głównej lub stronie usługi. Gwiazdki działają dla produktów i kilku innych typów, nie dla recenzji „o sobie”.

Mapa szablonów: który typ Schema.org na której stronie

Dane strukturalne planuję per szablon, nie per adres. Sklep z 20 000 produktów ma zwykle kilka do kilkunastu szablonów i to one decydują o jakości wdrożenia. Pierwszym dokumentem w projekcie jest tabela, w której każdy szablon ma przypisane typy, właściwości i źródło danych.

SzablonTypyKluczowe właściwościSkąd biorę wartości
Strona głównaWebSite, Organization (lub podtyp, np. OnlineStore, ProfessionalService)name, url, logo, sameAs, contactPointUstawienia globalne serwisu
O nas, strona autoraAboutPage lub ProfilePage, Personname, jobTitle, worksFor, sameAs, imageProfil autora w CMS
Artykuł, wpisBlogPosting lub Article, BreadcrumbListheadline, author (@id), datePublished, dateModified, imagePola wpisu, data realnej edycji
Kategoria sklepuCollectionPage, BreadcrumbListname, breadcrumb, hasPart lub lista produktówDrzewo kategorii
Karta produktuProduct lub ProductGroup, Offer, AggregateRatingsku, gtin, brand, price, priceCurrency, availabilityBaza produktów, ta sama co dla feedu
Strona usługiService, WebPageprovider (@id firmy), areaServed, offersDane usługi i cennik
Lokalizacja, oddziałLocalBusiness (lub podtyp)address, geo, openingHoursSpecification, telephoneDane oddziału, zgodne z wizytówką Google
Zwroty i dostawaOrganization z hasMerchantReturnPolicy i polityką wysyłkireturnPolicyCategory, merchantReturnDays, koszty i czasy dostawyRegulamin sklepu
Wydarzenie, oferta pracy, wideoEvent, JobPosting, VideoObjectKomplet pól wymaganych przez Google dla typuModuł wydarzeń, ATS, biblioteka wideo

Ta tabela od razu pokazuje luki. Najczęściej brakuje kolumny „skąd biorę wartości”: ktoś wpisał w szablonie stałą cenę albo datę i od tamtej pory dane strukturalne mówią co innego niż strona.

Graf JSON-LD i stabilne identyfikatory @id

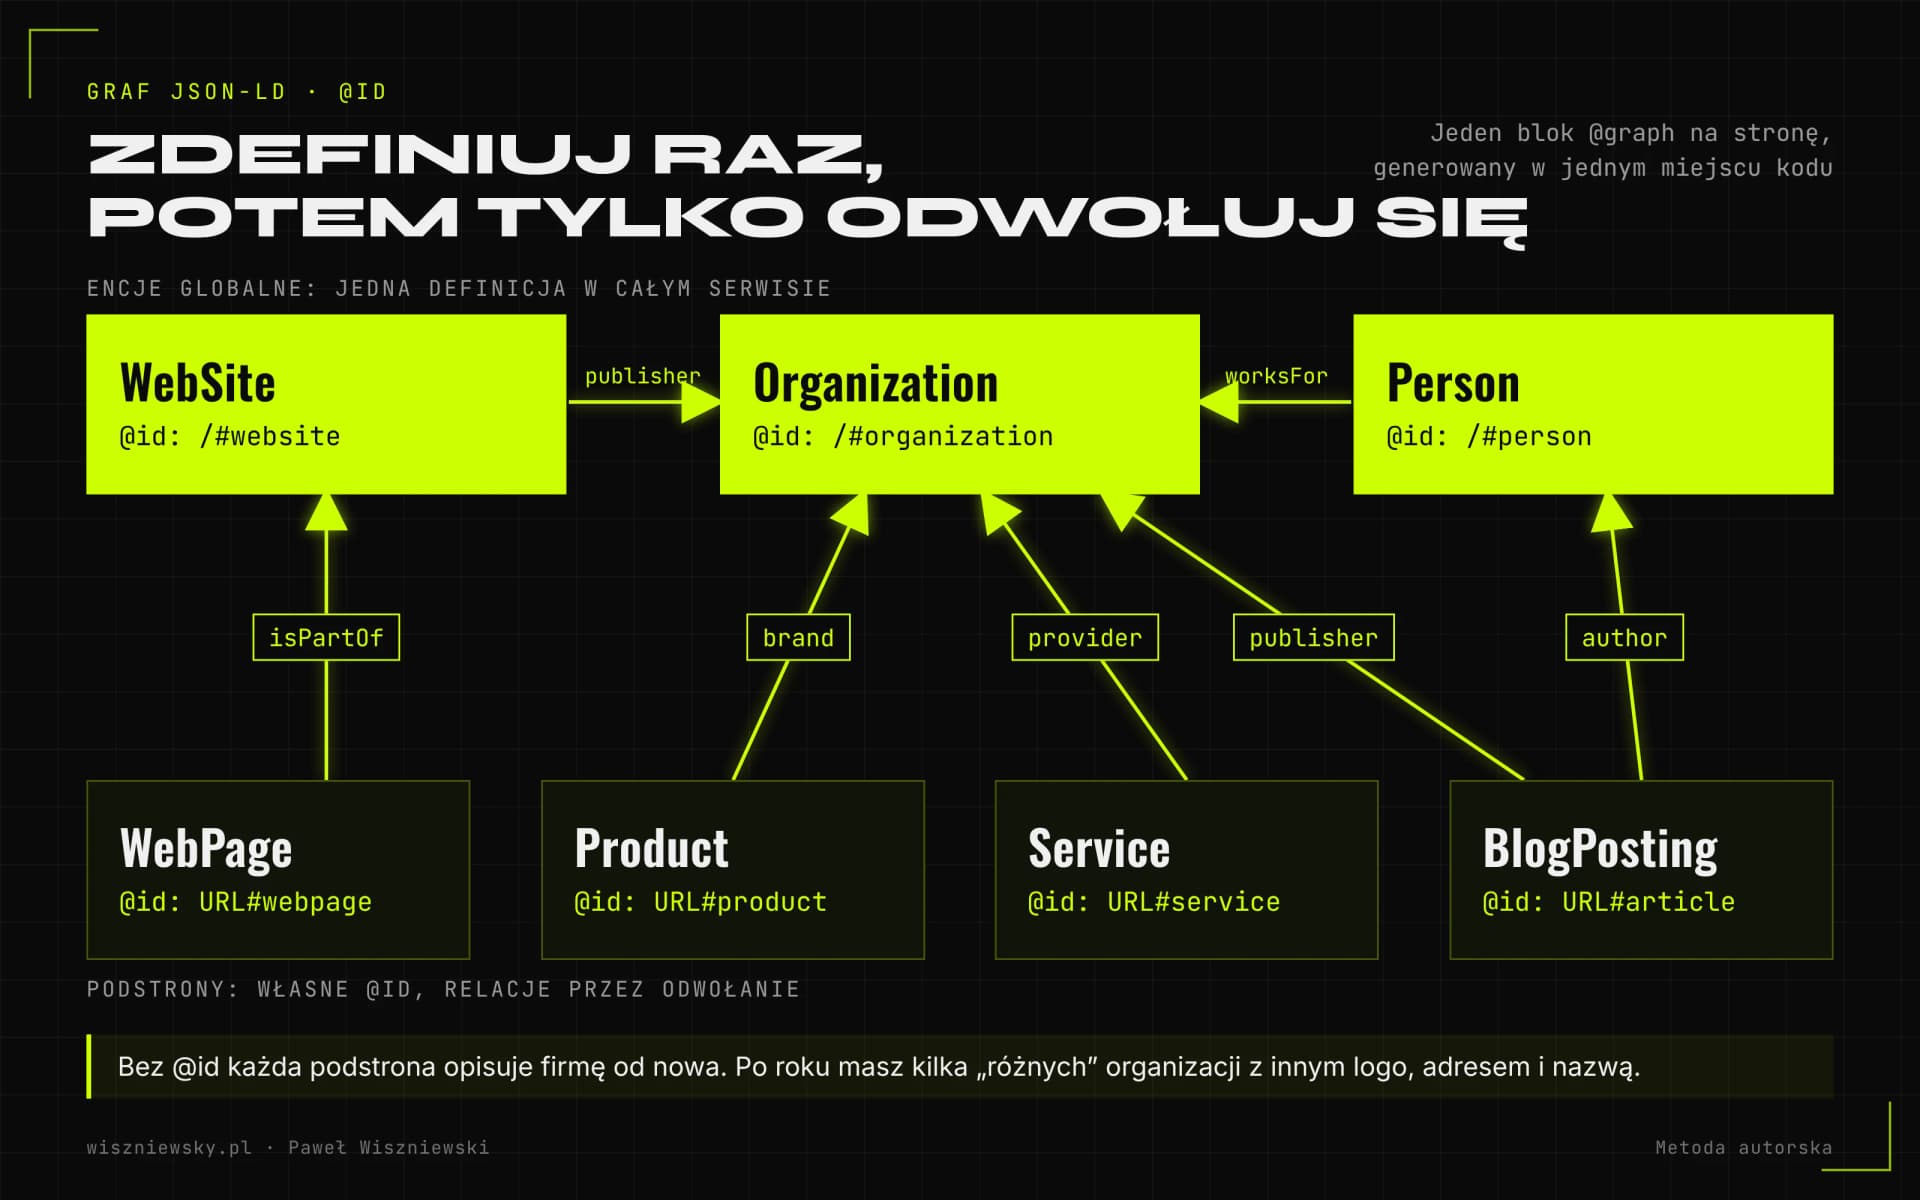
Wszystkie bloki JSON-LD na stronie traktuję jako jeden graf, w którym każda encja ma stały identyfikator @id i jest zdefiniowana raz. Strony odwołują się do firmy, autora i serwisu przez @id, zamiast za każdym razem opisywać je od nowa, często z różnymi danymi.

Schemat grafu JSON-LD: WebSite, Organization i Person zdefiniowane raz z identyfikatorami @id, a WebPage, BlogPosting, Product i Service odwołują się do nich przez publisher, author, provider i brand.
Encje globalne definiuję raz, a każda podstrona tylko się do nich odwołuje. Dzięki temu cały serwis opisuje jedną firmę i jednego autora.

Konwencje, których się trzymam

  • @id to adres kanoniczny z fragmentem, np. https://twojadomena.pl/#organization dla firmy i adres artykułu z #article dla wpisu. Identyfikator nie musi prowadzić do istniejącej kotwicy, ale nie może się zmieniać.
  • Encje globalne (WebSite, Organization, Person) mają jedną definicję w całym serwisie. Ten serwis działa tak samo: jest jedna encja autora https://wiszniewsky.pl/#person, a artykuły, usługi i kursy tylko się do niej odwołują.
  • Relacje zamiast powtórzeń: author, publisher, provider, brand, worksFor i founder wskazują @id, a nie wklejoną kopię obiektu.
  • Wersje językowe: encje globalne zostawiam z tym samym @id we wszystkich językach, bo to wciąż ta sama firma i ta sama osoba. Strony i artykuły mają własne @id oraz inLanguage.
  • sameAs tylko do profili, które naprawdę należą do encji: LinkedIn, Wikidata, rejestr firm, profile w serwisach branżowych. Bez katalogów firm, w których wpis założył ktoś inny.
  • Jeden blok @graph na stronę, generowany w jednym miejscu kodu. Dwa źródła markupu, np. motyw i wtyczka, prawie zawsze kończą się dwiema sprzecznymi organizacjami.

Graf jest też fundamentem pracy nad encją marki. Jeśli celem jest panel wiedzy albo poprawne informacje o firmie w odpowiedziach AI, zaczynam od niego i rozbudowuję go w usłudze inżynierii grafu wiedzy. Więcej o samych encjach piszę w artykule Entity SEO i graf wiedzy.

Skąd biorą się wartości w JSON-LD: jedno źródło z treścią strony

Wartości w danych strukturalnych muszą pochodzić z tego samego źródła co treść widoczna na stronie. Wytyczne Google zabraniają oznaczania treści, której użytkownik nie widzi, a najczęstszą przyczyną niezgodności nie jest zła wola, tylko dwie kopie tych samych danych, które z czasem się rozjeżdżają.

Google pisze to wprost nawet przy wdrożeniach przez Google Tag Manager: wartości należy pobierać ze strony zmiennymi, a nie przepisywać ich do kontenera, bo duplikat zwiększa ryzyko rozbieżności. W kodzie stosuję tę samą zasadę: komponent, który wyświetla cenę, i funkcja, która buduje Offer, korzystają z jednego obiektu produktu.

Pola, które najczęściej się rozjeżdżają

  • Cena i dostępność po promocji, zmianie stanu magazynowego albo wyprzedaniu wariantu.
  • dateModified ustawiane automatycznie przy każdym zapisie, także przy poprawce literówki. Datę modyfikacji zmieniam tylko przy istotnej zmianie treści.
  • Oceny i liczba opinii pobierane z widżetu zewnętrznego, które na stronie pokazują inną liczbę niż w JSON-LD.
  • Autor, gdy tekst przejął inny redaktor, a markup nadal wskazuje poprzednią osobę.
  • Godziny otwarcia oddziału zmienione w wizytówce Google, ale nie na stronie.

W sklepach dochodzi trzecie miejsce, które musi się zgadzać: feed produktowy w Merchant Center. Dane na karcie produktu, w JSON-LD i w feedzie powinny pochodzić z jednej bazy. Ta sama zasada obowiązuje przy sprzedaży przez agentów AI, o której piszę w artykule o zakupach przez agentów AI i feedach produktowych.

Wdrożenie w Next.js, WordPressie i Shopify

Najpewniejsze jest JSON-LD w HTML-u zwracanym przez serwer. Google potrafi odczytać dane strukturalne dodane JavaScriptem, ale w dokumentacji ostrzega, że dynamicznie generowany markup produktów może sprawić, że crawle zakupowe będą rzadsze i mniej niezawodne. Dlatego przy produktach z często zmienianą ceną unikam wstrzykiwania danych skryptem.

Next.js i własny kod

Buduję funkcje, które z danych strony generują węzły grafu, i renderuję je po stronie serwera w jednym bloku script type="application/ld+json". Encje globalne pochodzą z jednego modułu konfiguracyjnego. Na stronach, które utrzymuję, test w CI przy każdej zmianie sprawdza, czy każdy blok JSON-LD się parsuje. Tak działa ten serwis. Przy przenoszeniu strony ze starego CMS-u buduję graf w ten sposób od początku, w ramach migracji do Next.js.

WordPress

Yoast SEO i Rank Math generują graf z @id, więc zwykle nie ma sensu budować go od zera. Problem pojawia się, gdy motyw, wtyczka sklepu, wtyczka opinii i wtyczka SEO dodają własne bloki. Wtedy wybieram jedno źródło grafu, wyłączam pozostałe, a brakujące typy dopisuję przez filtry wtyczki, żeby trafiły do tego samego grafu, a nie do osobnego bloku.

Shopify

Motywy Shopify często mają wbudowany markup produktu, a aplikacje do opinii lub SEO dodają drugi. Zaczynam od wyrenderowanego HTML-u karty produktu i liczę, ile razy występuje Product. Warianty (rozmiar, kolor) opisuję przez ProductGroup, które Google obsługuje od lutego 2024 roku, z właściwościami hasVariant, variesBy i productGroupID.

Google Tag Manager

Traktuję go jako rozwiązanie przejściowe, gdy nie ma dostępu do kodu. Działa, jeśli wartości są pobierane ze strony, ale dodaje zależność od renderowania i łatwo go zepsuć zmianą układu strony, z której zmienne czytają dane.

Dane strukturalne w sklepie: merchant listings, warianty, zwroty i dostawa

W sklepie markup produktu obsługuje dwa różne wyniki: fragmenty produktów i informacje o produktach sprzedawcy (merchant listings). Google ma dla nich osobne raporty w Search Console, bo wymagania się różnią. Merchant listings dotyczą stron, na których klient może kupić produkt; fragmenty produktów obejmują też recenzje redakcyjne i porównywarki.

ElementCo wdrażamUwagi z dokumentacji Google
Karta produktuProduct z Offer: cena, waluta, dostępność, stan, GTIN lub SKU, markaRaport „Informacje o produktach sprzedawcy” obejmuje strony, na których można kupić produkt
WariantyProductGroup z hasVariant, variesBy i productGroupIDObsługa od lutego 2024 dla wariantów na jednej stronie i na osobnych adresach
Polityka zwrotówMerchantReturnPolicy pod Organization, wyjątki pod OfferPoziom organizacji od czerwca 2024; polityka przy Offer obsługuje tylko część właściwości
DostawaPolityka wysyłki pod Organization, wyjątki przy produkcieOd listopada 2025; ustawienia w Search Console mają pierwszeństwo przed markupem
OpinieAggregateRating i Review dla produktówTylko opinie widoczne na stronie produktu

Od listopada 2025 roku ustawienia „Dostawa i zwroty” w Search Console są dostępne dla każdej witryny, którą Google rozpoznaje jako sklep, a nie tylko dla kont z Merchant Center. Dla mniejszych sklepów to często najszybsza droga. Markup polityk dodaję wtedy, gdy zasady są złożone albo gdy chcę mieć je w kodzie razem z resztą danych. W obu przypadkach pilnuję, żeby ustawienia w Search Console i markup nie mówiły dwóch różnych rzeczy.

Szerzej o widoczności sklepów w Google i w zakupach przez AI piszę w artykule SEO i GEO dla e-commerce.

Walidacja danych strukturalnych: cztery poziomy testów

Poprawny wynik w Rich Results Test to dopiero jeden z czterech testów, które robię. Narzędzia Google sprawdzają składnię i wymagane pola, ale nie sprawdzą, czy cena w JSON-LD zgadza się z ceną na stronie ani czy markup nie zniknie po kolejnym wdrożeniu.

  1. Składnia. Każdy blok musi się parsować jako JSON. Ten test uruchamiam automatycznie przy każdej zmianie kodu, bo jeden przecinek potrafi wyłączyć cały graf na wszystkich stronach szablonu.
  2. Słownik Schema.org. Schema Markup Validator sprawdza typy i właściwości niezależnie od tego, czy Google je wykorzystuje.
  3. Uprawnienie w Google. Rich Results Test na żywym adresie (nie na wklejonym kodzie, bo wtedy test ma ograniczenia JavaScriptu) i Sprawdzenie adresu URL w Search Console, które pokazuje wyrenderowany HTML.
  4. Zgodność z treścią. Na próbce stron z każdego szablonu porównuję wartości w JSON-LD z tym, co widać na stronie: cenę, dostępność, autora, daty, liczbę opinii. Przy dużych sklepach robię to skryptem, który pobiera stronę i porównuje oba źródła.

Po wdrożeniu monitoruję raporty ulepszeń w Search Console. Rosnąca liczba „nieprawidłowych elementów” po aktualizacji motywu albo wtyczki to najczęstszy sygnał, że ktoś zmienił szablon bez sprawdzenia markupu.

Jak mierzę efekty wdrożenia Schema.org

Efekt mierzę w raporcie Skuteczność w Search Console z filtrem „Wygląd w wynikach wyszukiwania”, który pokazuje kliknięcia i CTR wyników z danym typem wyniku rozszerzonego. Porównuję te same zapytania i strony przy podobnej średniej pozycji przed wdrożeniem i po nim, bo zmiana CTR przy zmianie pozycji niczego nie dowodzi.

Co mierzęGdzieNa co uważam
Liczba prawidłowych elementów per typRaporty ulepszeń w Search ConsoleSpadek po wdrożeniach kodu lub aktualizacji wtyczek
Wyświetlenia i CTR wyników rozszerzonychSkuteczność, filtr „Wygląd w wynikach wyszukiwania”Sezonowość i zmiany pozycji w tym samym okresie
CTR szablonu przed i poSkuteczność, filtr stron (np. wszystkie adresy produktów)Porównanie okresów o tej samej długości
Poprawność danych o marceWyniki wyszukiwania marki, panel wiedzy, odpowiedzi asystentów AIZmiany pojawiają się z opóźnieniem i nie zawsze da się je przypisać do markupu

Pierwsze dane oceniam po pełnym cyklu ponownego indeksowania kluczowych szablonów. Przy dużych sklepach Google potrzebuje czasu, żeby ponownie odwiedzić tysiące kart produktów, więc prawidłowe elementy w raportach przyrastają stopniowo.

Dane strukturalne a widoczność w AI: realistyczne oczekiwania

Dane strukturalne nie są warunkiem pojawienia się w AI Overviews, AI Mode ani w ChatGPT. Google w dokumentacji o funkcjach AI zaznacza, że nie ma dodatkowych wymagań technicznych poza zwykłymi zasadami indeksowania, a dostawcy innych asystentów nie potwierdzają, że ich systemy czytają JSON-LD.

Mimo to wdrażam schema z myślą o AI z dwóch powodów. Po pierwsze, spójny graf ułatwia Google połączenie strony z encją firmy, a z indeksu Google korzystają funkcje AI w wyszukiwarce. Po drugie, praca nad markupem wymusza porządek w treści: jasno podany autor, data, cena i zakres usługi pomagają każdemu systemowi, który czyta stronę, także temu, który ignoruje JSON-LD. Jak tę warstwę rozwijam w GEO, opisuję przy usłudze pozycjonowania w AI Overviews i AI Mode.

Osobno sprawdzam, co asystenci AI mówią o firmie. Jeśli podają zły adres, nieaktualną ofertę albo mylą markę z inną, poprawny markup jest jednym z elementów naprawy, ale nie jedynym. Szerzej piszę o tym w artykule Reputacja marki w AI.

Typy wycofane w 2025 i 2026 roku: co zrobić z istniejącym markupem

Markup typów, których Google już nie wyświetla, zwykle zostawiam, jeśli jest poprawny i zgodny z treścią, ale nie wdrażam go od nowa tylko dla wyników rozszerzonych. Google w czerwcu 2025 roku zapowiedział wycofanie siedmiu typów z wyników wyszukiwania: Book Actions, Course Info, Claim Review, Estimated Salary, Learning Video, Special Announcement i Vehicle Listing. Zaznaczył, że zmiana nie wpływa na ranking, a użycie tych typów poza wyszukiwarką Google się nie zmienia.

W listopadzie 2025 roku Google dodał, że od stycznia 2026 usuwa obsługę tych typów z Search Console i jej API. Raporty dla nich znikają, więc ewentualnych błędów nie zobaczysz już w panelu. To kolejny powód, żeby walidacja składni działała w Twoim własnym procesie, a nie tylko w narzędziach Google.

SytuacjaMoja decyzja
Markup poprawny, opisuje widoczną treśćZostawiam; nie szkodzi i opisuje stronę innym systemom
Markup z błędami lub niezgodny z treściąPoprawiam albo usuwam; nie zostawiam błędnych danych
Typ dodany tylko dla efektu w wynikach, bez treści na stronieUsuwam
Wtyczka wciąż generuje wycofany typ na każdej stronieWyłączam, jeśli nie da się go dopasować do treści

Utrzymanie po wdrożeniu: dokumentacja dla zespołu

Dane strukturalne psują się najczęściej przy zmianach, które nie dotyczą SEO: nowy szablon, aktualizacja wtyczki, migracja sklepu. Dlatego częścią wdrożenia jest krótka dokumentacja, z której korzysta zespół, a nie tylko raport dla działu marketingu.

  • Mapa szablonów z typami, właściwościami i źródłem danych (tabela z początku tego poradnika, wypełniona dla Twojego serwisu).
  • Lista identyfikatorów @id encji globalnych i zasada, że nie wolno ich zmieniać.
  • Instrukcja dla nowego szablonu: który moduł generuje graf, jak dodać nowy typ, jak przetestować.
  • Lista zdarzeń, po których trzeba ponownie zwalidować markup: zmiana motywu lub wtyczki, migracja, nowa wersja językowa, zmiana cennika lub regulaminu zwrotów.
  • Właściciel tematu po stronie firmy, który dostaje alerty z Search Console.

Przy migracji serwisu sprawdzam dane strukturalne w tej samej checkliście co przekierowania i canonicale, bo nowy motyw często startuje bez nich. Opisuję to przy usłudze migracji SEO. Jeśli nie wiesz, w jakim stanie jest technika serwisu, punktem wyjścia jest audyt SEO techniczny, a cały kontekst usług SEO znajdziesz na stronie pozycjonowania i SEO technicznego.

Najczęstsze pytania

Po jakim czasie pojawią się gwiazdki w wynikach Google?

Google zazwyczaj wyświetla Rich Snippets po 1–4 tygodniach od wdrożenia i zaindeksowania schematu. Gwiazdki dla recenzji wymagają minimum 5 recenzji widocznych w schemacie.

Czy schema.org wpływa bezpośrednio na pozycje?

Dane strukturalne nie są bezpośrednim czynnikiem rankingowym, ale wyższy CTR z Rich Snippets jest sygnałem behawioralnym dla Google, który pośrednio wpływa na rankingi. Ponadto poprawna hierarchia Organization i sameAs wzmacnia wiedzę LLM o Twojej marce.

Czy możesz wdrożyć schema w WordPress/Shopify?

Tak. W WordPress konfiguruję schematy przez Yoast SEO lub RankMath z rozszerzonymi ustawieniami JSON-LD. W Shopify dodaję je przez edycję motywu lub dedykowane aplikacje. W Next.js implementuję je bezpośrednio w komponentach.

Jakie typy danych strukturalnych mają sens w 2026 roku?

Dla większości firm: Organization, WebSite, Person (autor), Article lub BlogPosting, Product i Offer w sklepach, BreadcrumbList, LocalBusiness dla firm lokalnych i Service dla usług. FAQ i HowTo nie dają już rozszerzonych wyników dla większości stron, ale pomagają w zrozumieniu treści.

Czy dane strukturalne pomagają w widoczności w AI?

Tak, pośrednio. Ułatwiają systemom AI jednoznaczne rozpoznanie firmy, autora, cen i dat, a spójna encja marki zmniejsza ryzyko błędnych informacji w odpowiedziach. Najważniejsze, żeby dane były zgodne z treścią strony.

Ile kosztuje wdrożenie Schema.org?

Wdrożenie zaczyna się od 1 800 zł. Cena zależy od liczby szablonów stron i typów danych oraz od platformy — w Next.js wdrażam w kodzie, w WordPressie i Shopify przez motyw lub aplikację.

Masz projekt?

Przerwij
Ciszę

Zainicjuj protokół. Nawiąż połączenie. Zbudujmy coś głośnego.

> OCZEKIWANIE_NA_SYGNAŁ...