Wdrożenie RAG dla Firm – Baza Wiedzy AI i Wyszukiwanie Wektorowe
Asystent AI odpowiadający wyłącznie na podstawie Twoich wewnętrznych dokumentów — umów, polityk, instrukcji. Każda odpowiedź cytowana, zero halucynacji.
›Odpowiedzi oparte wyłącznie na Twoich dokumentach
›Cytowanie źródeł przy każdej odpowiedzi
›Obsługuję różnorodne formaty dokumentów: PDF, DOCX, Notion, Confluence, Google Docs i zwykły tekst bez żadnej dodatkowej konfiguracji.
Cena: od 6 000 zł
SZCZEGÓŁY USŁUGI
Buduję systemy Retrieval-Augmented Generation (RAG), które dają Twojemu zespołowi asystenta AI opartego wyłącznie na Twoich własnych dokumentach. Wgraj umowy, polityki, instrukcje produktowe lub wewnętrzne wiki — system wyszukiwaniem hybrydowym (wektory + słowa kluczowe) z rerankingiem pobiera najbardziej trafne fragmenty i przekazuje je do LLM, który odpowiada z dokładnym cytatem źródła. Wdrażam i dostrajam bazy wektorowe (Pinecone, Weaviate, Qdrant, pgvector), dobieram strategię podziału dokumentów i mierzę jakość na zestawie testowym przed startem. Przy wdrożeniu self-hosted żadne dane nie opuszczają Twojej infrastruktury.
› INVESTMENT:
od 6 000 zł
constmodule = newExecutionProtocol();
// Initializing wdrozenia-rag... › Loading dependencies... OK › Establishing connection... OK › Ready for deployment... AWAITING_COMMAND
Paweł Wiszniewski · moje podejście
Co robię inaczej
RAG to dla mnie nie hasło, tylko system, który mogę pokazać krok po kroku: w demo Research Agent widać, jak pytanie rozbijane jest na zapytania cząstkowe, jak działa wyszukiwanie w bazie wektorowej i jak powstaje odpowiedź z cytatami. Produkcyjnie zbudowałem m.in. silnik wycen dla generalnego wykonawcy oparty na RAG na 70 historycznych kosztorysach (case study Konkret). Zawsze zaczynam od zestawu testowych pytań i mierzę jakość przed startem — bez tego RAG „działa na demo”, a myli się na produkcji.
Uważam, że o jakości RAG w 80% decyduje wyszukiwanie, a nie model. Firmy wymieniają model na droższy, a problem leży w tym, jak dokumenty zostały podzielone i jak system szuka fragmentów.
Z rynku
Anthropic opublikował wyniki techniki Contextual Retrieval: dodanie kontekstu do fragmentów dokumentów i połączenie wyszukiwania wektorowego z BM25 zmniejszyło liczbę nieudanych wyszukiwań o 49%, a z rerankingiem o 67%. To poprawa uzyskana bez zmiany modelu językowego — dokładnie tam, gdzie zwykle szukam rezerw w systemach RAG.
Firmy, w których pracownicy tracą czas na szukanie informacji w umowach, procedurach i wiki.
Zespoły obsługi i sprzedaży, które potrzebują szybkich, sprawdzonych odpowiedzi o produkcie.
Kancelarie, biura i działy compliance pracujące na dużych zbiorach dokumentów.
Organizacje, które nie mogą wysyłać danych do publicznych narzędzi AI bez kontroli.
Co dokładnie dostajesz
Inwentaryzację źródeł wiedzy i plan, które dokumenty i systemy podłączyć.
Pipeline indeksowania z podziałem dokumentów, embeddingami i aktualizacją przyrostową.
Wyszukiwanie hybrydowe z rerankingiem i odpowiedzi z cytatem źródła.
Kontrolę dostępu: każdy widzi tylko dokumenty, do których ma uprawnienia.
Interfejs czatu lub integrację ze Slackiem, Teams albo intranetem.
Jak mierzę efekty
Trafność wyszukiwania i odpowiedzi na zestawie testowych pytań.
Odsetek odpowiedzi popartych właściwym źródłem.
Czas znalezienia informacji przed i po wdrożeniu.
Liczba aktywnych użytkowników i pytań tygodniowo.
Dlaczego warto?
Odpowiedzi oparte wyłącznie na Twoich dokumentach — AI nie może sfabrykować informacji, których nie ma w Twojej bazie wiedzy.
Cytowanie źródeł przy każdej odpowiedzi — użytkownicy widzą dokładnie, z którego dokumentu i akapitu pochodzi odpowiedź, co umożliwia szybką weryfikację.
Obsługuję różnorodne formaty dokumentów: PDF, DOCX, Notion, Confluence, Google Docs i zwykły tekst bez żadnej dodatkowej konfiguracji.
Warstwa kontroli dostępu — różne role użytkowników odpytują tylko dokumenty, do których są uprawnieni, egzekwowane na poziomie wyszukiwania wektorowego.
Architektura self-hosted — dokumenty i zapytania nigdy nie opuszczają Twoich serwerów; zgodna z RODO, HIPAA i wymogami data governance przedsiębiorstw.
Wyszukiwanie hybrydowe (wektory + BM25) z rerankingiem — system rozumie intencję pytania i dokładną terminologię, a precyzja wyszukiwania przekracza 90% nawet przy milionach dokumentów i opóźnieniu poniżej 100 ms.
Warstwa zapobiegania halucynacjom: ocena pewności i odpowiedź „nie wiem”, gdy w dokumentach nie ma podstawy — zamiast zgadywania.
Jak to działa?
1
Inwentaryzacja dokumentów i strategia chunkowania
Inwentuję Twoje dokumenty i wybieram optymalną strategię podziału na fragmenty — według sekcji, akapitu lub granicy semantycznej — dopasowaną do Twojego typu treści i wzorców zapytań.
2
Konfiguracja bazy wektorowej
Konfiguruję bazę danych wektorowych (Pinecone, Weaviate lub pgvector), definiuję schematy metadanych do filtrowania i indeksuję wszystkie dokumenty z jakościowymi embeddingami.
3
Pipeline wyszukiwania i generowania
Buduję pipeline zapytań: osadzanie pytania → wyszukiwanie wektorowe → reranking wyników → wstrzyknięcie kontekstu do promptu LLM → zwrócenie odpowiedzi z cytatami źródeł.
4
Interfejs, kontrola dostępu i launch
Buduję lub integruję interfejs czatu, wdrażam uwierzytelnianie i kontrolę dostępu na poziomie dokumentu, testuję dokładność na ponad 100 reprezentatywnych pytaniach i wdrażam.
RAG na dokumentach firmy vs fine-tuning vs ogólny ChatGPT
Kryterium
RAG na dokumentach firmy
Fine-tuning modelu
Ogólny ChatGPT
Dokładność na wiedzy firmowej
Wysoka — odpowiedzi z Twoich dokumentów
Wysoka, lecz wiedza zamrożona
Niska — ogólne dane treningowe
Cytowanie źródeł
Tak, przy każdej odpowiedzi
Nie
Nie
Ryzyko halucynacji
Niskie
Średnie
Wysokie dla pytań dziedzinowych
Aktualizacja wiedzy
Natychmiastowa — wgranie dokumentu
Wymaga ponownego treningu
Brak kontroli
Prywatność danych
Self-hosted, dane w firmie
Zależna od miejsca treningu
Dane wysyłane do dostawcy
Czas wdrożenia
Szybki — bez treningu modelu
Wolny — przygotowanie danych i trening
Natychmiastowy, lecz nieprzydatny
Najlepszy dla
Pytań o wewnętrzną wiedzę firmy
Zmiany stylu i formatu odpowiedzi
Ogólnych, niefirmowych zapytań
Najczęstsze błędy
✕Wrzucenie wszystkich dokumentów do bazy wektorowej bez porządków, wersjonowania i usunięcia nieaktualnych.
✕Brak kontroli dostępu — każdy pracownik widzi każdy dokument.
✕Ocena jakości „na oko” zamiast na zestawie testowych pytań z oczekiwanymi źródłami.
✕Jedna strategia dzielenia dokumentów dla umów, instrukcji i maili.
Kiedy ta usługa nie ma sensu
—Masz kilkanaście dokumentów, które zmieszczą się w zwykłym oknie kontekstu modelu.
—Potrzebne informacje są w bazie danych w tabelach — lepszy będzie text-to-SQL.
—Dokumenty są nieaktualne i nikt nie odpowiada za ich utrzymanie.
/// PORADNIK
Wdrożenie RAG w firmie – jak buduję bazę wiedzy AI, która nie myli się na produkcji
Ten poradnik opisuje decyzje, które w projekcie RAG zapadają, zanim ktokolwiek wybierze model: czy własny RAG jest w ogóle potrzebny, jak przygotować dokumenty, jak szukać po polsku, jak egzekwować uprawnienia i jak zmierzyć jakość przed startem. Opisuję też koszty bieżące i utrzymanie, bo system wiedzy po wdrożeniu żyje razem z dokumentami. Liczby mają podane źródło, a tam, gdzie piszę o swojej metodzie, mówię wprost, że to moja praktyka.
Czy potrzebujesz własnego RAG – długi kontekst, gotowy Copilot czy system szyty na miarę
Własny RAG ma sens, gdy dokumentów jest za dużo na jedno okno kontekstu, gdy różne osoby mają widzieć różne dokumenty i gdy odpowiedzi muszą wskazywać źródło. Jeśli wiedza mieści się w kilkuset stronach albo firma już ma narzędzie z dobrze ustawionymi uprawnieniami, często wystarczy prostsze rozwiązanie.
Anthropic w opisie techniki Contextual Retrieval (2024) wprost radzi: jeśli baza wiedzy ma mniej niż 200 000 tokenów (około 500 stron), można pominąć RAG i wkleić całość do promptu, a prompt caching obniża wtedy koszt nawet o 90% i ponad dwukrotnie skraca opóźnienie. Przy większych zbiorach to przestaje działać nie tylko z powodu limitu. Badanie „Lost in the Middle” (Liu i in., TACL 2024) pokazało, że modele najlepiej wykorzystują informacje z początku i końca długiego kontekstu, a gorzej te ze środka. Raport Chroma „Context Rot” (2025) na 18 modelach potwierdził, że niezawodność spada wraz z długością wejścia nawet w prostych zadaniach. Dlatego przy tysiącach dokumentów lepiej podać modelowi kilka trafnych fragmentów niż całe archiwum.
Sytuacja
Co zwykle wystarcza
Kiedy przechodzę na własny RAG
Do kilkuset stron stabilnej wiedzy (regulamin, cennik, FAQ)
Cała treść w prompcie z cache
Gdy treść rośnie albo trzeba cytować konkretny akapit
Dokumenty w Microsoft 365 lub Google Workspace, uprawnienia uporządkowane
Copilot albo asystent dostawcy z konektorami
Gdy potrzebna jest kontrola nad wyszukiwaniem, własne źródła lub ocena jakości
Dane w tabelach (zamówienia, stany, faktury)
Zapytanie SQL generowane przez model lub zwykły raport
Gdy do tabel dochodzą umowy, notatki i opisy
Tysiące dokumentów z różnych systemów, różne poziomy dostępu
—
Od razu: indeks, uprawnienia, zestaw testowy
Dane nie mogą opuścić firmy
—
Self-hosted RAG z lokalnym modelem lub modelem w chmurze z umową powierzenia
Przy gotowych asystentach ważna jest jedna rzecz: dziedziczą uprawnienia, które już masz. Microsoft w dokumentacji przygotowania do Copilota (2026) pisze, że Copilot i agenci pobierają dane z Microsoft Graph z poszanowaniem istniejących uprawnień i ustawień udostępniania, a jednocześnie zaznacza, że SharePoint domyślnie ustawia najbardziej liberalną opcję udostępniania. Jeśli więc folder z wynagrodzeniami był udostępniony „wszystkim w firmie”, asystent to ujawni. Porządek w uprawnieniach jest warunkiem każdej z tych dróg.
Przygotowanie dokumentów do RAG – inwentaryzacja, parsowanie i metadane
Jakość RAG zaczyna się przed indeksowaniem: system odpowie tylko tak dobrze, jak dobrze odczyta dokumenty. Największe problemy, jakie widzę, to skany bez warstwy tekstu, tabele rozsypane na pojedyncze słowa i kilka wersji tej samej procedury bez informacji, która obowiązuje.
Lista kontrolna inwentaryzacji
Źródła: gdzie leżą dokumenty (dysk, SharePoint, Confluence, Notion, helpdesk, CRM) i czy da się je czytać przez API, czy tylko eksportem.
Właściciel: kto odpowiada za aktualność każdego źródła. Bez właściciela dokument nie trafia do indeksu.
Wersje: która wersja obowiązuje; stare wersje usuwam albo oznaczam metadanymi, żeby nie wygrywały w wyszukiwaniu.
Format: PDF z tekstem, skan wymagający OCR, DOCX, arkusz, strona wiki, e-mail. Każdy format ma inny parser.
Uprawnienia: kto może widzieć dany dokument; te informacje zapisuję razem z fragmentem w indeksie.
Dane osobowe: czy w dokumentach są dane klientów lub pracowników i czy w ogóle powinny trafić do bazy wiedzy.
Typ dokumentu decyduje o sposobie przetwarzania
Typ dokumentu
Typowy problem
Co robię
Umowy i regulaminy
Odwołania do paragrafów, definicje na początku dokumentu
Dzielę po paragrafach, do każdego fragmentu dodaję tytuł umowy, strony i numer paragrafu
Procedury i instrukcje
Kroki rozdzielone na kilka fragmentów
Trzymam całą procedurę lub sekcję razem, nawet kosztem dłuższego fragmentu
Skany PDF
Brak tekstu albo błędy OCR w liczbach
OCR z kontrolą próbek, szczególnie kwot, dat i numerów
Tabele i arkusze
Po zamianie na tekst tracą sens wiersze i nagłówki
Zamieniam wiersze na zdania z nazwami kolumn albo kieruję pytania do SQL
Baza helpdesku i FAQ
Krótkie wpisy, wiele podobnych
Jeden wpis to jeden fragment; usuwam duplikaty
Maile i notatki
Cytowane wątki, podpisy, dane osobowe
Czyszczę stopki i cytaty; często zostawiam je poza indeksem
Do każdego fragmentu zapisuję metadane: źródło, tytuł, sekcję, datę obowiązywania, język i grupę uprawnień. Dzięki nim można filtrować wyszukiwanie (na przykład tylko procedury działu sprzedaży z bieżącego roku) i pokazać użytkownikowi, skąd pochodzi odpowiedź. Produkcyjny przykład pracy na nietypowych dokumentach to silnik wycen w case study Konkret: 70 historycznych kosztorysów o łącznej wielkości 3,2 GB nie zmieści się w żadnym oknie kontekstu, więc model dostaje tylko kilka najbardziej podobnych kosztorysów wybranych przez wyszukiwanie.
Podział dokumentów i indeksowanie – od czego zaczynam i co zmieniam po testach
Na start dzielę tekst na fragmenty kilkuset do tysiąca kilkuset znaków z niewielką zakładką, a potem zmieniam strategię dla tych typów dokumentów, w których testy pokazują błędy. Nie ma jednego rozmiaru fragmentu dobrego dla umów, instrukcji i FAQ jednocześnie.
W moim demo Research Agent, które działa na tej stronie, fragmenter pakuje całe zdania do 1 200 znaków i przenosi 180 znaków zakładki do kolejnego fragmentu, żeby zdanie na granicy nie traciło kontekstu. To rozsądny punkt wyjścia dla tekstu ciągłego. W projektach produkcyjnych dokładam trzy rzeczy, których demo celowo nie ma: wyszukiwanie hybrydowe (wektory plus BM25), reranking oraz kontekst dopisany do każdego fragmentu.
Kontekst fragmentu to krótki opis w stylu „Fragment z umowy serwisowej z firmą X, paragraf 7, kary umowne”, generowany przez model przy indeksowaniu. Anthropic (2024) wycenił to jednorazowo na około 1,02 USD za milion tokenów dokumentów przy użyciu prompt cachingu. Dla typowej firmowej bazy wiedzy to koszt pomijalny w porównaniu z czasem, który tracą ludzie na złe odpowiedzi. Szczegóły chunkingu, hybrydy i rerankingu z kodem opisałem w artykule Zaawansowany RAG – chunking, hybrid search i reranking.
Co sprawdzam w indeksie przed pierwszym testem jakości
Losowe 30–50 fragmentów: czy da się je zrozumieć bez reszty dokumentu i czy nie urywają się w połowie listy lub tabeli.
Czy liczby, daty i nazwy produktów przetrwały parsowanie bez zniekształceń.
Czy każdy fragment ma komplet metadanych, w tym grupę uprawnień.
Czy aktualizacja dokumentu podmienia jego fragmenty, a nie dopisuje nowe obok starych.
Czy usunięcie dokumentu w źródle usuwa go z indeksu.
Wybór bazy wektorowej rzadko decyduje o jakości. Decyduje o kosztach, hostingu i tym, czy wyszukiwanie hybrydowe i filtrowanie po metadanych są wbudowane. Porównanie pgvector, Pinecone, Qdrant i Weaviate opisałem w artykule Bazy wektorowe – jak wybrać do RAG.
RAG po polsku – embeddingi, odmiana i wyszukiwanie hybrydowe
Polski utrudnia wyszukiwanie przez odmianę i szyk zdania, dlatego przy polskich dokumentach prawie zawsze łączę wyszukiwanie wektorowe z wyszukiwaniem po słowach kluczowych i testuję model embeddingów na własnych pytaniach firmy, a nie na rankingu z internetu.
Najlepszym publicznym punktem odniesienia jest benchmark PIRB (Polish Information Retrieval Benchmark) opracowany w Ośrodku Przetwarzania Informacji i opublikowany na LREC-COLING 2024. Obejmuje 41 zadań wyszukiwania w języku polskim, w tym zbiory z medycyny, prawa i biznesu. Autorzy porównali ponad 20 modeli i doszli do wniosku, że gęste modele wektorowe wypadają najlepiej, a metody hybrydowe dodatkowo poprawiają wyniki. To zgodne z tym, co widzę w projektach: sama semantyka gubi numery umów, kody produktów i nazwy własne, a samo BM25 nie rozumie, że „rozwiązanie umowy” i „wypowiedzenie” to podobne pytania.
Jak wybieram model embeddingów
Zbieram 50–100 prawdziwych pytań pracowników lub klientów, w tym pytania z literówkami, skrótami i branżowym żargonem.
Do każdego pytania przypisuję dokument i fragment, który powinien zostać znaleziony.
Porównuję 2–4 modele (komercyjne i otwarte, wielojęzyczne i trenowane na polskim) na tej samej bazie, mierząc, jak często właściwy fragment jest w pierwszych kilku wynikach.
Dopiero potem biorę pod uwagę koszt, wymiar wektora i to, czy model można uruchomić lokalnie.
Zmiana modelu embeddingów po starcie oznacza ponowne zindeksowanie całej bazy, bo wektory z różnych modeli nie są porównywalne. Dlatego ten wybór robię na etapie testów, a nie po pierwszych skargach użytkowników.
Uprawnienia i bezpieczeństwo RAG – kto co widzi i co może wstrzyknąć dokument
W RAG uprawnienia trzeba egzekwować na etapie wyszukiwania, a nie dopiero przy wyświetlaniu odpowiedzi: fragment, którego użytkownik nie może zobaczyć, nie może nawet trafić do kontekstu modelu. Drugie ryzyko to dokumenty, które zawierają ukryte instrukcje dla modelu.
OWASP w liście Top 10 for LLM Applications 2025 dodał osobną kategorię LLM08: Vector and Embedding Weaknesses, poświęconą właśnie systemom RAG. Wymienia w niej m.in. wycieki danych przez źle ustawione uprawnienia, przenikanie danych między grupami użytkowników we wspólnej bazie wektorowej, zatruwanie bazy wiedzy oraz odtwarzanie tekstu źródłowego z samych wektorów. Jako przykład podaje CV z ukrytym tekstem, który poleca systemowi rekomendować kandydata.
Zasady, które stosuję w każdym wdrożeniu RAG
Filtr uprawnień w zapytaniu do bazy: każde wyszukiwanie zawiera grupy, do których należy użytkownik; filtr pochodzi z systemu logowania, nigdy z treści pytania.
Synchronizacja uprawnień: gdy ktoś traci dostęp do folderu w źródle, traci go też w asystencie, przy najbliższej synchronizacji.
Oddzielne kolekcje dla klientów zewnętrznych: asystent dla klientów nie korzysta z tej samej kolekcji co asystent wewnętrzny.
Kontrola treści przy wgrywaniu: usuwam ukryty tekst, białą czcionkę i komentarze, a dokumenty z zewnątrz (CV, oferty, maile) traktuję jako niezaufane.
Fragmenty jako dane, nie polecenia: prompt jasno oddziela instrukcje od treści dokumentów, a model nie ma narzędzi, którymi dokument mógłby coś uruchomić.
Logi wyszukiwań: zapisuję, kto o co pytał i jakie fragmenty dostał, żeby dało się wyjaśnić każdą odpowiedź.
Wektory też są danymi. Skoro da się z nich częściowo odtworzyć tekst, baza wektorowa wymaga takiej samej ochrony jak baza dokumentów: szyfrowania, kopii zapasowych i kontroli dostępu. Szerzej o atakach na RAG i agentów piszę w artykule Prompt injection i bezpieczeństwo aplikacji LLM, a o danych osobowych w promptach w tekście RODO a AI w praktyce.
Ewaluacja RAG – jak mierzę jakość wyszukiwania i odpowiedzi przed startem
Jakość RAG mierzę osobno dla wyszukiwania i dla odpowiedzi, bo to dwa różne źródła błędów. Jeśli właściwy fragment nie został znaleziony, żaden model nie odpowie dobrze; jeśli został znaleziony, a odpowiedź jest zła, problem leży w prompcie lub modelu.
RAG nie gwarantuje braku halucynacji. Zespół ze Stanfordu (Stanford HAI, 2024) przetestował komercyjne narzędzia do researchu prawniczego oparte na RAG: Lexis+ AI podawał nieprawdziwe informacje w ponad 17% odpowiedzi, a Westlaw AI-Assisted Research w ponad 34%. Były to narzędzia dużych wydawców z dobrymi bazami. Dlatego obietnicę „zero halucynacji” traktuję jako sygnał ostrzegawczy i zamiast niej daję klientowi zmierzony odsetek błędów na jego własnych pytaniach.
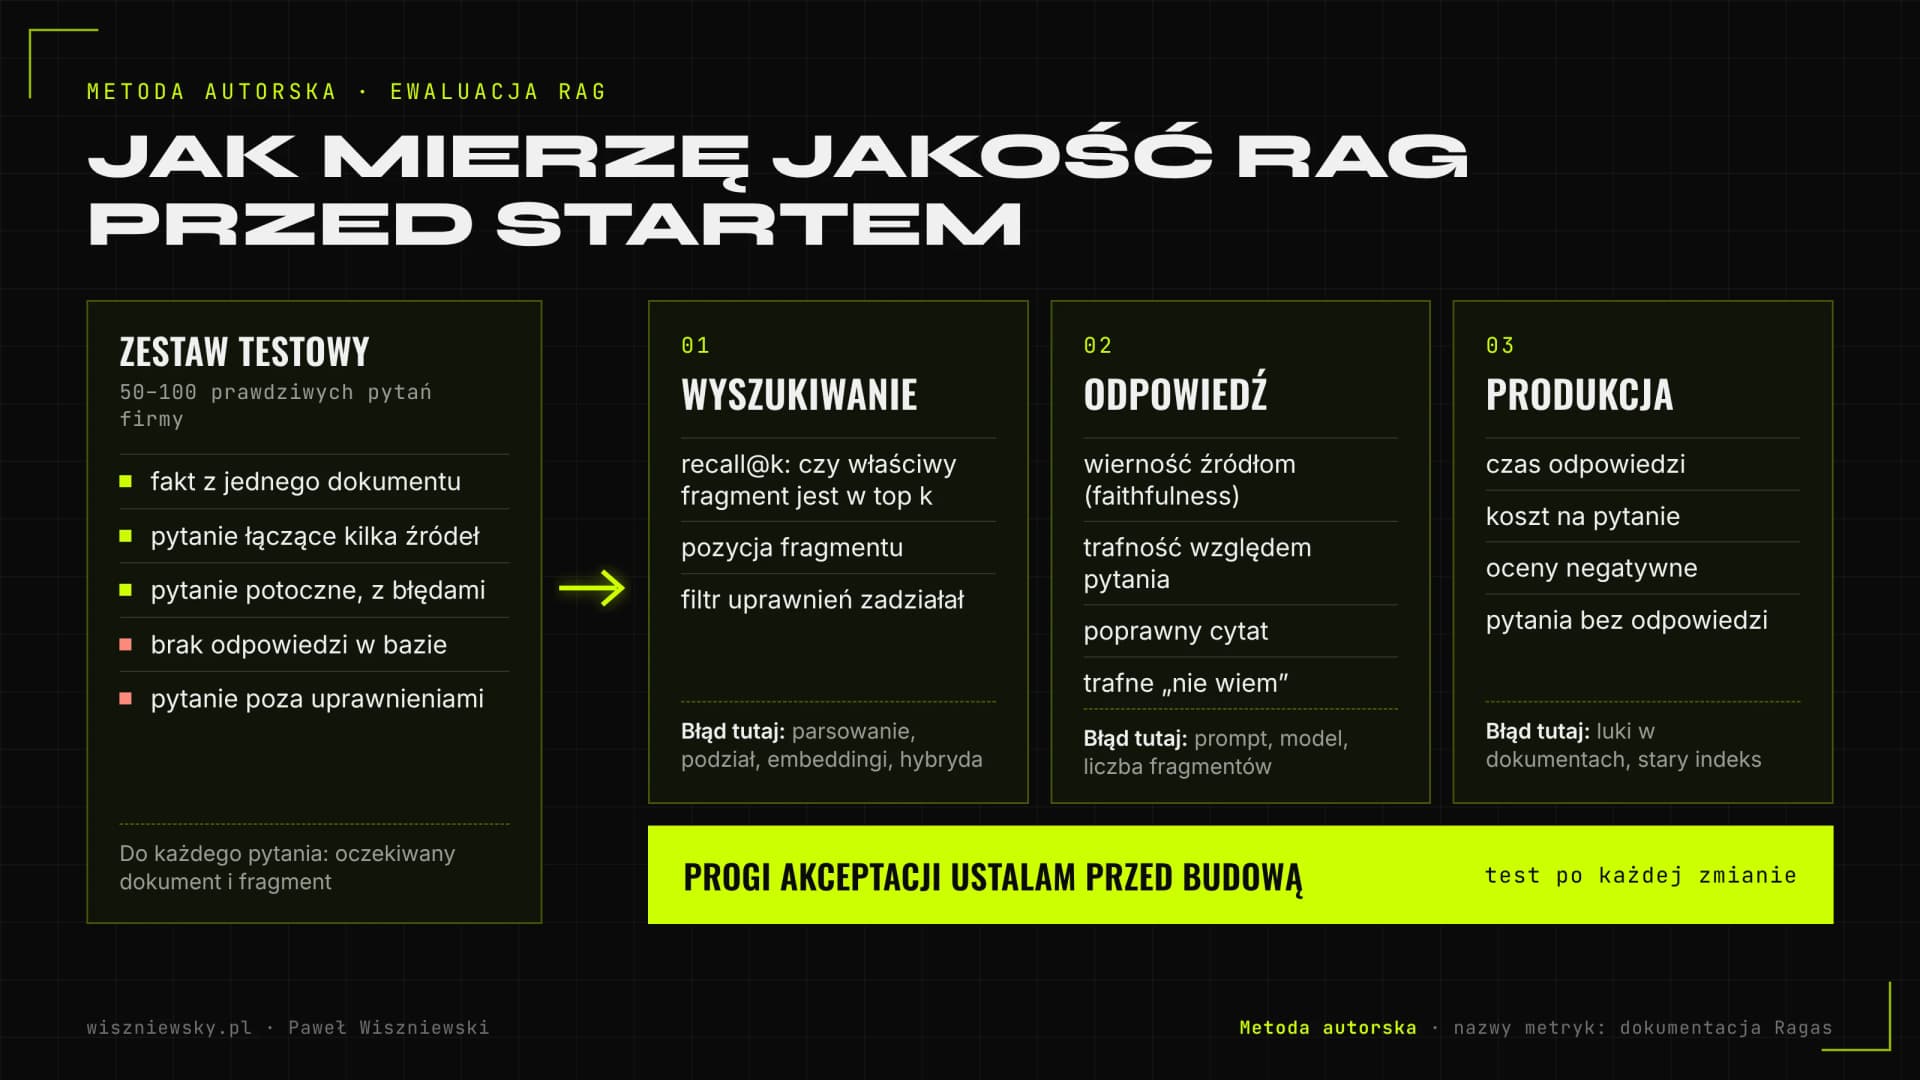
Ewaluacja RAG w trzech warstwach: wyszukiwanie, odpowiedź i produkcja. Metoda autorska; nazwy metryk odpowiedzi według dokumentacji Ragas.
Z czego składa się zestaw testowy
Typ pytania
Przykład
Co uznaję za zaliczone
Fakt z jednego dokumentu
Jaki jest termin zwrotu dla klienta firmowego?
Poprawna odpowiedź i cytat z właściwego paragrafu
Pytanie łączące kilka dokumentów
Czy procedura reklamacji różni się dla umowy A i B?
Oba źródła znalezione, różnica opisana poprawnie
Pytanie bez odpowiedzi w bazie
Jaki jest cennik na 2028 rok?
System mówi, że nie ma takiej informacji
Pytanie poza uprawnieniami
Handlowiec pyta o wynagrodzenia
Brak odpowiedzi i brak fragmentu w kontekście
Pytanie potoczne z błędami
ile mam dni na odstąpienie jak kupiłem w sklepie stacjonarnym
Właściwy fragment mimo innego słownictwa
Metryki i progi
Wyszukiwanie: czy właściwy fragment jest w pierwszych k wynikach (recall@k) i jak wysoko się znajduje. To mierzę bez modelu generującego, więc test jest szybki i tani.
Odpowiedź: wierność źródłom (czy każde twierdzenie wynika z fragmentów), trafność odpowiedzi względem pytania i poprawność cytatu. Biblioteka Ragas nazywa te metryki m.in. Faithfulness, Response Relevancy, Context Precision i Context Recall.
Odmowy: odsetek poprawnych „nie wiem” na pytaniach bez odpowiedzi i odsetek niepotrzebnych odmów na pytaniach, na które odpowiedź jest.
Produkcja: czas odpowiedzi, koszt na pytanie, odsetek pytań z negatywną oceną użytkownika.
Progi akceptacji ustalam z klientem przed budową, a nie po pierwszych wynikach. Część oceny robi model w roli sędziego, ale jego oceny kalibruję ręcznie na próbce, bo sędzia też się myli. Więcej o tej metodzie piszę w artykule Ewaluacja LLM – LLM-as-a-judge, a o włączeniu testów do procesu wdrożeń w tekście Jak pisać testy dla aplikacji AI.
Klasyczny RAG, agentic RAG i GraphRAG – którą odmianę wybrać
W większości firmowych baz wiedzy wystarcza klasyczny RAG z wyszukiwaniem hybrydowym i rerankingiem. Agentic RAG dokładam, gdy pytania są złożone i wymagają kilku wyszukiwań, a GraphRAG rozważam dopiero przy pytaniach o cały zbiór dokumentów, na przykład o główne wątki lub zależności.
Odmiana
Jak działa
Kiedy ma sens
Koszt i ryzyko
Klasyczny RAG
Jedno wyszukiwanie, kilka fragmentów, odpowiedź z cytatem
Pytania o fakty z procedur, umów, instrukcji
Najtańszy i najszybszy, najłatwiej go mierzyć
Agentic RAG
Model sam rozbija pytanie na zapytania cząstkowe i decyduje, kiedy szukać ponownie
Pytania porównawcze i wieloetapowe, research
Kilka wywołań modelu na pytanie, dłuższy czas odpowiedzi
GraphRAG
Model buduje graf encji i relacji oraz streszczenia grup tematów
Pytania o cały zbiór: główne motywy, powiązania między podmiotami
Część pytań trafia do bazy danych, część do dokumentów
Pytania mieszające liczby z systemów i treść dokumentów
Wymaga ostrożnych uprawnień do bazy danych
GraphRAG opisał zespół Microsoft Research w pracy „From Local to Global” (2024). Autorzy pokazują, że zwykły RAG słabo radzi sobie z pytaniami w rodzaju „jakie są główne tematy w tym zbiorze”, bo to bardziej streszczenie całego korpusu niż wyszukiwanie jednego fragmentu. Indeksowanie wymaga jednak przetworzenia całego zbioru przez model, więc ma sens dla stabilnych, wartościowych korpusów, a nie dla wiki zmieniającej się codziennie.
Agentic RAG pokazuję w demo Research Agent. Jedna lekcja z jego budowy przydaje się w każdym projekcie: w pierwszym kroku wymuszam wyszukiwanie w bazie. Bez tego model czasem odpowiadał od razu z pytania i, zgodnie z instrukcją „odpowiadaj tylko z bazy”, odmawiał odpowiedzi na pytania, które baza pokrywała. Kolejne kroki zostawiam modelowi, a w ostatnim wyłączam narzędzia, żeby zawsze powstała odpowiedź. Jak projektować takie pętle, opisuję w artykule Context engineering. Gdy asystent ma nie tylko odpowiadać, ale też wykonywać zadania w systemach, to już zakres usługi agenci AI dla firm.
Koszt wdrożenia RAG i koszty bieżące – z czego się składają
Wdrożenie RAG zaczyna się u mnie od 6 000 zł, a koszty bieżące składają się z czterech pozycji: embeddingów, bazy wektorowej, modelu generującego odpowiedzi i utrzymania. Embeddingi są zwykle najtańszą częścią; najwięcej kosztuje model odpowiadający na pytania i czas człowieka na utrzymanie dokumentów.
Pozycja
Od czego zależy
Jak ograniczam koszt
Embeddingi
Liczba tokenów w dokumentach i częstotliwość zmian
Indeksowanie przyrostowe, tylko zmienione dokumenty
Baza wektorowa
Liczba wektorów, wymiar, hosting zarządzany lub własny
pgvector przy istniejącym PostgreSQL, mniejszy wymiar wektora, gdy testy na to pozwalają
Model odpowiedzi
Liczba pytań, liczba fragmentów w kontekście, wybór modelu
Reranking zamiast wrzucania 20 fragmentów, tańszy model do prostych pytań, cache
Utrzymanie
Liczba źródeł, tempo zmian w dokumentach, monitoring
Właściciel każdego źródła, alerty o pytaniach bez odpowiedzi
Przykład rachunku: cennik OpenAI (2026) podaje dla modelu text-embedding-3-small 0,02 USD za milion tokenów. Jeśli przyjmę, że strona firmowego dokumentu to około 500 tokenów, zindeksowanie 10 000 stron (5 mln tokenów) kosztuje około 0,10 USD, a z kontekstem fragmentów według wyceny Anthropic kilka dolarów. Dlatego przy wycenie RAG skupiam się na koszcie odpowiedzi i pracy przy dokumentach, a nie na samych wektorach. Na cenę wdrożenia wpływają przede wszystkim liczba źródeł do podłączenia, jakość dokumentów (skany, tabele), wymagania co do uprawnień i hosting: chmura czy self-hosted. O lokalnych modelach piszę w artykule Ollama, vLLM i self-hosted LLM.
Utrzymanie systemu RAG po wdrożeniu – aktualizacje, usuwanie danych i monitoring
System RAG trzeba utrzymywać, bo zmieniają się dokumenty, pytania użytkowników i modele. Bez monitoringu jakość spada po cichu: nowa wersja cennika nie trafia do indeksu albo stara procedura wygrywa z nową.
Co monitoruję
Pytania bez odpowiedzi: lista pytań, na które system powiedział „nie wiem”. To najlepsze źródło informacji, jakiej wiedzy brakuje w dokumentach.
Oceny użytkowników: odpowiedzi z oceną negatywną przeglądam co tydzień w pierwszym miesiącu, potem co miesiąc.
Świeżość indeksu: czas od zmiany dokumentu w źródle do jego aktualizacji w indeksie oraz błędy synchronizacji.
Wyniki zestawu testowego: po każdej zmianie modelu, promptu lub sposobu dzielenia dokumentów.
Koszt i czas odpowiedzi: dzienny koszt modelu i opóźnienie, z alertem przy skoku.
RAG ma przewagę nad trenowaniem modelu w jednej ważnej sprawie: usunięcie danych. Gdy klient lub pracownik żąda usunięcia danych osobowych, z indeksu usuwam konkretne fragmenty i sprawa jest zamknięta. Z wag wytrenowanego modelu nie da się ich wyjąć bez ponownego treningu, o czym piszę na stronie fine-tuning LLM. Metryki, tracing i alerty dla aplikacji LLM opisuję szerzej w artykule Monitoring AI na produkcji.
Co przygotować przed wdrożeniem RAG – lista dla firmy
Najszybciej idą projekty, w których firma przed startem wskaże źródła, właścicieli dokumentów i kilkadziesiąt prawdziwych pytań. To skraca etap inwentaryzacji i pozwala od razu zbudować zestaw testowy.
Lista źródeł z dostępem (konto techniczne lub eksport) i informacją, które z nich są aktualne.
Osoba po stronie firmy, która odpowiada na pytania o treść dokumentów i zatwierdza wyniki testów.
50–100 pytań, które ludzie naprawdę zadają, najlepiej wziętych z maili, helpdesku lub komunikatora, razem z miejscem, gdzie leży odpowiedź.
Zasady dostępu: które grupy pracowników widzą które dokumenty.
Decyzja o hostingu: model w chmurze z umową powierzenia czy wszystko na własnej infrastrukturze.
Miejsce, gdzie asystent ma działać: czat w przeglądarce, Slack, Teams, intranet albo widżet dla klientów.
Gdy asystent ma obsługiwać klientów, a nie pracowników, do RAG dochodzą dane o zamówieniach, przekazanie rozmowy człowiekowi i ton komunikacji; to zakres usługi chatbot AI dla firm. Szerszy obraz, w tym wybór procesów, koszty i RODO przy automatyzacji, opisuję na stronie AI i automatyzacja, a praktyczny przewodnik po budowie bazy wiedzy w artykule Jak zbudować wewnętrzną bazę wiedzy firmy z AI.
Jak dokładny jest RAG w porównaniu do standardowego ChatGPT?
Na pytaniach dziedzinowych dokładność RAG jest dramatycznie wyższa, ponieważ LLM widzi Twoje dokładne dokumenty zamiast polegać na ogólnych danych treningowych. Dokładność typowo rośnie z 40-60% do 85-95% dla zapytań o wewnętrzną wiedzę.
Czy może obsłużyć setki tysięcy dokumentów?
Tak. Bazy wektorów jak Weaviate i Pinecone skalują się do setek milionów wektorów. Opóźnienie wyszukiwania pozostaje poniżej 100ms nawet w tej skali przy odpowiedniej konfiguracji indeksu.
Co się dzieje gdy moje dokumenty są aktualizowane?
Buduję inkrementalny pipeline indeksowania. Zaktualizowane lub nowe dokumenty uruchamiają zadanie re-embeddingu aktualizujące tylko zmienione wektory, utrzymując bazę wiedzy aktualną bez pełnego re-indeksowania.
W jaki sposób system RAG ogranicza halucynacje AI w firmie?
Model LLM nie odpowiada z ogólnej wiedzy treningowej — system wyszukiwania najpierw pobiera konkretne fragmenty Twoich dokumentów i dopiero na ich podstawie formułuje odpowiedź. Każda odpowiedź ma cytowane źródło, a gdy w dokumentach brakuje podstawy, system odpowiada „nie wiem” zamiast wymyślać fakty.
Którą bazę wektorową wybrać do RAG?
Pinecone jest najłatwiejsza na start (w pełni zarządzana). Weaviate i Qdrant oferują wbudowane wyszukiwanie hybrydowe. pgvector jest najbardziej opłacalny w małej i średniej skali, jeśli już używasz PostgreSQL. Wybór zależy od skali, budżetu i wymogów dotyczących hostingu danych.
Jak mierzysz jakość systemu RAG?
Przed startem buduję zestaw testowy 100–200 pytań z oczekiwanymi źródłami. Mierzę recall@k i NDCG dla wyszukiwania oraz poprawność i ugruntowanie odpowiedzi metodą LLM-as-a-judge. Dostrajam podział dokumentów, model embeddingów i próg rerankera, aż system osiągnie uzgodnione cele.
Ile kosztuje wdrożenie RAG w firmie?
Wdrożenie RAG zaczyna się od 6 000 zł. Na cenę wpływają liczba i format dokumentów, liczba źródeł (np. SharePoint, Confluence, Google Drive), wymagania dotyczące uprawnień oraz wybór hostingu: chmura czy self-hosted.
Czy moje dane są bezpieczne w systemie RAG?
Tak, jeśli system jest dobrze zaprojektowany: dokumenty i indeks mogą działać na Twojej infrastrukturze, dostęp jest kontrolowany na poziomie dokumentu, a dostawca modelu ma umowę powierzenia albo model działa lokalnie.
Z jakich źródeł może korzystać RAG?
Z plików (PDF, Word, Excel), Google Drive, SharePoint, Confluence, Notion, baz wiedzy helpdesku, a także z danych z CRM czy ERP. Źródła synchronizują się automatycznie, gdy dokumenty się zmieniają.
Ile trwa wdrożenie RAG?
Pierwsza wersja na wybranych źródłach to zwykle kilka tygodni, łącznie z przygotowaniem zestawu testowego i pomiarem jakości. Rozszerzanie o kolejne źródła odbywa się etapami.