Optymalizacja crawl budget dla dużych serwisów e-commerce i portali. Google indeksuje Twoje najważniejsze strony szybciej — mniejsze marnotrawstwo crawla, wyższy ranking.
›Wyeliminowanie stron marnotrawstwa crawla (filtry, faceted navigation, parametry URL, paginacja)
›Konfiguracja robots.txt blokująca crawlowanie URL sesji, parametrów wyszukiwania i duplikatów
›Strategia tagowania canonical: które strony są kanoniczne, jak obsługiwać duplikaty treści generowane przez CMS, pagination (rel=next/prev deprecated) i wersje z parametrami.
Cena: od 2 700 zł
SZCZEGÓŁY USŁUGI
Dla dużych serwisów z tysiącami stron (e-commerce, portale, agregatory) zarządzam crawl budget tak, aby roboty Google spędzały swój czas na stronach wartościowych, nie na stronach filtrowania, paginacji czy duplikatach. Optymalizuję robots.txt, tagi canonical, noindex dla stron low-value i architekturę linków wewnętrznych, skracając czas pełnego przeindeksowania serwisu.
› INVESTMENT:
od 2 700 zł
constmodule = newExecutionProtocol();
// Initializing optymalizacja-crawl-budget... › Loading dependencies... OK › Establishing connection... OK › Ready for deployment... AWAITING_COMMAND
Paweł Wiszniewski · moje podejście
Co robię inaczej
Crawl budget to temat, który mam przećwiczony na własnych projektach: GiftFinder generuje ponad 11 000 stron docelowych, więc każdy błąd w filtrach, paginacji czy linkowaniu od razu widać w logach i w raporcie indeksowania. Dlatego zaczynam od logów serwera, a nie od teorii — sprawdzam, gdzie Googlebot naprawdę spędza czas, i dopiero wtedy decyduję, co blokować, a co wzmacniać linkami. Przy okazji sprawdzam też crawlery AI, które coraz częściej obciążają serwer, a nie zawsze przynoszą ruch.
Uczciwie: większość firm, które pytają mnie o crawl budget, nie ma z nim problemu. Mają problem z jakością treści albo linkowaniem wewnętrznym, a crawl budget jest wygodnym, technicznym wyjaśnieniem.
Z rynku
Sam Google pisze w dokumentacji, że jego przewodnik po crawl budgecie jest przeznaczony głównie dla serwisów z ponad milionem stron zmieniających się co tydzień lub ponad 10 000 stron zmieniających się codziennie. Jeśli nowe strony są indeksowane w dniu publikacji, aktualna mapa strony i raport indeksowania w zupełności wystarczą. Dlatego zawsze zaczynam od sprawdzenia, czy problem w ogóle istnieje.
Duże sklepy z tysiącami produktów, filtrów i wariantów.
Portale ogłoszeniowe i serwisy z dużą liczbą generowanych stron.
Strony, na których nowe treści długo czekają na indeksację.
Serwisy z dużą liczbą stron „wykrytych, ale niezaindeksowanych” w Search Console.
Co dokładnie dostajesz
Analizę logów serwera: co Googlebot faktycznie odwiedza i jak często.
Porządki w filtrach, parametrach URL i stronach o niskiej wartości.
Poprawki robots.txt, canonicali, sitemap i linkowania wewnętrznego.
Priorytetyzację stron sprzedażowych w strukturze serwisu.
Monitoring indeksacji po zmianach.
Jak mierzę efekty
Odsetek budżetu indeksowania wydawanego na wartościowe strony.
Czas od publikacji do indeksacji nowych stron.
Liczba stron wykrytych, ale niezaindeksowanych.
Ruch organiczny na kategorie i produkty.
Dlaczego warto?
Wyeliminowanie stron marnotrawstwa crawla (filtry, faceted navigation, parametry URL, paginacja) — Googlebot skupia się na stronach generujących ruch i konwersje.
Konfiguracja robots.txt blokująca crawlowanie URL sesji, parametrów wyszukiwania i duplikatów — natychmiastowa redukcja zbędnych żądań o 30–70% dla dużych e-commerce.
Strategia tagowania canonical: które strony są kanoniczne, jak obsługiwać duplikaty treści generowane przez CMS, pagination (rel=next/prev deprecated) i wersje z parametrami.
Optymalizacja architektury linków wewnętrznych — priorytetyzuję najważniejsze strony przez małą głębokość kliknięć i więcej linków wewnętrznych do nich, co przekłada się na szybsze re-indeksowanie po aktualizacjach treści.
Log file analysis — analizuję logi serwera HTTP aby zobaczyć dokładnie co i jak często crawluje Googlebot, identyfikując ukryte marnotrawstwo crawla niewidoczne w innych narzędziach.
Jak to działa?
1
Analiza logów i Google Search Console
Analizuję logi serwera (lub Search Console Crawl Stats) aby zrozumieć jak Googlebot aktualnie crawluje serwis — ile czasu spędza na stronach wartościowych vs. szumie.
2
Identyfikacja stron low-value
Identyfikuję URL generujące crawl waste: parametryczne URL, filtry faceted navigation, strony z noindex/cienką treścią, które jednak są crawlowane i nie blokowane.
3
Implementacja optymalizacji
Wdrażam zmiany w robots.txt, konfiguracji canonical, tagach noindex/nofollow i architekturze sitemap, zmniejszając crawl waste i kierując Googlebot na wartościowe strony.
4
Weryfikacja efektów
Monitoruję Crawl Stats w Search Console przez 4–8 tygodni po wdrożeniu, weryfikuję wzrost % crawlowania wartościowych stron i przyspieszenie indeksowania nowych treści.
Najczęstsze błędy
✕Blokowanie w robots.txt stron, które mają noindex — Google nie zobaczy wtedy dyrektywy noindex.
✕Indeksowanie każdej kombinacji filtrów w sklepie.
✕Sitemapy pełne przekierowań, błędów 404 i stron kanonikalizowanych gdzie indziej.
✕Decyzje bez analizy logów serwera, na podstawie samych narzędzi do crawlowania.
Kiedy ta usługa nie ma sensu
—Serwis ma kilkaset stron i wszystkie są zaindeksowane — crawl budget nie jest Twoim problemem.
—Nie masz dostępu do logów serwera i nie da się go uzyskać.
—Główny problem to słaba treść lub brak linków, a nie indeksacja.
/// PORADNIK
Optymalizacja crawl budget – jak diagnozuję i porządkuję indeksowanie dużego serwisu
Ten poradnik opisuje moją pracę nad crawl budgetem od środka: jak sprawdzam, czy problem w ogóle istnieje, jak czytam raport statystyk indeksowania i logi serwera, jakim narzędziem zamykam który typ adresów i jak mierzę efekt. Definicję crawl budgetu i listę typowych źródeł marnotrawstwa znajdziesz w artykule Crawl budget – jak Google indeksuje dużą stronę. Tutaj skupiam się na tym, co robię w projekcie.
Czy Twój serwis ma problem z crawl budgetem? Diagnoza przed optymalizacją
Problem z crawl budgetem masz wtedy, gdy Google wie o ważnych adresach, ale ich nie pobiera albo pobiera je z dużym opóźnieniem, a jednocześnie wydaje żądania na adresy bez wartości. Jeśli nowe strony trafiają do indeksu w ciągu dnia lub dwóch, optymalizacja crawl budgetu nic nie da i lepiej zająć się treścią lub linkowaniem.
Google w przewodniku dla dużych serwisów (aktualizowanym w lipcu 2026 roku) podaje orientacyjne progi: ponad milion unikalnych stron zmieniających się mniej więcej co tydzień, ponad 10 000 stron zmieniających się codziennie albo duża liczba adresów w statusie „Wykryto – obecnie nie zindeksowano”. Ten ostatni warunek jest najważniejszy, bo dotyczy także mniejszych serwisów, np. sklepów z rozbudowanymi filtrami.
Dwa statusy, które łatwo pomylić
Raport indeksowania stron w Search Console rozróżnia dwie sytuacje, które wymagają zupełnie innych działań. Pomoc Search Console opisuje status „Wykryto – obecnie nie zindeksowano” tak: Google znalazł stronę, ale jej jeszcze nie pobrał, bo zwykle chciał, ale spodziewał się przeciążenia serwisu i przełożył crawl. Status „Zeskanowano – obecnie nie zindeksowano” oznacza, że strona została pobrana, ale nie trafiła do indeksu.
Objaw
Najczęstsza przyczyna
Czy to crawl budget?
Dużo adresów „Wykryto – obecnie nie zindeksowano”, rośnie z tygodnia na tydzień
Za mało pojemności serwera albo zbyt wiele adresów do pobrania (filtry, parametry)
Tak, to typowy sygnał
Dużo adresów „Zeskanowano – obecnie nie zindeksowano”
Słaba lub powielona treść, strony bez wyraźnej wartości
Nie, to problem jakości
Nowe produkty pojawiają się w Google po tygodniach
Słabe linkowanie wewnętrzne, nieaktualna mapa witryny, za dużo szumu w crawlu
Częściowo; zaczynam od logów
Googlebot w logach odwiedza głównie parametry, sortowania i stare adresy
W Search Console komunikat „Przekroczono limit obciążenia hosta” przy sprawdzaniu adresu
Serwer odpowiada za wolno lub zwraca błędy
Tak, po stronie pojemności
Serwis ma kilkaset stron i wszystkie są zaindeksowane, ale ruch nie rośnie
Treść, intencja, autorytet
Nie
Raport statystyk indeksowania w Search Console: co z niego czytam
Raport „Statystyki indeksowania” pokazuje, ile żądań Google wysłał do serwisu, z jakim wynikiem i po co. To najszybsze źródło danych, jeśli nie ma logów, ale działa tylko dla usług na poziomie domeny lub katalogu głównego. Usługa dodana dla podkatalogu, np. /blog/, tego raportu nie ma.
Według pomocy Search Console raport dzieli żądania według odpowiedzi serwera, typu pliku (HTML, obraz, JavaScript, CSS, JSON i inne), celu (wykrywanie nowych adresów albo odświeżanie znanych) i typu Googlebota (smartfon, komputer, obrazy, wideo, wczytywanie zasobów strony, AdsBot, StoreBot i inne). Osobna sekcja „Stan hosta” pokazuje problemy z pobieraniem robots.txt, rozpoznawaniem DNS i połączeniem z serwerem w ostatnich 90 dniach.
Wzorce, na które patrzę
Niski udział „Wykrywania” przy dużej liczbie nowych stron. Jeśli codziennie dodajesz setki produktów, a prawie całe żądania to odświeżanie starych adresów, Google nie nadąża z odkrywaniem nowych.
Wysoki udział przekierowań i błędów 404. Każde takie żądanie to pobranie bez wartości. Zwykle pochodzi z nieaktualnych linków wewnętrznych albo z mapy witryny.
Duży udział JSON lub „Inny typ pliku”. Często oznacza, że Googlebot pobiera endpointy API, które aplikacja JavaScript wywołuje przy renderowaniu.
Wczytywanie zasobów strony jako duża część żądań. Strony wymagają wielu plików JS i CSS albo adresy plików zmieniają się przy każdym wdrożeniu.
Średni czas odpowiedzi rosnący razem z liczbą żądań. Serwer zaczyna być wąskim gardłem; po przekroczeniu jego możliwości Google sam ograniczy tempo.
Problemy z robots.txt w stanie hosta. Pomoc Search Console opisuje, że przy nieudanym pobraniu robots.txt Google może spowolnić lub wstrzymać indeksowanie, więc ten plik musi odpowiadać stabilnie.
Raport pokazuje przykładowe adresy, a nie pełną listę, i nie pozwala podzielić żądań według szablonu strony. Dlatego traktuję go jako punkt wyjścia, a decyzje opieram na logach.
Analiza logów serwera krok po kroku
Logi serwera to jedyne źródło, które pokazuje każde żądanie Googlebota do każdego adresu. Na ich podstawie widać, ile crawla trafia do stron sprzedażowych, a ile do filtrów, parametrów i błędów. Narzędzia typu crawler symulują robota; logi pokazują, co robot faktycznie robi.
Zdobycie logów. Pobieram logi dostępu z serwera (Nginx, Apache), z CDN (np. Cloudflare, Fastly) albo z platformy hostingowej. Przy CDN biorę logi z warstwy brzegowej, bo część żądań nie dociera do serwera źródłowego. Potrzebuję co najmniej adresu, statusu, czasu odpowiedzi, user-agenta, adresu IP i znacznika czasu.
Weryfikacja Googlebota. User-agent łatwo podrobić. Google opisuje dwie metody weryfikacji: odwrotne zapytanie DNS (domena googlebot.com, google.com lub googleusercontent.com) potwierdzone zapytaniem w przód albo porównanie adresu IP z publikowanymi listami zakresów, np. common-crawlers.json. Robię to automatycznie, bo w logach regularnie trafiam na boty, które tylko podszywają się pod Googlebota.
Klasyfikacja adresów według szablonu. Każdy adres przypisuję do grupy: karta produktu, kategoria, filtr, paginacja, wyszukiwarka wewnętrzna, artykuł, zasób statyczny, API, inne. Robię to regułami na wzorcach adresów, a dla nietypowych struktur skryptem, który porównuje adres z bazą produktów i kategorii.
Zestawienie z listą adresów kanonicznych. Łączę logi z wynikiem crawla serwisu i mapą witryny. Dzięki temu widzę adresy kanoniczne, których Googlebot nie odwiedził w badanym okresie, oraz adresy odwiedzane, których nie ma w żadnej strukturze (stare linki, parametry z kampanii, adresy generowane przez skrypty).
Wnioski per szablon. Dla każdej grupy liczę udział w żądaniach, rozkład statusów, częstotliwość odwiedzin i czas odpowiedzi. Dopiero na tej podstawie decyduję, co zamknąć, co przyspieszyć, a co wzmocnić linkami.
Wskaźnik z logów
Jak liczę
Co mi mówi
Udział crawla w adresach wartościowych
Żądania do kanonicznych, indeksowalnych adresów ÷ wszystkie żądania Googlebota do HTML
Główna miara marnotrawstwa
Pokrycie adresów kanonicznych
Kanoniczne adresy odwiedzone w okresie ÷ wszystkie kanoniczne adresy
Ile ważnych stron Google w ogóle nie odwiedza
Czas do pierwszego crawla
Data pierwszego żądania Googlebota − data publikacji
Jak szybko Google odkrywa nowe strony
Rozkład statusów per szablon
Udział 200, 301/302, 304, 404/410, 5xx w każdej grupie
Gdzie są przekierowania, błędy i brak cache
Czas odpowiedzi per szablon
Mediana i 95. percentyl czasu odpowiedzi dla żądań Googlebota
Które szablony obniżają pojemność crawla
Adresy-sieroty w crawlu
Adresy odwiedzane przez Googlebota, których nie ma w crawlu serwisu ani w mapie witryny
Źródła szumu poza strukturą serwisu
Okres analizy dobieram do tempa zmian w serwisie, zwykle kilka tygodni, żeby wyrównać wahania dzienne i objąć pełny cykl odświeżania najważniejszych szablonów. Do analizy używam Screaming Frog Log File Analyser przy mniejszych zbiorach, a przy milionach wierszy własnych skryptów i bazy danych (BigQuery lub DuckDB). Te same logi przydają się do pomiaru ruchu z asystentów AI, o czym piszę w artykule jak mierzyć ruch z ChatGPT, Perplexity i AI Mode.
robots.txt, noindex, canonical czy 404: które narzędzie do którego adresu
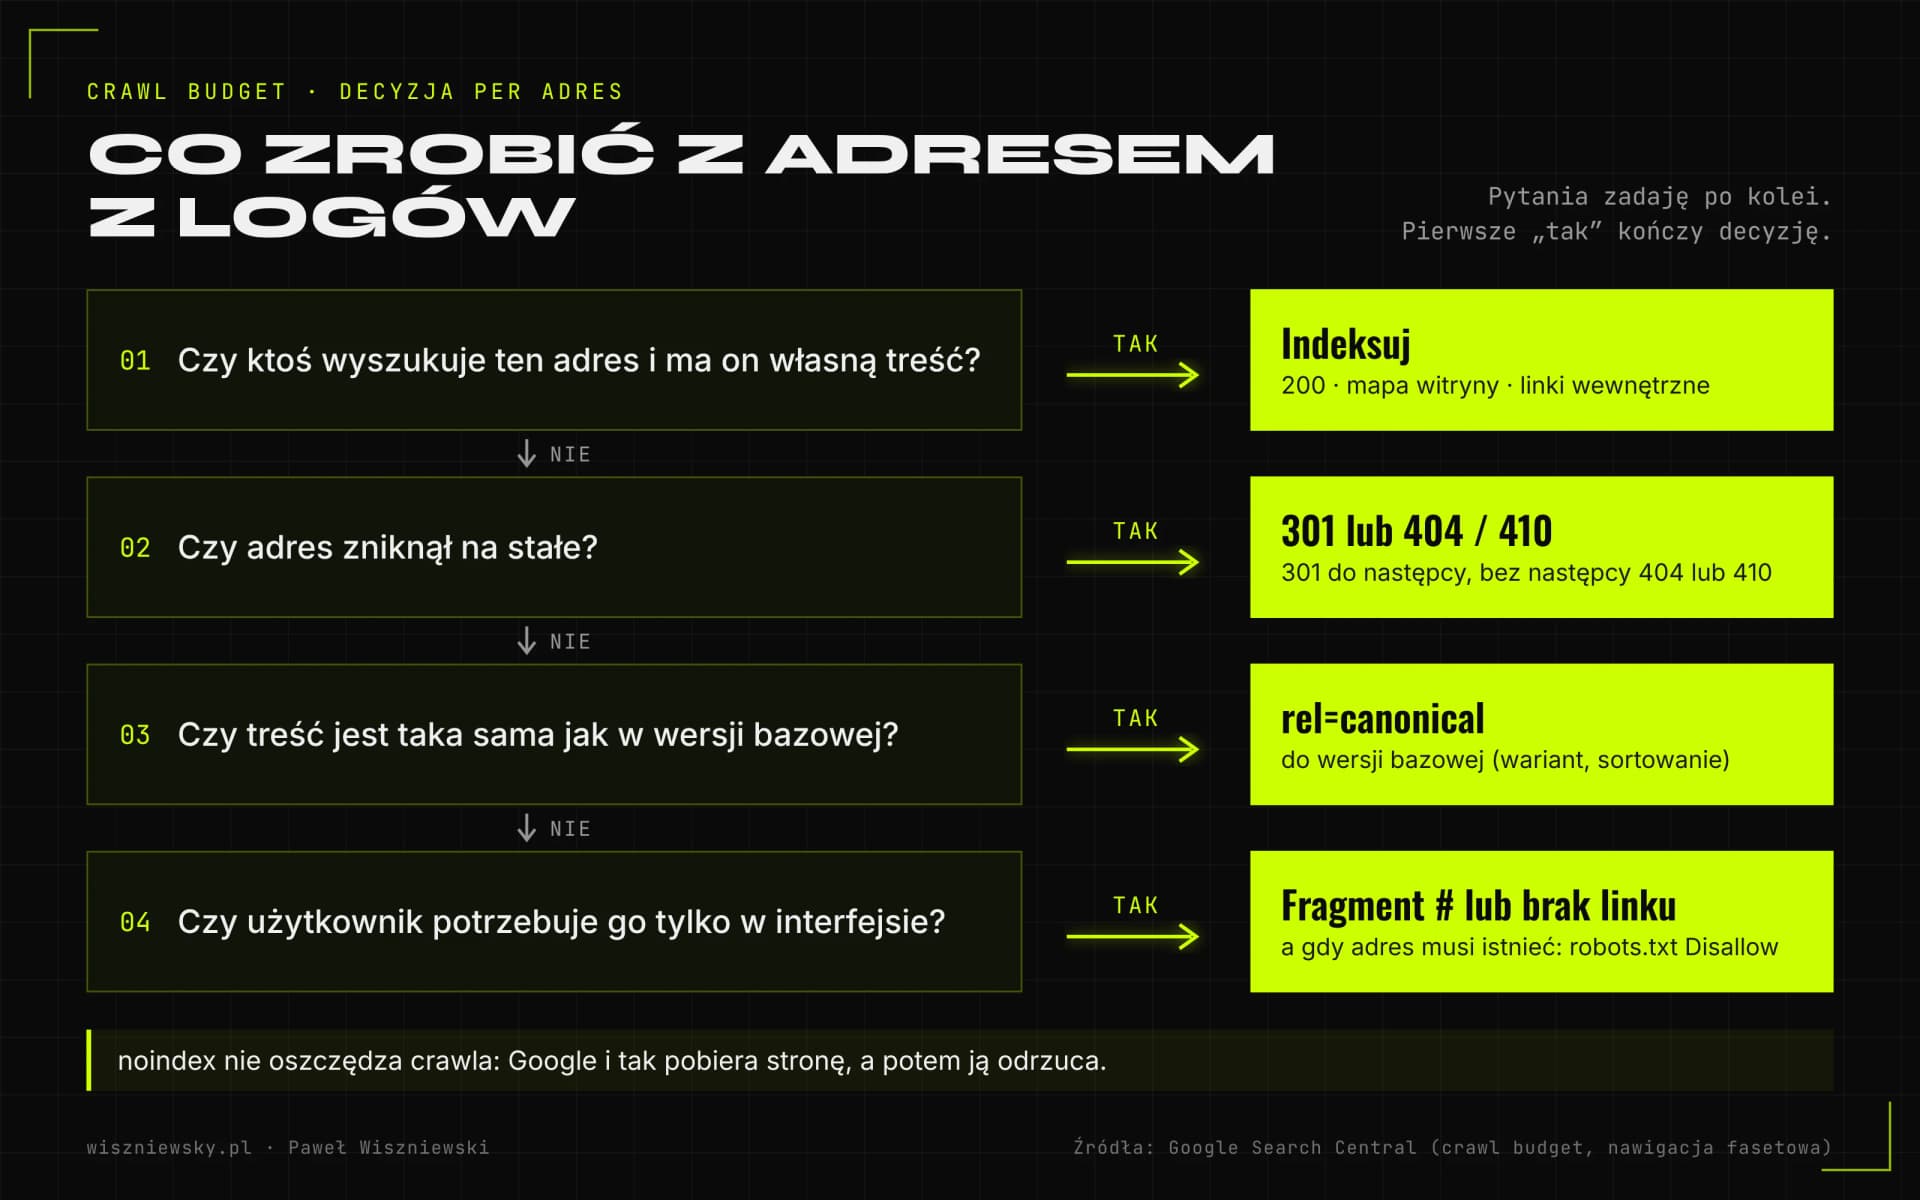
Każde narzędzie robi co innego: robots.txt zatrzymuje pobieranie, noindex usuwa z indeksu, ale wymaga pobrania, canonical scala sygnały, a 404 lub 410 kończy życie adresu. Najwięcej szkód w crawl budgecie widzę wtedy, gdy ktoś używa noindex do oszczędzania crawla albo blokuje w robots.txt strony, które powinny zniknąć z indeksu.
Kolejność pytań, którą zadaję przy każdym typie adresu z logów. Odpowiedź zależy od wartości adresu dla wyszukiwania, a nie od tego, które narzędzie jest najprostsze do wdrożenia.
Narzędzie
Co robi z crawlem
Kiedy używam
Pułapka
robots.txt Disallow
Google nie pobiera adresu
Filtry i parametry bez popytu, wyszukiwarka wewnętrzna, koszyk, akcje
Według Google zablokowany adres może pojawić się w wynikach bez opisu, jeśli prowadzą do niego linki; noindex na takiej stronie nie zostanie odczytany
meta robots noindex
Google nadal pobiera stronę, potem ją odrzuca
Strony potrzebne w serwisie, które nie powinny być w wynikach, przy małej skali
Google w przewodniku dla dużych serwisów odradza noindex jako sposób na oszczędzanie crawla
rel=canonical
Crawl maleje stopniowo, nie od razu
Warianty i sortowania z tą samą treścią co wersja bazowa
To wskazówka, nie dyrektywa; przy dużej skali działa słabiej niż robots.txt
404 lub 410
Google z czasem przestaje odwiedzać adres
Produkty wycofane na stałe bez następcy, puste kombinacje filtrów
Soft 404, czyli pusta strona ze statusem 200, nadal zużywa crawl
301 do następcy
Jedno dodatkowe żądanie na adres
Produkt zastąpiony nowym modelem, scalone kategorie
Łańcuchy przekierowań i przekierowania wszystkiego na stronę główną
Brak linku (lub fragment #)
Google nie odkrywa adresu
Sortowania, widoki listy, filtry, które nie mają być adresami
Adres nadal istnieje, jeśli wcześniej był linkowany lub jest w mapie witryny
Google w przewodniku zaznacza też, żeby nie używać robots.txt do tymczasowego przesuwania crawla na inne strony. Blokada ma sens dla adresów, które mają zostać zamknięte na stałe. Szerzej o działaniu robots.txt, także wobec crawlerów AI, piszę w artykule Crawlery AI – kto skanuje Twoją stronę.
Nawigacja fasetowa: które filtry indeksować, a które odciąć
Filtr zasługuje na indeksowany adres tylko wtedy, gdy ludzie wyszukują dokładnie tę kombinację, a wynik ma wystarczająco produktów, żeby strona była użyteczna. Pozostałe filtry działają dla użytkownika, ale nie powinny tworzyć adresów dostępnych dla robota.
Jak wybieram filtry do indeksacji
Zbieram frazy z kombinacją kategorii i atrybutu (np. marka, materiał, zastosowanie) z narzędzi do słów kluczowych i z Search Console.
Dla każdej kombinacji sprawdzam liczbę produktów w sklepie. Strona z jednym lub dwoma produktami rzadko wygrywa z kategorią nadrzędną.
Sprawdzam wyniki wyszukiwania: jeśli Google pokazuje na tę frazę strony kategorii z filtrem, mam potwierdzenie intencji.
Wybrane kombinacje dostają statyczny, czytelny adres, własny tytuł, nagłówek, krótki opis i link z kategorii. Reszta zostaje filtrami bez adresów do indeksacji.
Zasady techniczne z dokumentacji Google
Google opublikował w grudniu 2024 roku osobny dokument o nawigacji fasetowej (aktualizowany w grudniu 2025). Zalecenia, które wdrażam:
Jeśli filtrowane adresy nie są potrzebne w wynikach, blokuję parametry filtrów w robots.txt i zostawiam dostępne tylko karty produktów i niefiltrowane listy.
Filtry zapisane we fragmencie adresu (po znaku #) nie wpływają na crawl, bo Google zasadniczo nie obsługuje fragmentów przy indeksowaniu. To dobre rozwiązanie dla filtrów czysto użytkowych.
rel=canonical i rel=nofollow mogą ograniczyć crawl, ale Google opisuje je jako mniej skuteczne długoterminowo niż robots.txt. Nofollow działa tylko wtedy, gdy ma go każdy link do danego adresu.
Jeśli filtry mają być crawlowane: standardowy separator & w parametrach, stała kolejność filtrów w adresie i brak zduplikowanych filtrów.
Pusta kombinacja filtrów, nielogiczne zestawienie i nieistniejąca strona paginacji zwracają status 404, a nie przekierowanie do ogólnej strony błędu.
Sklepy mają też inne źródła szumu: produkty niedostępne, warianty na osobnych adresach i głęboką paginację. Strategię dla e-commerce szerzej opisuję w artykule SEO i GEO dla e-commerce.
Pojemność crawla: serwer, cache HTTP i zasoby strony
Pojemność crawla rośnie, gdy serwer odpowiada szybko i stabilnie, i spada przy błędach 5xx, odpowiedziach 429 i rosnącym czasie odpowiedzi. To ta część crawl budgetu, na którą mam bezpośredni wpływ w kodzie i infrastrukturze.
Cache HTTP i odpowiedź 304
Google w przewodniku dla dużych serwisów zaleca obsługę statusu 304 (Not Modified). W serii „Crawling December” z grudnia 2024 roku Google dodał, że jego crawlery obsługują żądania warunkowe z nagłówkami ETag i If-None-Match oraz Last-Modified i If-Modified-Since, i rekomenduje ETag, bo jest mniej podatny na błędy. Na kartach produktów i artykułach, które rzadko się zmieniają, wdrażam ETag liczony z treści strony, a nie z daty wygenerowania, bo inaczej każde żądanie wygląda jak zmiana.
Zasoby strony też zużywają crawl
W tej samej serii Google wyjaśnił, że pobieranie zasobów potrzebnych do wyrenderowania strony (JavaScript, CSS, odpowiedzi API) obciąża crawl budget hosta, który je serwuje, a usługa renderowania przechowuje pobrane pliki JS i CSS do 30 dni niezależnie od nagłówków cache. Wnioski dla wdrożenia: mniej plików na stronę, ostrożność z parametrami „cache busting”, które zmieniają adres pliku bez zmiany treści, i treść dostępna w HTML bez dodatkowych zapytań do API. Szczegóły renderowania opisuję w artykule JavaScript SEO.
Limit rozmiaru pliku
Dokumentacja Googlebota mówi obecnie, że przy crawlowaniu dla wyszukiwarki pobiera on pierwsze 2 MB obsługiwanego pliku i pierwsze 64 MB pliku PDF. Google opisał zmianę z lutego 2026 roku jako doprecyzowanie dokumentacji, a nie zmianę działania. Większość stron jest daleko od tego limitu, ale sprawdzam go na kategoriach z setkami produktów i dużym JSON-em stanu aplikacji wklejonym w HTML. Treść i linki za granicą 2 MB nie zostaną odczytane.
Ograniczanie crawla w awarii
Jeśli Googlebot przeciąża serwer, Google zaleca tymczasowe zwracanie statusu 500, 503 lub 429 (z nagłówkiem Retry-After) zamiast 200, ale tylko przez kilka godzin, najwyżej 1–2 dni. Przy dłuższym działaniu adresy mogą wypaść z indeksu. Narzędzie do ograniczania szybkości indeksowania w Search Console Google wyłączył 8 stycznia 2024 roku, więc trwałym rozwiązaniem jest wydajniejszy serwer i cache, a nie hamowanie robota.
Popyt na crawl: mapy witryny, lastmod i linkowanie wewnętrzne
Popyt na crawl zależy od tego, jak ważne i jak często aktualizowane wydają się Google adresy. Mapa witryny z wiarygodnym lastmod i linki wewnętrzne do kluczowych stron to dwa sygnały, które kontroluję w całości.
Mapy witryny podzielone według szablonów
Google ogranicza jedną mapę witryny do 50 000 adresów lub 50 MB bez kompresji; większe zbiory dzieli się na kilka map połączonych indeksem. Dzielę je nie tylko według limitu, ale według szablonu: osobno produkty, kategorie, artykuły, strony lokalizacji. W Search Console widać wtedy odsetek zaindeksowanych adresów w każdej grupie i od razu wiadomo, który szablon ma problem.
W mapie są tylko adresy kanoniczne, indeksowalne, zwracające 200. Bez przekierowań, 404, noindex i adresów zablokowanych w robots.txt.
lastmod zmienia się tylko przy istotnej zmianie treści, danych strukturalnych lub linków. Google używa tej wartości, jeśli jest konsekwentnie i sprawdzalnie trafna, a ignoruje ją, gdy każda strona ma dzisiejszą datę.
priority i changefreq pomijam, bo Google je ignoruje.
Mapa generuje się z tej samej bazy co strona, więc wycofany produkt znika z niej w tym samym momencie, w którym zaczyna zwracać 404 lub przekierowanie.
Głębokość kliknięć i linki do nowych stron
W crawlu serwisu sprawdzam, ile kliknięć od strony głównej dzieli kluczowe kategorie i produkty, oraz które kanoniczne adresy nie mają żadnego linku wewnętrznego. Nowe produkty linkuję z kategorii (na pierwszej stronie listy, nie na 40. stronie paginacji) i z bloków „nowości”, a artykuły z powiązanych tekstów i stron usług. Linkowanie wewnętrzne działa na popyt na crawl i jednocześnie na ranking, dlatego daje najwięcej przy najmniejszym ryzyku.
Poza Google warto pamiętać o Bingu, z którego indeksu korzystają m.in. Copilot i ChatGPT Search. Bing obsługuje protokół IndexNow, który powiadamia wyszukiwarkę o zmianie adresu od razu po publikacji. Piszę o tym w artykule Bing, Copilot i IndexNow.
Crawlery AI a wydajność serwera
Crawlery AI nie zabierają budżetu Googlebota, ale korzystają z tego samego serwera. Jeśli GPTBot, ClaudeBot czy inne boty generują duży ruch, serwer zwalnia, a wolniejszy serwer to niższa pojemność crawla dla Google.
W analizie logów zawsze wydzielam ruch botów AI i sprawdzam trzy rzeczy: ile żądań wysyłają, do jakich szablonów i jak wpływają na czasy odpowiedzi w godzinach szczytu. Decyzję, które boty wpuścić, podejmuję z klientem osobno dla botów treningowych i dla botów wyszukiwarek AI, bo te drugie mogą przynosić cytowania i ruch. Przy tych decyzjach łączę SEO techniczne z GEO, czyli pozycjonowaniem w AI.
Boty AI zwykle nie wykonują JavaScriptu, więc treść ładowana skryptem jest dla nich pusta. To kolejny argument za renderowaniem po stronie serwera, który działa jednocześnie na crawl budget Google i na widoczność w odpowiedziach AI.
Jak mierzę efekty optymalizacji crawl budgetu
Efekt mierzę zmianą udziału crawla w wartościowych adresach, czasem od publikacji do indeksacji i spadkiem liczby adresów „Wykryto – obecnie nie zindeksowano”. Ruch organiczny jest celem, ale reaguje później i zależy też od innych czynników.
Metryka
Źródło
Kierunek, którego oczekuję
Udział żądań Googlebota do kanonicznych adresów HTML
Logi serwera
Wzrost
Liczba adresów „Wykryto – obecnie nie zindeksowano”
Search Console, raport indeksowania stron
Spadek
Czas od publikacji do pierwszego crawla i do indeksacji
Logi, Sprawdzenie adresu URL, mapy witryny per szablon
Skrócenie
Udział 3xx, 404 i 5xx w odpowiedziach
Statystyki indeksowania, logi
Spadek
Udział odpowiedzi 304 dla stron bez zmian
Logi
Wzrost po wdrożeniu cache
Odsetek zaindeksowanych adresów w mapach per szablon
Search Console, mapy witryny
Wzrost dla produktów i kategorii
Kliknięcia z wyników dla kategorii i produktów
Search Console, filtr stron
Wzrost w dłuższym okresie
Pierwsze zmiany w statystykach indeksowania zwykle widać po kilku tygodniach, dlatego w procesie zakładam 4–8 tygodni monitoringu po wdrożeniu. Zmiany porównuję z okresem bazowym o tej samej długości, a przy sklepach odnotowuję sezonowe piki, które same w sobie zmieniają zachowanie Googlebota.
Sytuacje szczególne: migracja, programmatic SEO, wersje językowe
Crawl budget najczęściej staje się problemem nie przez stały rozmiar serwisu, ale przez nagłą zmianę: migrację, wygenerowanie tysięcy nowych stron albo dodanie kolejnego języka. W tych sytuacjach planuję crawl przed wdrożeniem, a nie po spadku.
Migracja i zmiana adresów. Po przeniesieniu serwisu Google musi pobrać stare adresy, żeby zobaczyć przekierowania, i nowe, żeby je zaindeksować. Przekierowania jednoskokowe, aktualne linki wewnętrzne i nowe mapy witryny od pierwszego dnia skracają ten okres. Opisuję to przy usłudze migracji SEO.
Programmatic SEO. Tysiące stron wygenerowanych z bazy szybko przekraczają możliwości crawla, jeśli większość z nich jest do siebie podobna. Publikuję je partiami, zaczynając od kombinacji z realnym popytem, i obserwuję odsetek indeksacji w mapie witryny danej partii. Więcej w artykule Programmatic SEO z AI.
Wersje językowe. Każdy język mnoży liczbę adresów, a błędne hreflang i canonicale potrafią sprawić, że Google crawluje wersje, które uznaje za duplikaty. Zasady opisuję w artykule Hreflang i SEO międzynarodowe.
Aplikacje JavaScript. Serwis renderowany wyłącznie w przeglądarce zużywa crawl na zasoby i zapytania API. Przy przebudowie na renderowanie po stronie serwera, np. w ramach migracji do Next.js, problem często znika razem z architekturą.
Porządki w treści. Tysiące cienkich, nieaktualnych artykułów też rozcieńczają popyt na crawl. Decyzje, co aktualizować, scalać, a co usuwać, opisuję w artykule Starzejące się treści.
Optymalizacja crawl budgetu jest częścią szerszej pracy nad techniką serwisu. Pełny kontekst usług znajdziesz na stronie pozycjonowania i SEO technicznego, a dane strukturalne, które często wdrażam przy tych samych szablonach, opisuję przy usłudze wdrażania Schema.org.
Według przewodnika Google dotyczy to głównie dużych serwisów (ok. 1 mln+ unikalnych stron zmieniających się mniej więcej co tydzień), średnich i większych serwisów (10 tys.+ stron) z treścią zmieniającą się codziennie oraz stron z dużą częścią adresów „wykrytych, ale niezaindeksowanych”. Google zaznacza, że to przybliżone progi. Mniejszym serwisom zwykle wystarcza aktualna mapa witryny i kontrola raportu indeksowania — tam ważniejsza jest jakość treści i linkowanie wewnętrzne.
Czy noindex usunie moje strony z Google?
Noindex usuwa stronę z wyników wyszukiwania, ale nie oszczędza crawl budget — Googlebot i tak ją odwiedza. Blokowanie w robots.txt oszczędza crawl budget, ale nie pozwala Google na śledzenie linków z tych stron. Strategia zależy od konkretnego przypadku.
Jak mierzyć efekty optymalizacji crawl budget?
Mierzę to przez Google Search Console → Crawl Stats: stosunek crawlowanych stron z błędami do stron z treścią, średnie dzienne żądania crawla i czy spada odsetek stron „wykrytych, ale niezaindeksowanych”.
Skąd wiem, że mam problem z crawl budgetem?
Typowe sygnały to dużo stron „wykrytych, ale niezaindeksowanych” w Search Console, długi czas od publikacji do indeksacji nowych stron oraz logi, w których Googlebot odwiedza głównie filtry, parametry i stare adresy zamiast stron sprzedażowych.
Czy powinienem blokować crawlery AI?
To decyzja biznesowa. Blokada crawlerów treningowych chroni treści, ale może zmniejszyć obecność marki w odpowiedziach AI. Crawlery wyszukiwarek AI (np. OAI-SearchBot, PerplexityBot) zwykle warto wpuszczać, bo mogą przynosić ruch i cytowania. Pomagam ustawić to świadomie.
Ile kosztuje optymalizacja crawl budgetu?
Optymalizacja zaczyna się od 2 700 zł. Cena zależy od wielkości serwisu, dostępności logów i liczby zmian, które trzeba wprowadzić w strukturze i szablonach.