llms.txt - czy naprawdę pomaga w widoczności w AI? Kompletny przewodnik 2026
llms.txt to propozycja prostego pliku w Markdownie, który umieszczasz w katalogu głównym domeny (twojastrona.pl/llms.txt), żeby „podpowiedzieć" modelom AI, które treści na stronie są najważniejsze. Krótka, uczciwa odpowiedź na 2026 rok: to nie jest czynnik rankingowy ani sygnał cytowań - Google, OpenAI i pozostali główni dostawcy oficjalnie go nie używają w wyszukiwaniu ani w odpowiedziach AI. Ma jednak realną, potwierdzoną wartość w jednym miejscu: w dokumentacji technicznej czytanej przez agentów kodujących (Cursor, Claude Code, Copilot). Wniosek w jednym zdaniu: dodaj go, jeśli masz dokumentację; nie oczekuj po nim magii SEO/GEO.
llms.txt to plik Markdown, który ma podpowiadać modelom AI najważniejsze treści strony. Ale czy Google, ChatGPT i Perplexity faktycznie go używają? Twarde dane Ahrefs i SE Ranking, stanowisko Google (John Mueller) i jedyny scenariusz, w którym llms.txt naprawdę działa.
Plik zaproponował Jeremy Howard - współzałożyciel Answer.AI i fast.ai - 3 września 2024. Pomysł jest elegancki: strony HTML są pełne nawigacji, reklam i skryptów, przez co model marnuje kontekst i „gubi się". Zamiast tego dajesz mu czysty Markdown z listą najważniejszych podstron i jednozdaniowymi opisami. Problem w tym, że po niemal dwóch latach żaden duży dostawca AI nie zaadoptował tego jako sygnału w produkcyjnym wyszukiwaniu.
Czym dokładnie jest llms.txt?
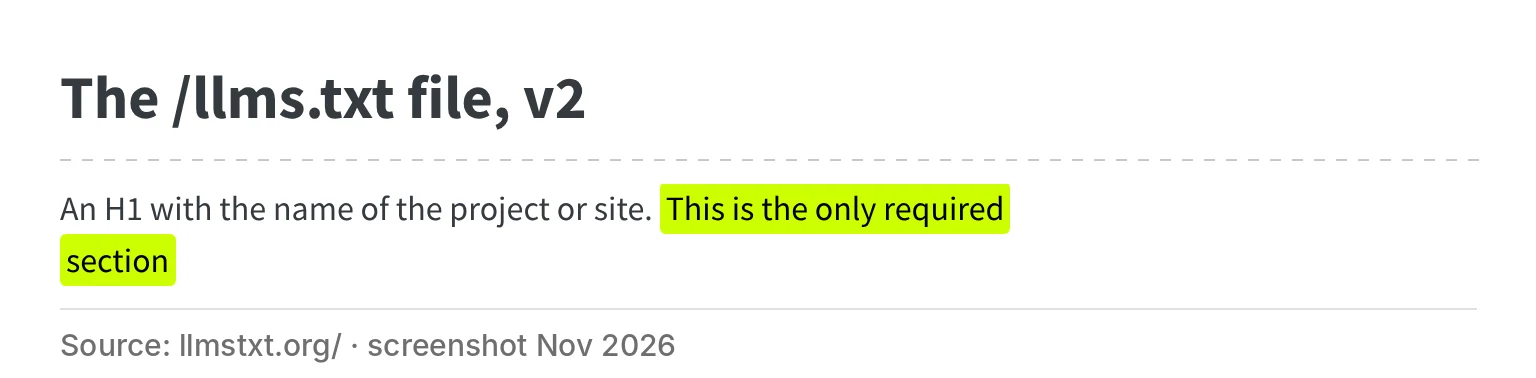
To zwykły plik tekstowy w formacie Markdown, który musi dać się sparsować standardową biblioteką - bez własnych rozszerzeń. Specyfikacja (llmstxt.org) definiuje sztywną strukturę: nagłówek H1 z nazwą, cytat (blockquote) ze streszczeniem, opcjonalny akapit kontekstu, a potem sekcje H2 z listami linków, gdzie po dwukropku dajesz krótki opis.
/// ANATOMIA PLIKU LLMS.TXT
Zwykły Markdown w katalogu głównym: /llms.txt
# Nazwa projektu> Jedno zdanie o tym, czym jest stronaDodatkowy kontekst w akapicie…## Dokumentacja- [Szybki start](/start): jak zacząć## OptionalHoward zdefiniował też drugi plik - llms-full.txt - który zawiera pełną treść strony w jednym dokumencie Markdown, a nie tylko listę linków. To właśnie ten wariant jest najużyteczniejszy dla narzędzi, które potrafią wczytać całość do kontekstu.
llms.txt vs robots.txt vs sitemap.xml
Najczęstsze nieporozumienie brzmi: „llms.txt to robots.txt dla AI". To nieprawda - te pliki pełnią zupełnie różne role.
| Plik | Do czego służy | Kto go respektuje | Status |
|---|---|---|---|
| robots.txt | Kontroluje DOSTĘP crawlerów (co wolno pobierać) | Google, Bing, GPTBot, większość botów | Standard de facto od 1994 |
| sitemap.xml | Lista URL-i do zaindeksowania + metadane | Google, Bing | Oficjalnie wspierany |
| llms.txt | Wskazuje najważniejszą TREŚĆ dla modeli AI | Głównie agenci w IDE; brak dużych wyszukiwarek | Propozycja, brak standaryzacji |
Czy wyszukiwarki i chatboty AI faktycznie go używają?
Tu kończy się teoria, a zaczynają fakty. Oto stan na 2026 rok:
/// KTO FAKTYCZNIE CZYTA LLMS.TXT (2026)
Realna wartość leży po stronie agentów kodujących, nie wyszukiwarek AI
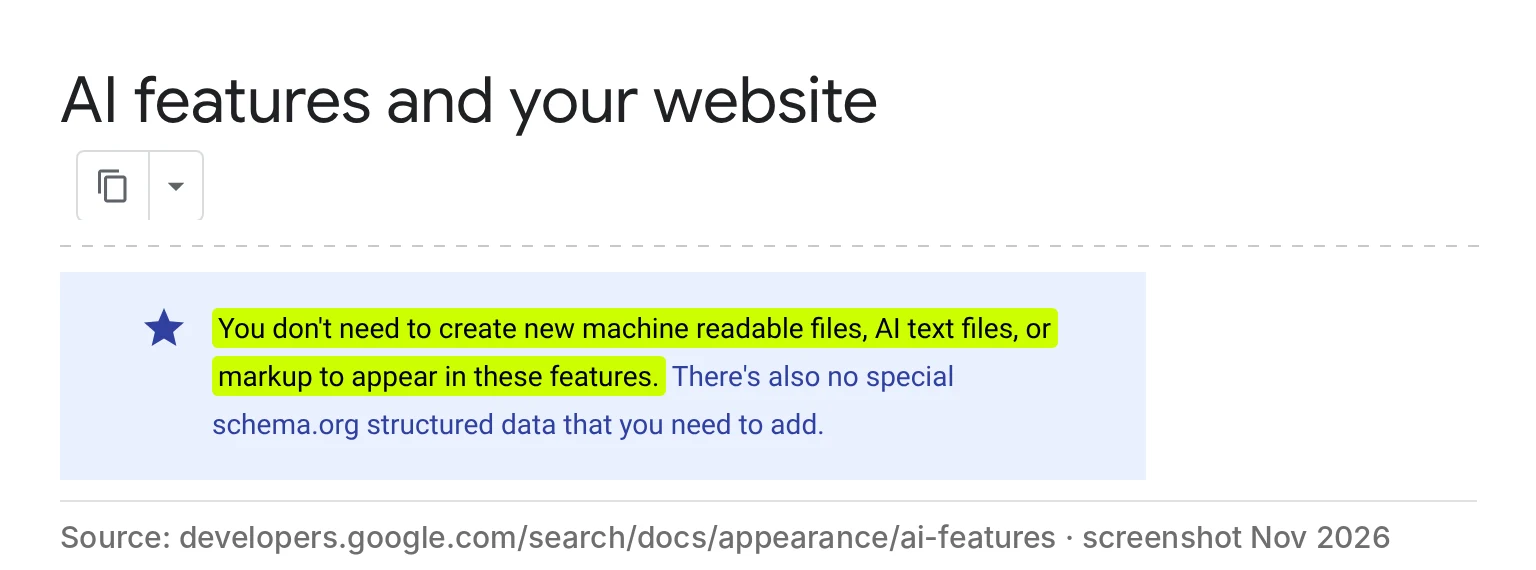
Google wprost mówi „nie". John Mueller porównał llms.txt do wycofanego meta tagu keywords - sygnału deklarowanego przez właściciela strony, więc trywialnego do nadużyć - i zauważył, że „w logach serwera widać, że boty nawet go nie sprawdzają". Dokumentacja Google o funkcjach AI (AI Overviews, AI Mode) wymienia llms.txt jako taktykę, która nie pomaga.
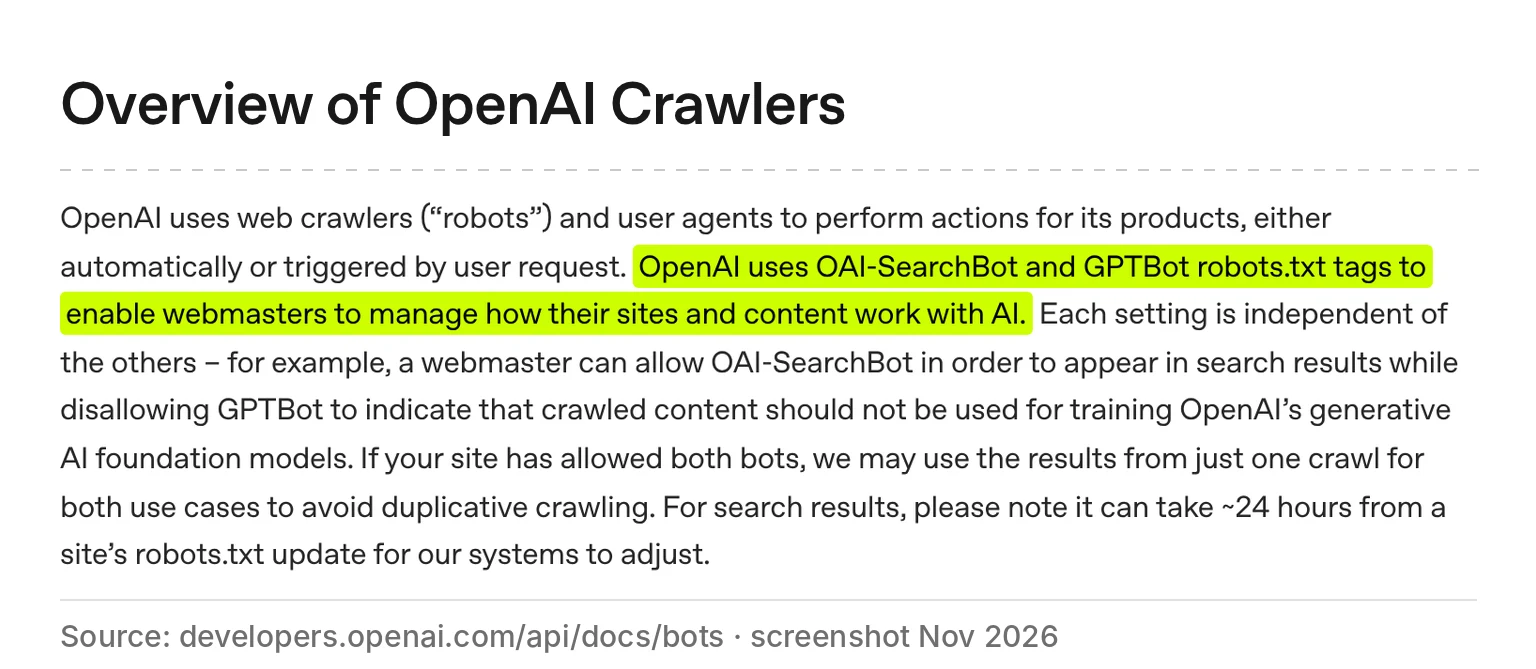
OpenAI steruje swoimi botami (GPTBot, OAI-SearchBot) wyłącznie przez robots.txt; dokumentacja crawlerów ani razu nie wspomina o llms.txt. Żaden z dużych dostawców - OpenAI, Anthropic, Google, Meta, Mistral - nie zadeklarował publicznie użycia llms.txt jako sygnału w produkcyjnym wyszukiwaniu czy odpowiedziach.
Co mówią twarde dane
Dwie duże analizy z lat 2025-2026 mówią jednym głosem:
| Badanie | Próba | Kluczowy wynik |
|---|---|---|
| SE Ranking (2025) | 300 000 domen | 10,13% adopcji; ZERO korelacji między llms.txt a częstością cytowań w AI |
| Ahrefs (2026) | 137 210 domen | do 28% adopcji (górna granica, próba techniczna); 97% ważnych plików bez ŻADNEGO zapytania w miesiącu |
| Ahrefs - realne pobrania | ~38 000 plików | tylko 3% było w ogóle pobierane; z tego 19,5% przez nazwane narzędzia AI (najczęściej GPTBot i Claude-Code) |
Innymi słowy: nawet gdy plik istnieje, w przeważającej większości przypadków nikt go nie czyta, a jego obecność nie przekłada się na cytowania w AI.
Więc gdzie llms.txt NAPRAWDĘ działa?
Jest jeden scenariusz, w którym ma sens - i to nie jest SEO. To dokumentacja techniczna czytana przez agentów kodujących. Narzędzia takie jak Cursor, Windsurf, Claude Code, GitHub Copilot, Cline i Aider rutynowo pobierają /llms.txt oraz /llms-full.txt, gdy wskażesz je na stronę z dokumentacją. Dostają wtedy czysty, skondensowany kontekst zamiast zaszumionego HTML.
Dlatego llms.txt masowo adoptują dostawcy narzędzi deweloperskich (Anthropic, Mintlify, Instructor i inni) - bo ich realnym odbiorcą jest agent AI wczytujący dokumentację, a nie Googlebot. Jeśli sprzedajesz API, SDK albo prowadzisz portal dokumentacji, to jest twój przypadek.
Czy powinieneś dodać llms.txt?
/// CZY POWINIENEŚ DODAĆ LLMS.TXT?
Jak stworzyć poprawny llms.txt - krok po kroku
- 1.Umieść plik w katalogu głównym - musi być dostępny pod twojastrona.pl/llms.txt, nie w podkatalogu.
- 2.Zacznij od H1 i cytatu - nazwa projektu plus jedno zdanie, czym jest strona.
- 3.Wybierz 10-20 evergreenowych, wartościowych stron - dokumentacja, kluczowe przewodniki, cennik, kontakt. Nie wrzucaj wszystkiego.
- 4.Każdy link z krótkim opisem po dwukropku - na przykład:
[Cennik](/cennik): plany i ceny API. - 5.Użyj sekcji „## Optional" na treści drugorzędne, które można pominąć przy krótszym kontekście.
- 6.Opcjonalnie wygeneruj llms-full.txt - pełną treść w jednym pliku Markdown. Wiele platform (np. Mintlify) robi to automatycznie.
- 7.Utrzymuj plik aktualny - nieaktualny llms.txt jest gorszy niż jego brak.
Najczęstsze błędy
- Traktowanie go jak robots.txt. Nie blokuje ani nie wpuszcza botów - do tego służy robots.txt.
- Oczekiwanie wzrostu pozycji. Google go nie używa; to nie jest kanał SEO.
- Wrzucenie 500 linków. Sens polega na kuracji najważniejszych treści, nie na kompletności.
- „Ustaw i zapomnij". Rozjazd z realną treścią czyni plik szkodliwym dezinformatorem.
- Publikacja bez dokumentacji. Jeśli nie masz treści, którą czytają agenci AI, plik nie ma odbiorcy.
Z mojej praktyki: dlaczego ten serwis ma llms.txt
wiszniewsky.pl ma plik /llms.txt o rozmiarze ok. 51 KB (stan na listopad 2026). Nie robię sobie złudzeń co do jego wpływu: w Google nic nie daje, a żaden inny duży dostawca nie potwierdził, że go czyta. Trzymam go z jednego powodu: generuje się automatycznie z tych samych danych co sitemapa i menu usług, więc nie wymaga pracy i nie może się zdezaktualizować. Gdybym musiał go pisać i poprawiać ręcznie, usunąłbym go, a ten czas wydał na treść i dane strukturalne. To, co naprawdę decyduje o tym, czy AI cytuje firmę, sprawdzam w ramach audytu widoczności w AI.
Podsumowanie
llms.txt to dobry pomysł, który rozwiązuje realny problem - zaszumione HTML marnujące kontekst modelu - ale w 2026 roku nie jest kanałem widoczności w wyszukiwarkach AI. Google i OpenAI go nie używają, a dane pokazują znikome realne pobrania i zero korelacji z cytowaniami. Jedyny scenariusz z potwierdzoną wartością to dokumentacja techniczna czytana przez agentów kodujących.
Praktycznie: masz portal dokumentacji, API lub SDK → dodaj llms.txt i llms-full.txt. Prowadzisz firmę usługową, sklep lub blog i zależy Ci na widoczności w ChatGPT i Google → zainwestuj ten czas w treść, dane strukturalne i E-E-A-T. To właśnie te sygnały realnie decydują, czy AI poleci Twoją markę.
Powiązane artykuły
Usługi powiązane z tym tematem
Potrzebujesz wdrożenia tych koncepcji? Zobacz usługi powiązane z tym tematem.
GEO – Pozycjonowanie w AI
Generative Engine Optimization (GEO) to pozycjonowanie marki w odpowiedziach AI: ChatGPT, Google AI Overviews i AI Mode, Gemini, Perplexity i Copilot. Sprawiam, że AI zna Twoją firmę, cytuje Twoją stronę i poleca Cię klientom.
Zobacz usługęUsługaPozycjonowanie Stron i SEO Techniczne
Pozycjonowanie stron oparte na solidnym SEO technicznym: audyt, Core Web Vitals, dane strukturalne, migracje i link building. Strona, którą Google łatwo indeksuje, a modele AI chętnie cytują.
Zobacz usługęPowiązane artykuły
Paginacja w sklepie internetowym - canonical, noindex, „Załaduj więcej” czy infinite scroll (audyt polskich sklepów)
Jak ustawić paginację kategorii, żeby Google znalazł wszystkie produkty: paginacja, „Załaduj więcej” czy infinite scroll, canonical i noindex na stronach 2+, rel=next, tytuły, adresy stron, filtry, audyt polskich sklepów, skrypt i najczęstsze błędy.
Dane strukturalne w sklepie internetowym - Product, Offer, warianty (ProductGroup) i BreadcrumbList w praktyce
Jakie dane strukturalne powinien mieć sklep: merchant listing czy krótki opis produktu, wymagane pola Product i Offer, zwroty i dostawa w Organization, warianty przez ProductGroup, okruszki, oceny, JSON-LD czy JavaScript, audyt 36 kart w 19 polskich sklepach, skrypt i pułapka z ceną promocyjną.
Indeksacja sklepu internetowego - dlaczego Google nie indeksuje produktów i kategorii i jak to naprawić
Dlaczego Google nie indeksuje produktów i kategorii: statusy z Search Console przełożone na przyczyny w sklepie, „Wykryto” czy „Zeskanowano - obecnie nie zindeksowano”, produkty niedostępne i wycofane, warianty, mapy witryn 30 polskich sklepów, skrypt URL Inspection API i pułapka z lastmod.
Signal received?
Umów bezpłatną konsultację
Zainicjuj protokół. Nawiąż połączenie. Zbudujmy coś głośnego.