Paginacja w sklepie internetowym - canonical, noindex, „Załaduj więcej” czy infinite scroll (audyt polskich sklepów)
Paginacja w sklepie internetowym to podział długiej listy produktów kategorii na kolejne strony. Dla SEO liczy się jedno: czy Google dotrze przez te strony do każdego produktu. Reguła na start: jeśli kategoria ma więcej produktów, niż mieści pierwsza strona (w praktyce zwykle ponad 24-48), każda kolejna strona musi mieć własny adres (np. ?page=2), własny canonical i link `<a href>` w surowym HTML. Nie dawaj canonicala stron 2+ na stronę 1, nie ustawiaj na nich noindex ani nofollow i nie opieraj dalszych stron wyłącznie na przycisku „Załaduj więcej” czy infinite scrollu bez adresów stron.
Jak ustawić paginację kategorii, żeby Google znalazł wszystkie produkty: paginacja, „Załaduj więcej” czy infinite scroll, canonical i noindex na stronach 2+, rel=next, tytuły, adresy stron, filtry, audyt polskich sklepów, skrypt i najczęstsze błędy.
W tym wpisie pokazuję, co Google mówi o paginacji dziś (z zrzutami z dokumentacji), jak porównać paginację, „Załaduj więcej” i infinite scroll, co ustawić na stronach 2+, jak wyglądają adresy i tytuły stron, jak paginacja łączy się z filtrami, wyniki mojego sprawdzenia 19 polskich sklepów, skrypt do samodzielnej kontroli i pułapkę, która w sklepach zdarza się najczęściej.
Czy paginacja w ogóle szkodzi SEO - pierwsza decyzja
Nie. Paginacja sama w sobie jest neutralna, a Google ją rozumie. Problemem są dwie sytuacje: Google nie może przejść na kolejne strony (brak linków w HTML, przycisk zamiast linku, numer strony po znaku #) albo dostaje sygnał, że kolejne strony są nieważne (canonical na stronę 1, noindex, nofollow). Wtedy produkty, które są linkowane tylko z dalszych stron kategorii, Google znajduje wolniej albo wcale.
| Sytuacja w sklepie | Czy to problem | Co zrobić |
|---|---|---|
| Kategoria mieści się na jednej stronie | Nie | Nic - paginacja nie jest potrzebna |
| Strony 2+ mają własny adres, canonical i link w HTML | Nie | Nic, poza dobrym linkowaniem produktów z innych miejsc |
| Canonical stron 2+ wskazuje stronę 1 | Tak | Ustaw własny canonical na każdej stronie |
| „Załaduj więcej” albo infinite scroll bez adresów stron | Tak, gdy kategoria ma dużo produktów | Dodaj adresy ?page=n i linki do nich w HTML |
| Strony 2+ z noindex albo nofollow | Tak | Usuń noindex i nofollow ze stron paginacji |
| Adresy stron z filtrami i sortowaniem w indeksie | Zwykle tak | Paginuj tylko podstawową listę, filtry obsłuż osobno |
Co Google mówi o paginacji w 2026
Google opisał paginację w osobnym przewodniku dla sklepów: „Pagination, incremental page loading, and their impact on Google Search”. Najważniejsze zasady w skrócie, każda z cytatem z dokumentacji.
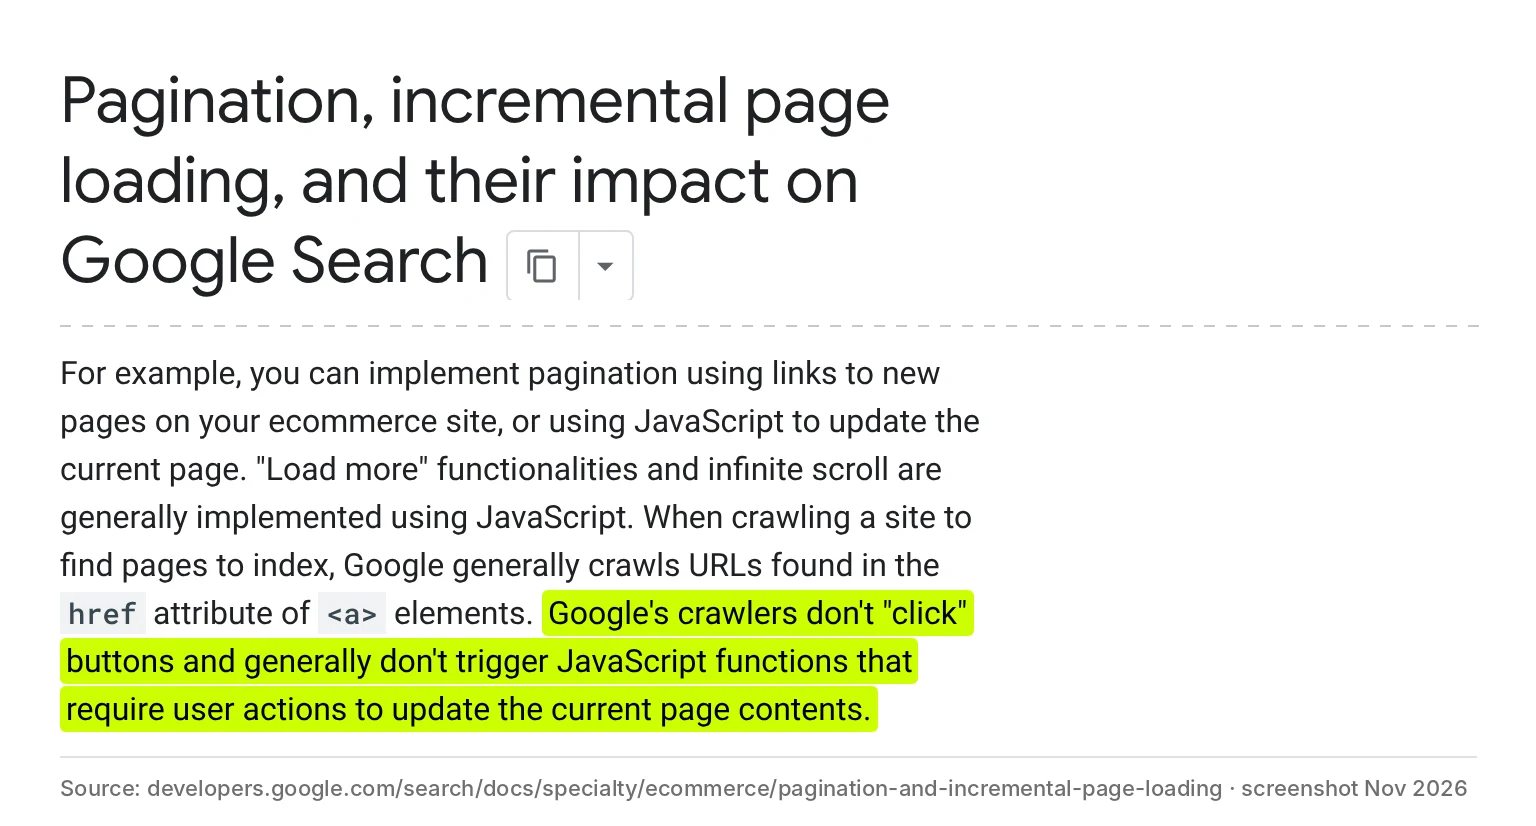
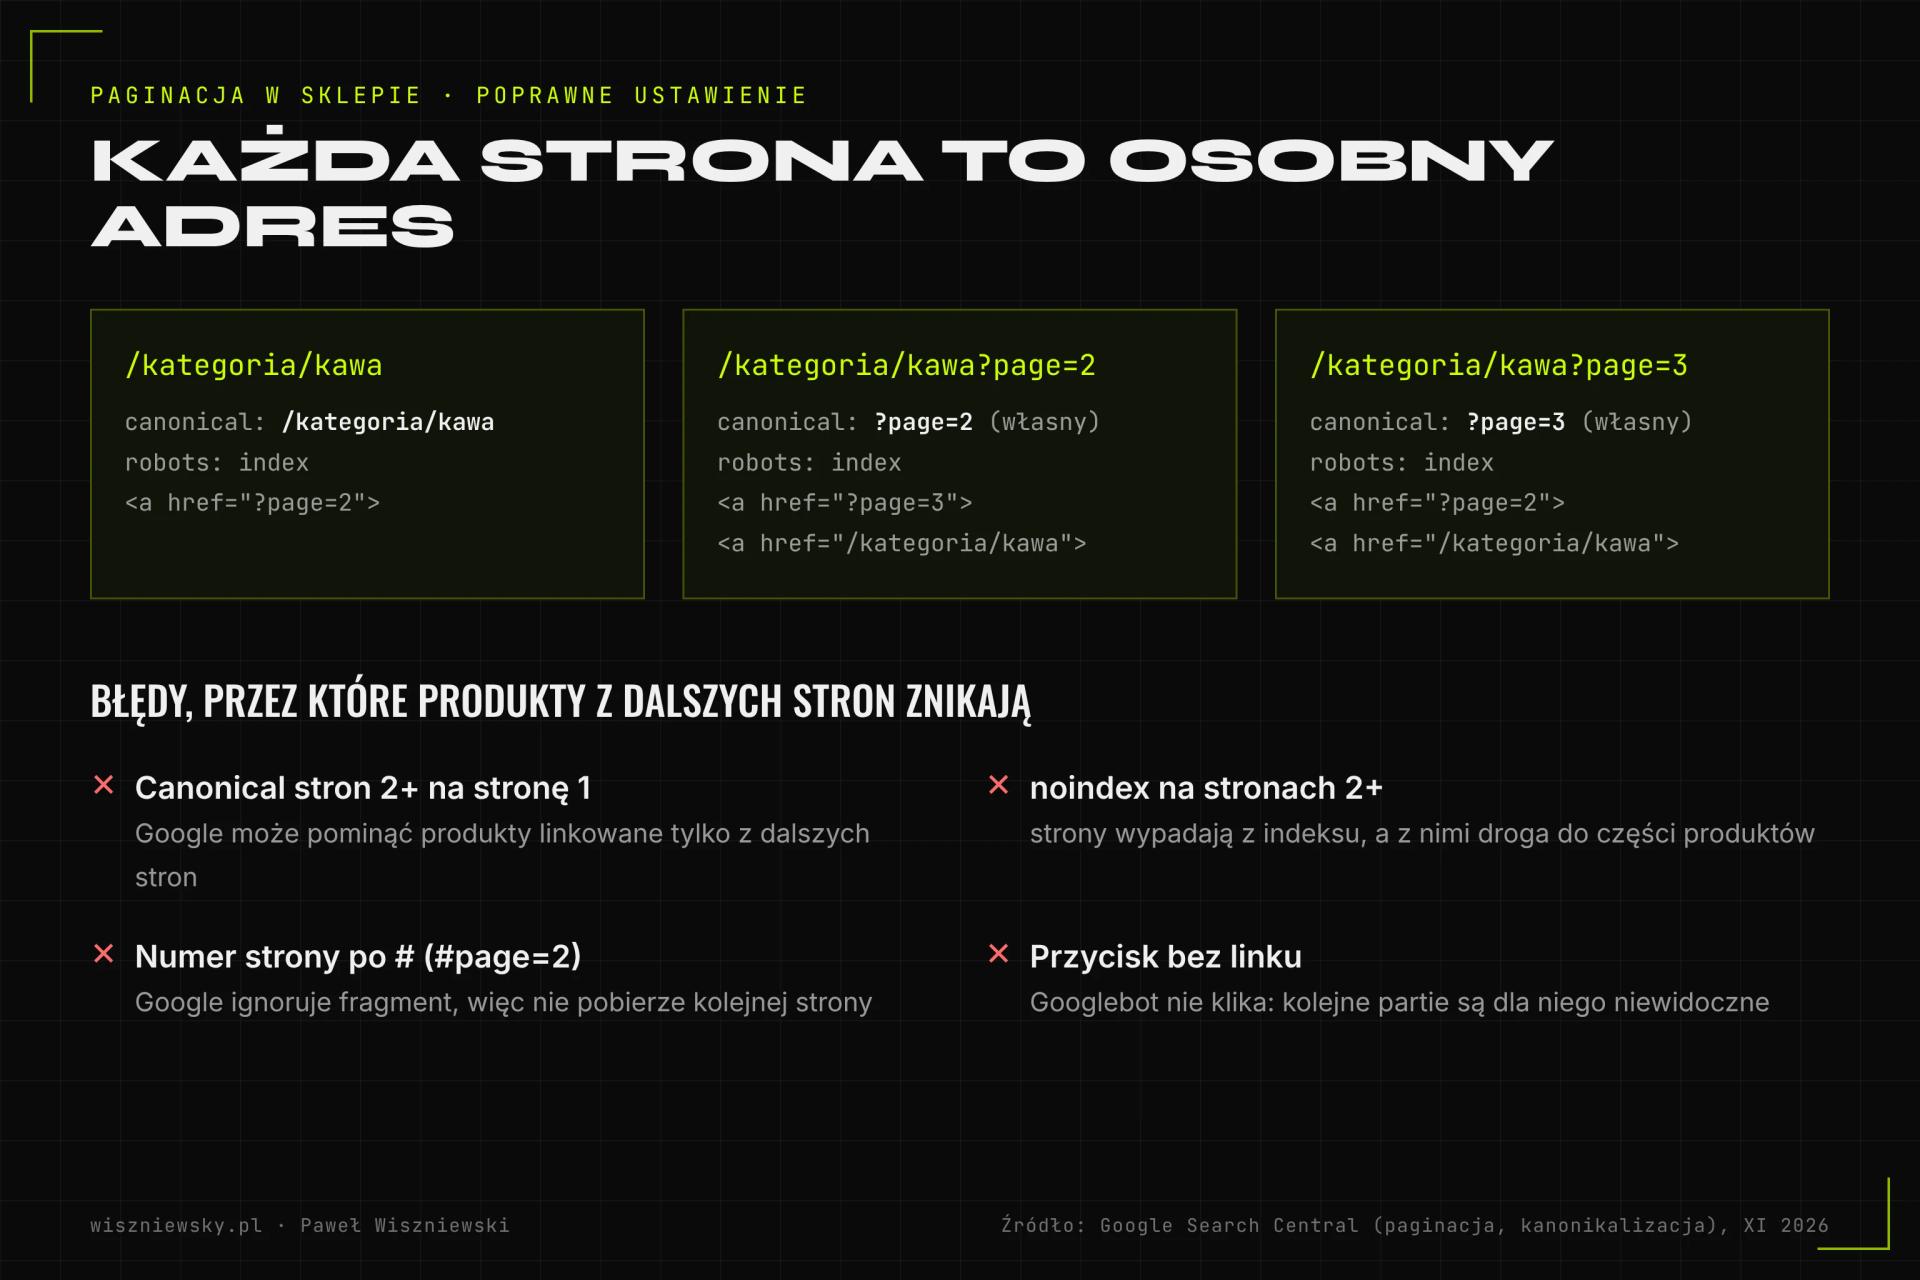
1. Googlebot nie klika przycisków. Google pobiera adresy z atrybutu href elementów <a>. Przycisk „Załaduj więcej” albo infinite scroll, które dociągają produkty JavaScriptem po akcji użytkownika, nie prowadzą Googlebota dalej.
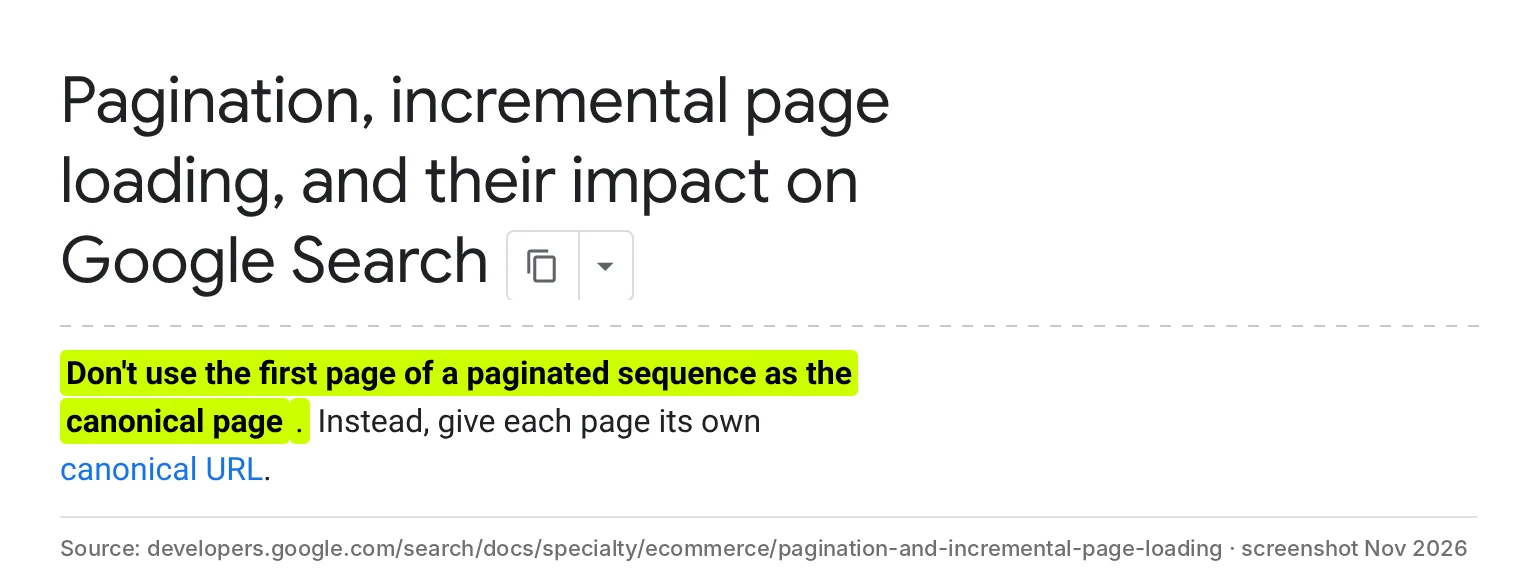
2. Każda strona ma własny canonical. Google wprost pisze, żeby nie używać pierwszej strony jako kanonicznej dla całej serii.
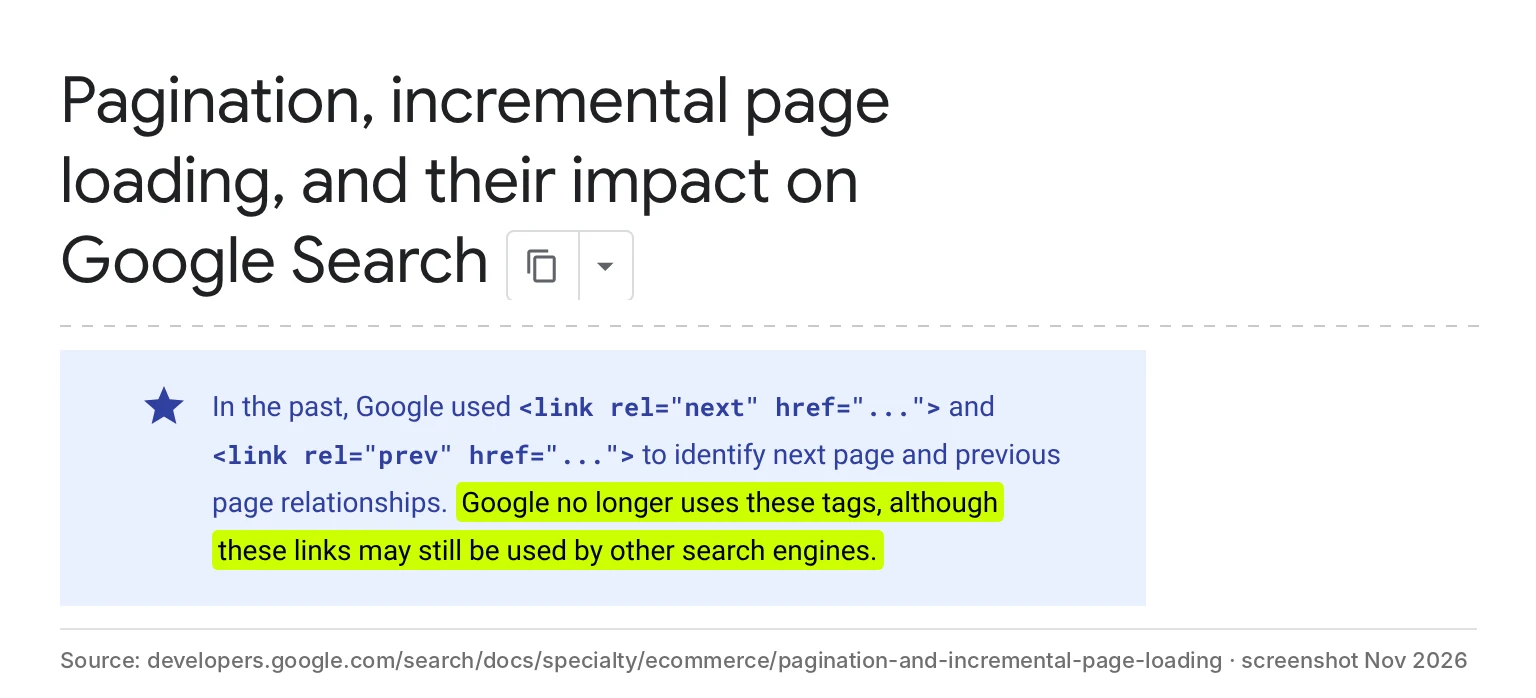
3. rel=next i rel=prev nie są już używane przez Google. Możesz je zostawić (inne wyszukiwarki mogą z nich korzystać), ale nie zastąpią linków w HTML.
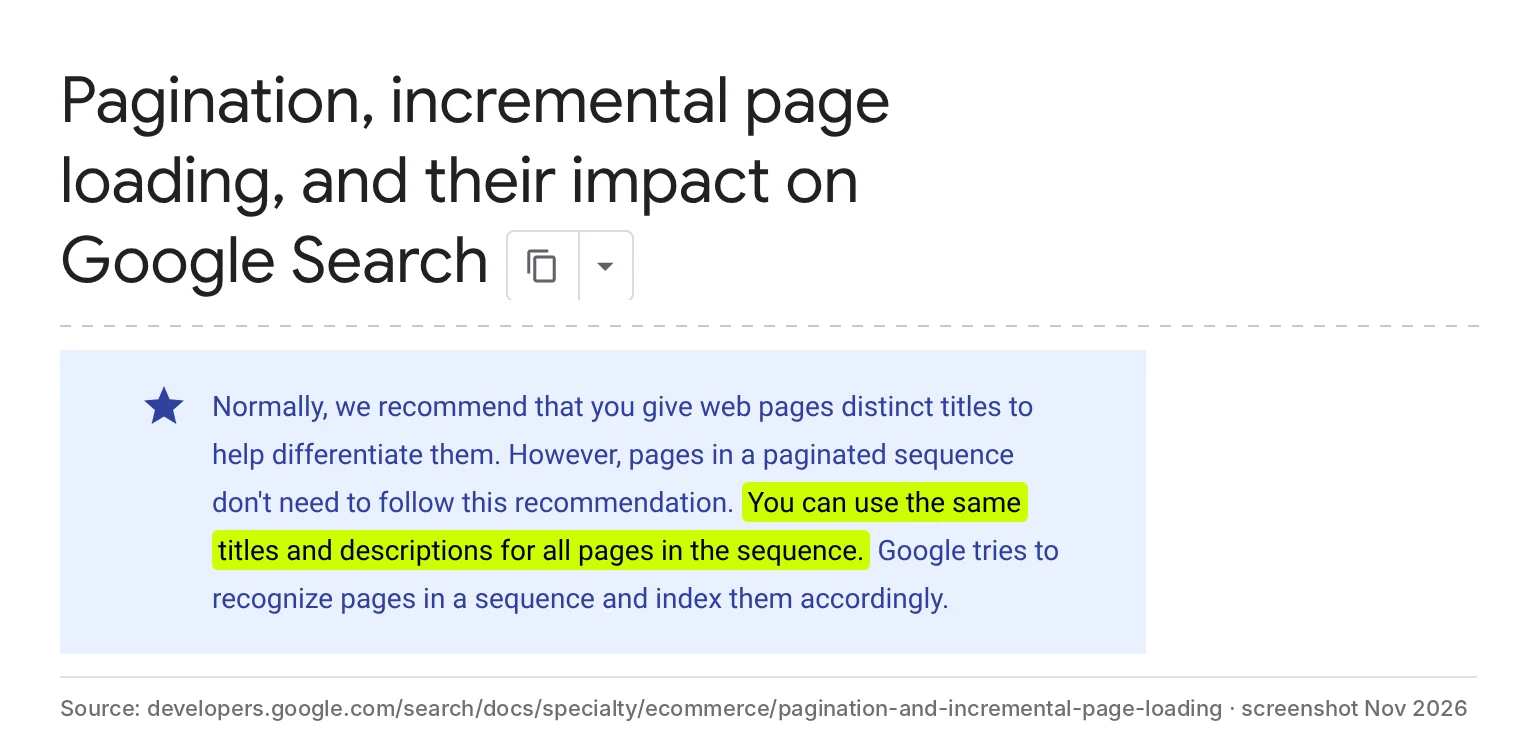
4. Tytuły mogą być takie same. To wyjątek od zasady unikalnych tytułów: strony jednej serii mogą mieć ten sam tytuł i opis. Dopisek „strona 2” nie jest wymagany, ale też nie szkodzi.
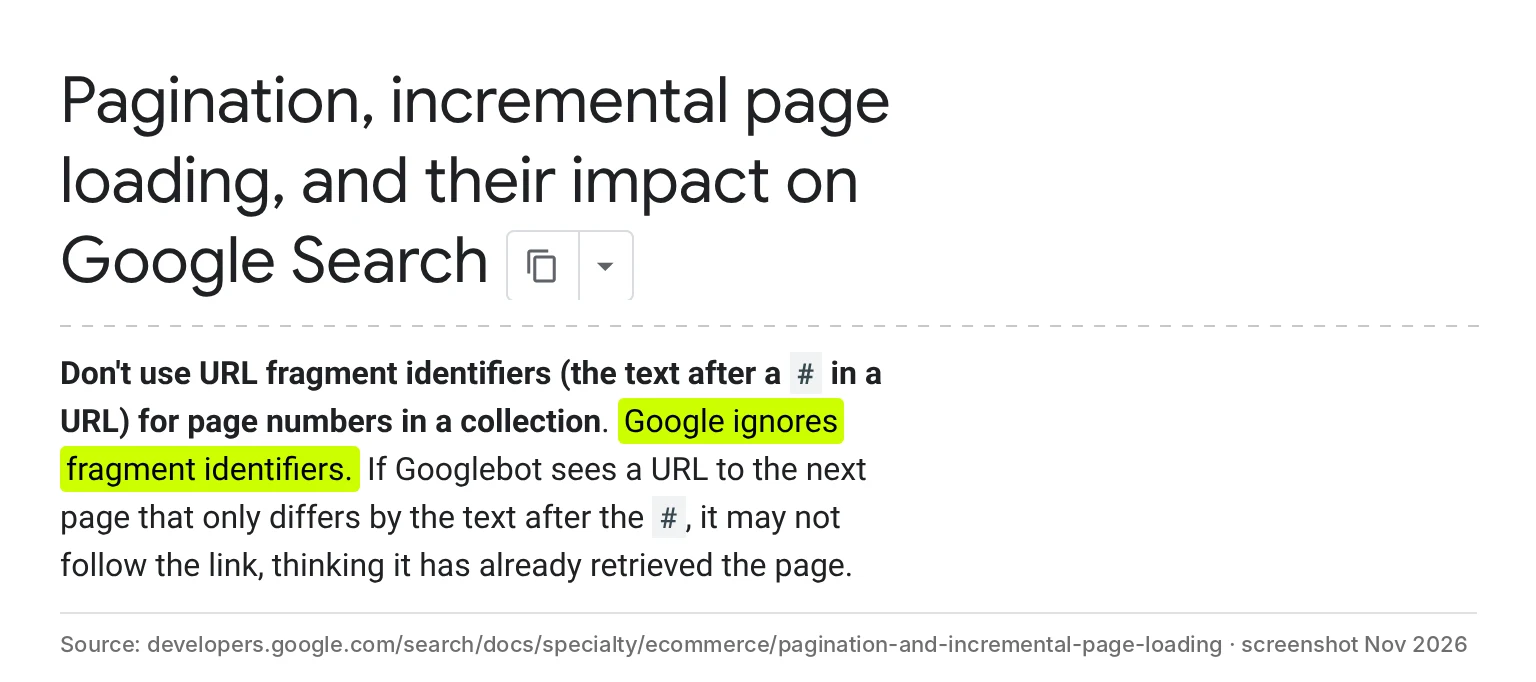
5. Numer strony nie może być po znaku #. Google ignoruje fragment adresu, więc adres kategoria#page=2 jest dla niego tą samą stroną co kategoria.
Do tego dwie rady z tego samego przewodnika: z każdej strony serii warto linkować do strony pierwszej, a adresy z filtrami i innym sortowaniem lepiej trzymać poza indeksem (noindex albo blokada w robots.txt).
Paginacja, „Załaduj więcej” czy infinite scroll - porównanie
Wybór wzorca to decyzja o wygodzie klienta. Dla SEO każdy z nich może działać, pod jednym warunkiem: kolejne partie produktów mają własne adresy z linkami w HTML.
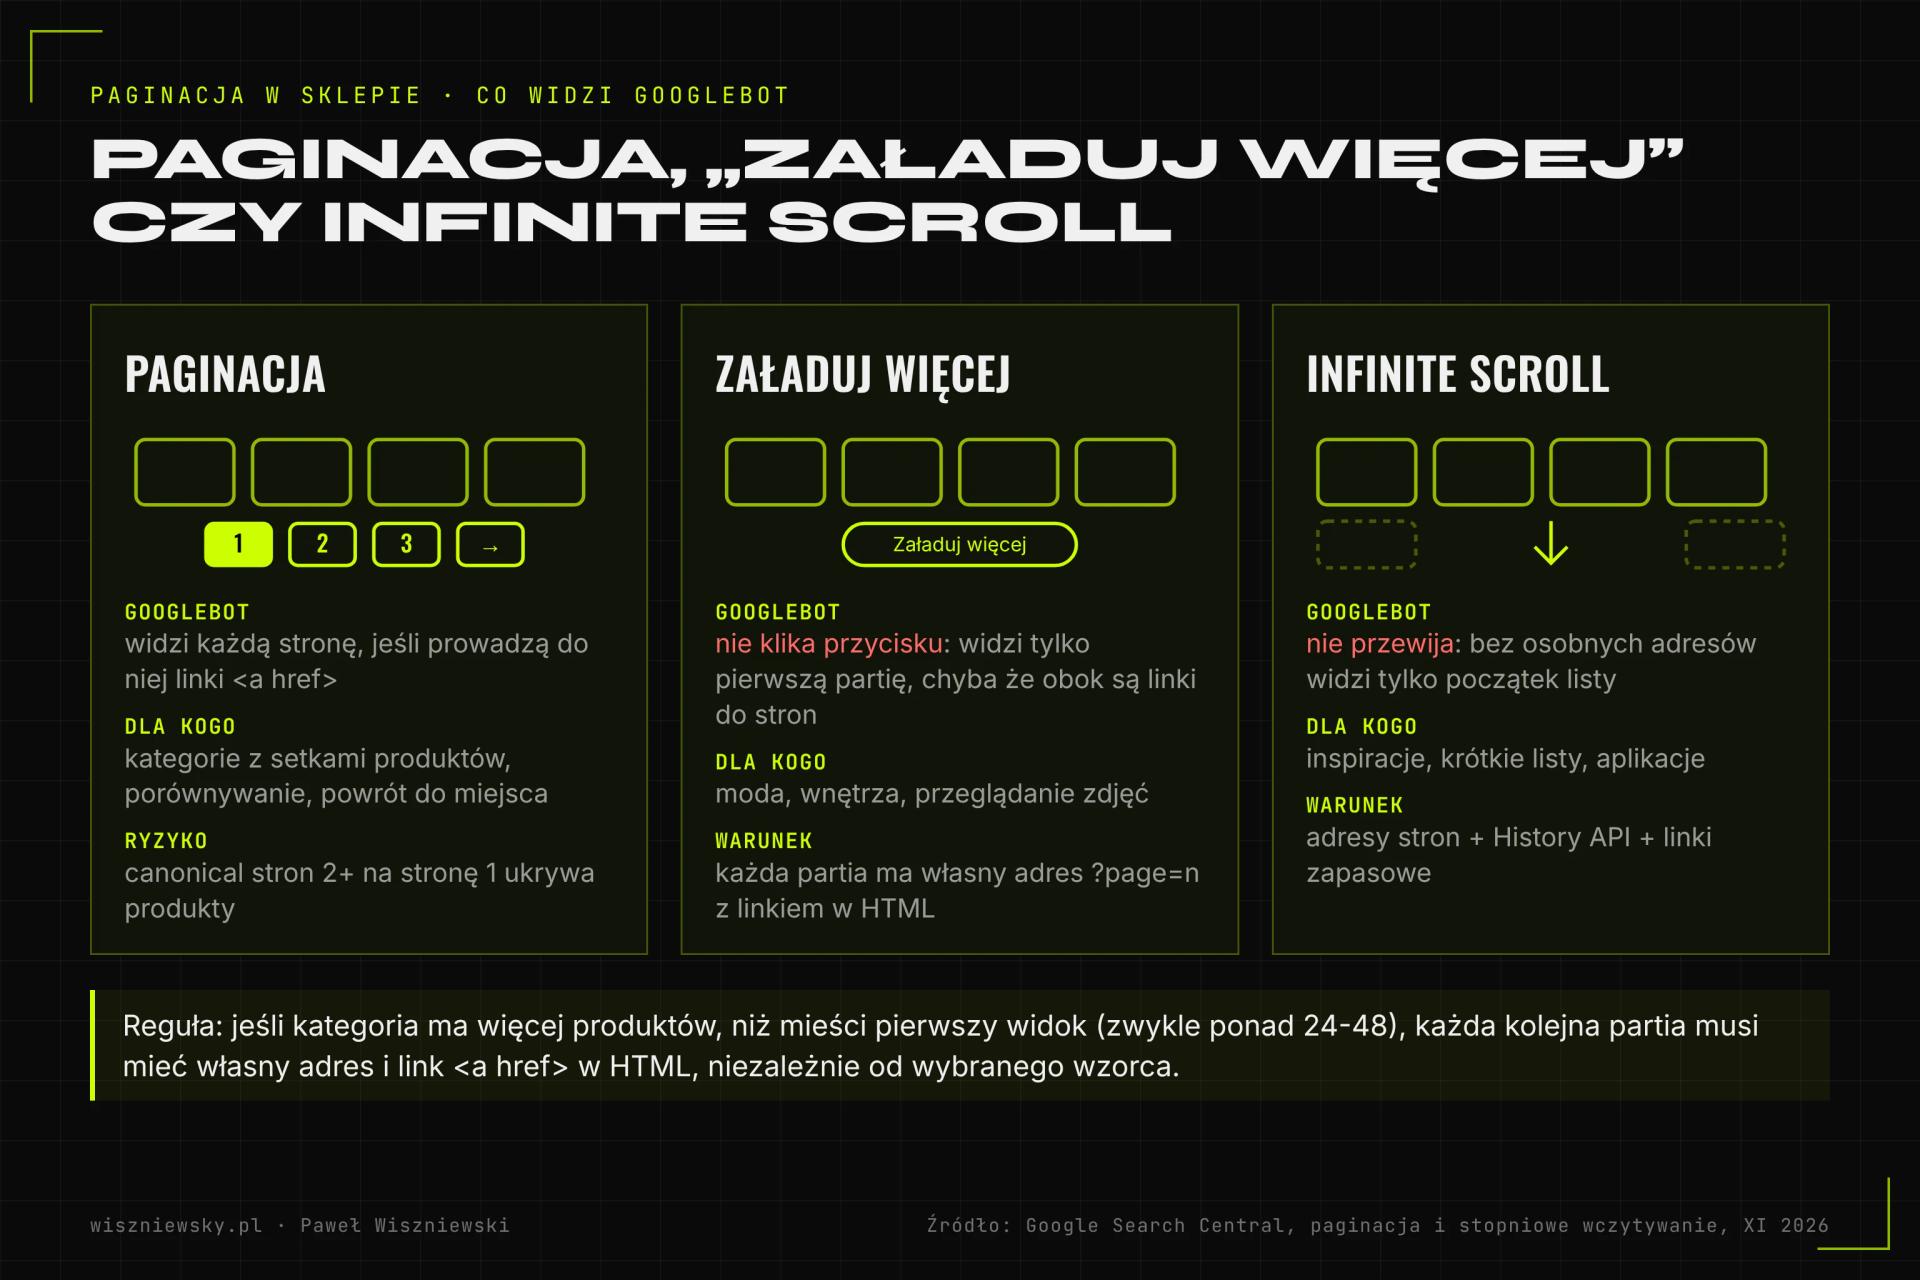
| Kryterium | Infinite scroll | „Załaduj więcej” | Paginacja |
|---|---|---|---|
| Co widzi Googlebot bez dodatków | Tylko początek listy | Tylko pierwszą partię | Wszystkie strony z linkami <a href> |
| Co trzeba dodać dla SEO | Adresy stron, History API, linki zapasowe | Adresy ?page=n i linki do nich | Nic |
| Orientacja klienta | Nie wie, ile jest produktów | Widzi, ile zostało (na przycisku) | Widzi liczbę stron i swoje miejsce |
| Powrót z karty produktu | Często traci pozycję | Często traci pozycję | Wraca na tę samą stronę |
| Stopka sklepu | Trudno dostępna | Dostępna | Zawsze dostępna |
| Dla jakich sklepów | Inspiracje, krótkie listy | Moda, wnętrza, dekoracje | Elektronika, apteki, księgarnie, katalogi z setkami produktów |
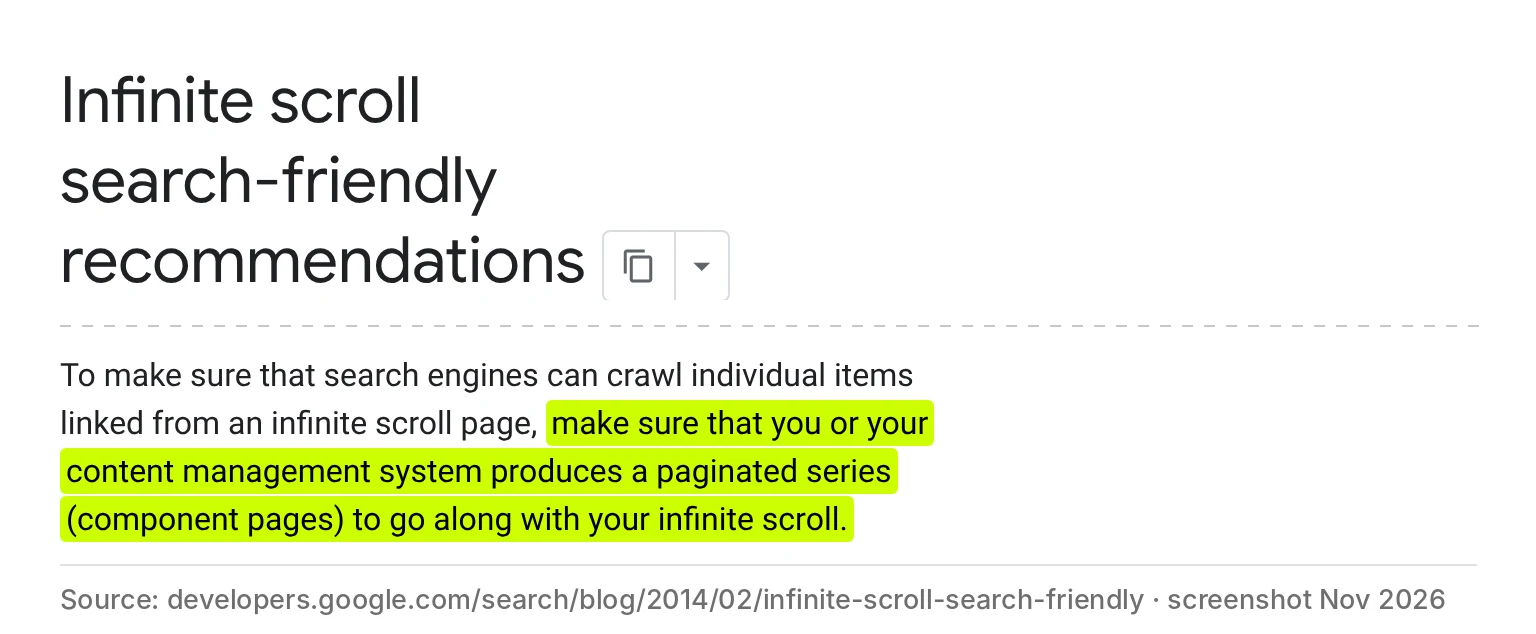
Google od lat zaleca, żeby infinite scroll miał obok serię zwykłych stron, do których prowadzą linki:
Canonical, noindex, rel=next - co ustawić na stronach 2+
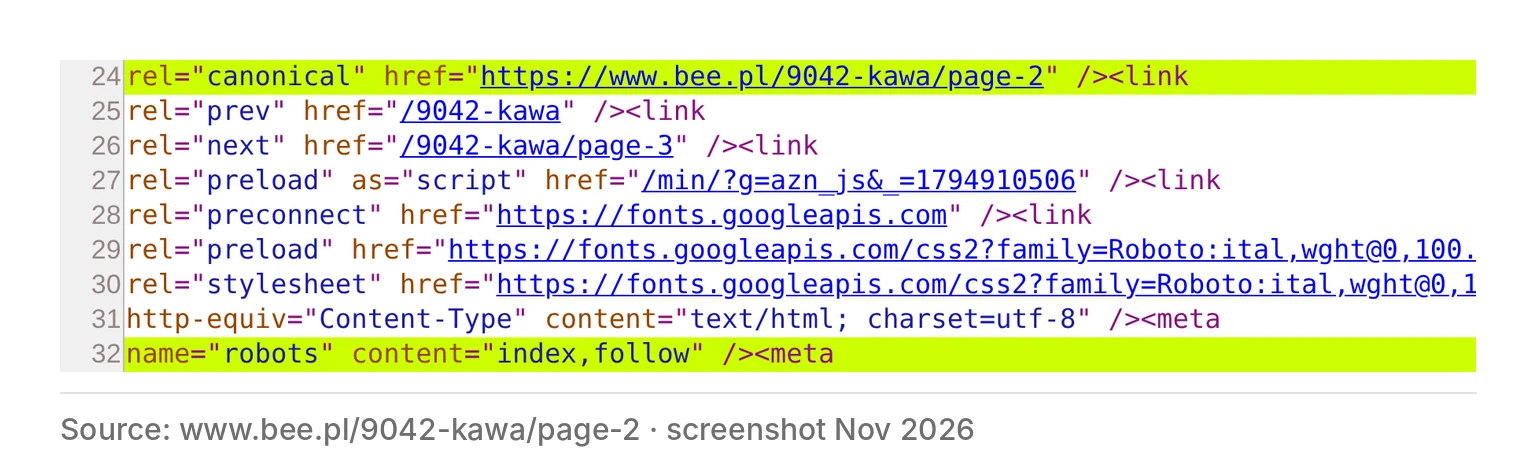
Na stronach 2+ stosuj prosty zestaw: własny canonical, brak noindex, link do strony następnej i do pierwszej. Tak wygląda to na przykładzie strony 2 kategorii kaw w sklepie bee.pl:
| Ustawienie na stronie 2+ | Co się dzieje | Werdykt |
|---|---|---|
| Własny canonical (?page=2 wskazuje ?page=2) | Google traktuje stronę jako osobną i przechodzi dalej po linkach | Tak |
| Canonical na stronę 1 | Sygnał, że strona 2 to duplikat strony 1 - Google może ją pomijać razem z linkami do produktów | Nie |
| Brak canonicala | Google sam wybiera wersję kanoniczną, przy parametrach w adresie bywa to przypadkowe | Lepiej dodać własny |
| noindex | Strona wypada z indeksu, a z nią droga do części produktów | Nie |
| nofollow (meta robots) | Google nie podąża za linkami z tej strony, także do produktów | Nie |
| rel=next i rel=prev | Google ich nie używa, inne wyszukiwarki mogą | Opcjonalnie |
| Strona „Pokaż wszystko” jako canonical | Działa tylko, gdy cała lista ładuje się szybko | Rzadko w sklepach |
Adresy i tytuły stron paginacji
Adres może mieć numer w parametrze (?page=2, ?p=2) albo w ścieżce (/strona/2, /page-2). Dla Google oba sposoby działają, ważne, żeby był stały i bez znaku #. W moim audycie 14 z 19 sklepów ma numer w parametrze, a 5 w ścieżce.
Trzy zasady, o których łatwo zapomnieć:
- Strona 1 bez numeru. Link „1” w paginacji powinien prowadzić do adresu kategorii, a nie do ?page=1. Jeśli ?page=1 istnieje, niech ma canonical do adresu kategorii albo przekierowanie 301.
- Nieistniejąca strona to 404. Adres ?page=999 nie powinien zwracać pustej listy z kodem 200 ani przekierowywać na stronę 1.
- Tytuł z dopiskiem jest opcjonalny. 16 z 19 sprawdzonych sklepów dopisuje „strona 2” do tytułu. To dobra praktyka dla klienta w zakładkach przeglądarki, ale Google jej nie wymaga.
Paginacja a filtry i sortowanie
Paginuj tylko podstawową listę kategorii. Jeśli klient wybierze filtr albo sortowanie, adresy typu ?kolor=czarny&page=2 albo ?sort=cena&page=3 mnożą się bardzo szybko i zjadają crawl. Dla Google rozwiązanie jest takie samo jak dla samych filtrów: indeksowane są tylko filtry z popytem jako osobne strony, a reszta kombinacji ma noindex albo blokadę w robots.txt. Jak zdecydować, które filtry indeksować, opisuję we wpisie o filtrach w sklepie internetowym.
Uwaga na kolejność: jeśli blokujesz w robots.txt wszystkie adresy z parametrem page, a paginacja używa parametru, zablokujesz też zwykłe strony 2+ kategorii. Reguła blokady powinna dotyczyć kombinacji filtrów i sortowania, a nie samego numeru strony.
Ile produktów na stronie kategorii
Nie ma jednej liczby od Google. Praktyczna zasada: tyle, żeby strona ładowała się szybko na telefonie (sprawdź LCP w Core Web Vitals) i żeby najważniejsze produkty kategorii były najwyżej dwa kliknięcia od strony głównej. Więcej produktów na stronie to mniej stron do przejścia dla Googlebota, ale cięższa strona dla klienta.
| Wielkość kategorii | Produktów na stronie | Co jeszcze zrobić |
|---|---|---|
| Do 50 produktów | 24-48, często jedna strona | Wystarczy zwykła paginacja albo brak |
| 50-500 produktów | 24-60 | Paginacja z linkami w HTML, podkategorie dla grup z popytem |
| Ponad 500 produktów | 36-60 | Podkategorie i filtry z popytem jako osobne strony, mapa witryny z produktami |
Przy dużych kategoriach sama paginacja nie wystarczy, żeby Google szybko znalazł nowe produkty z końca listy. Pomagają linki z podkategorii, sekcje „nowości” i mapa witryny - piszę o tym we wpisie o indeksacji sklepu internetowego.
Co pokazał mój audyt 19 polskich sklepów
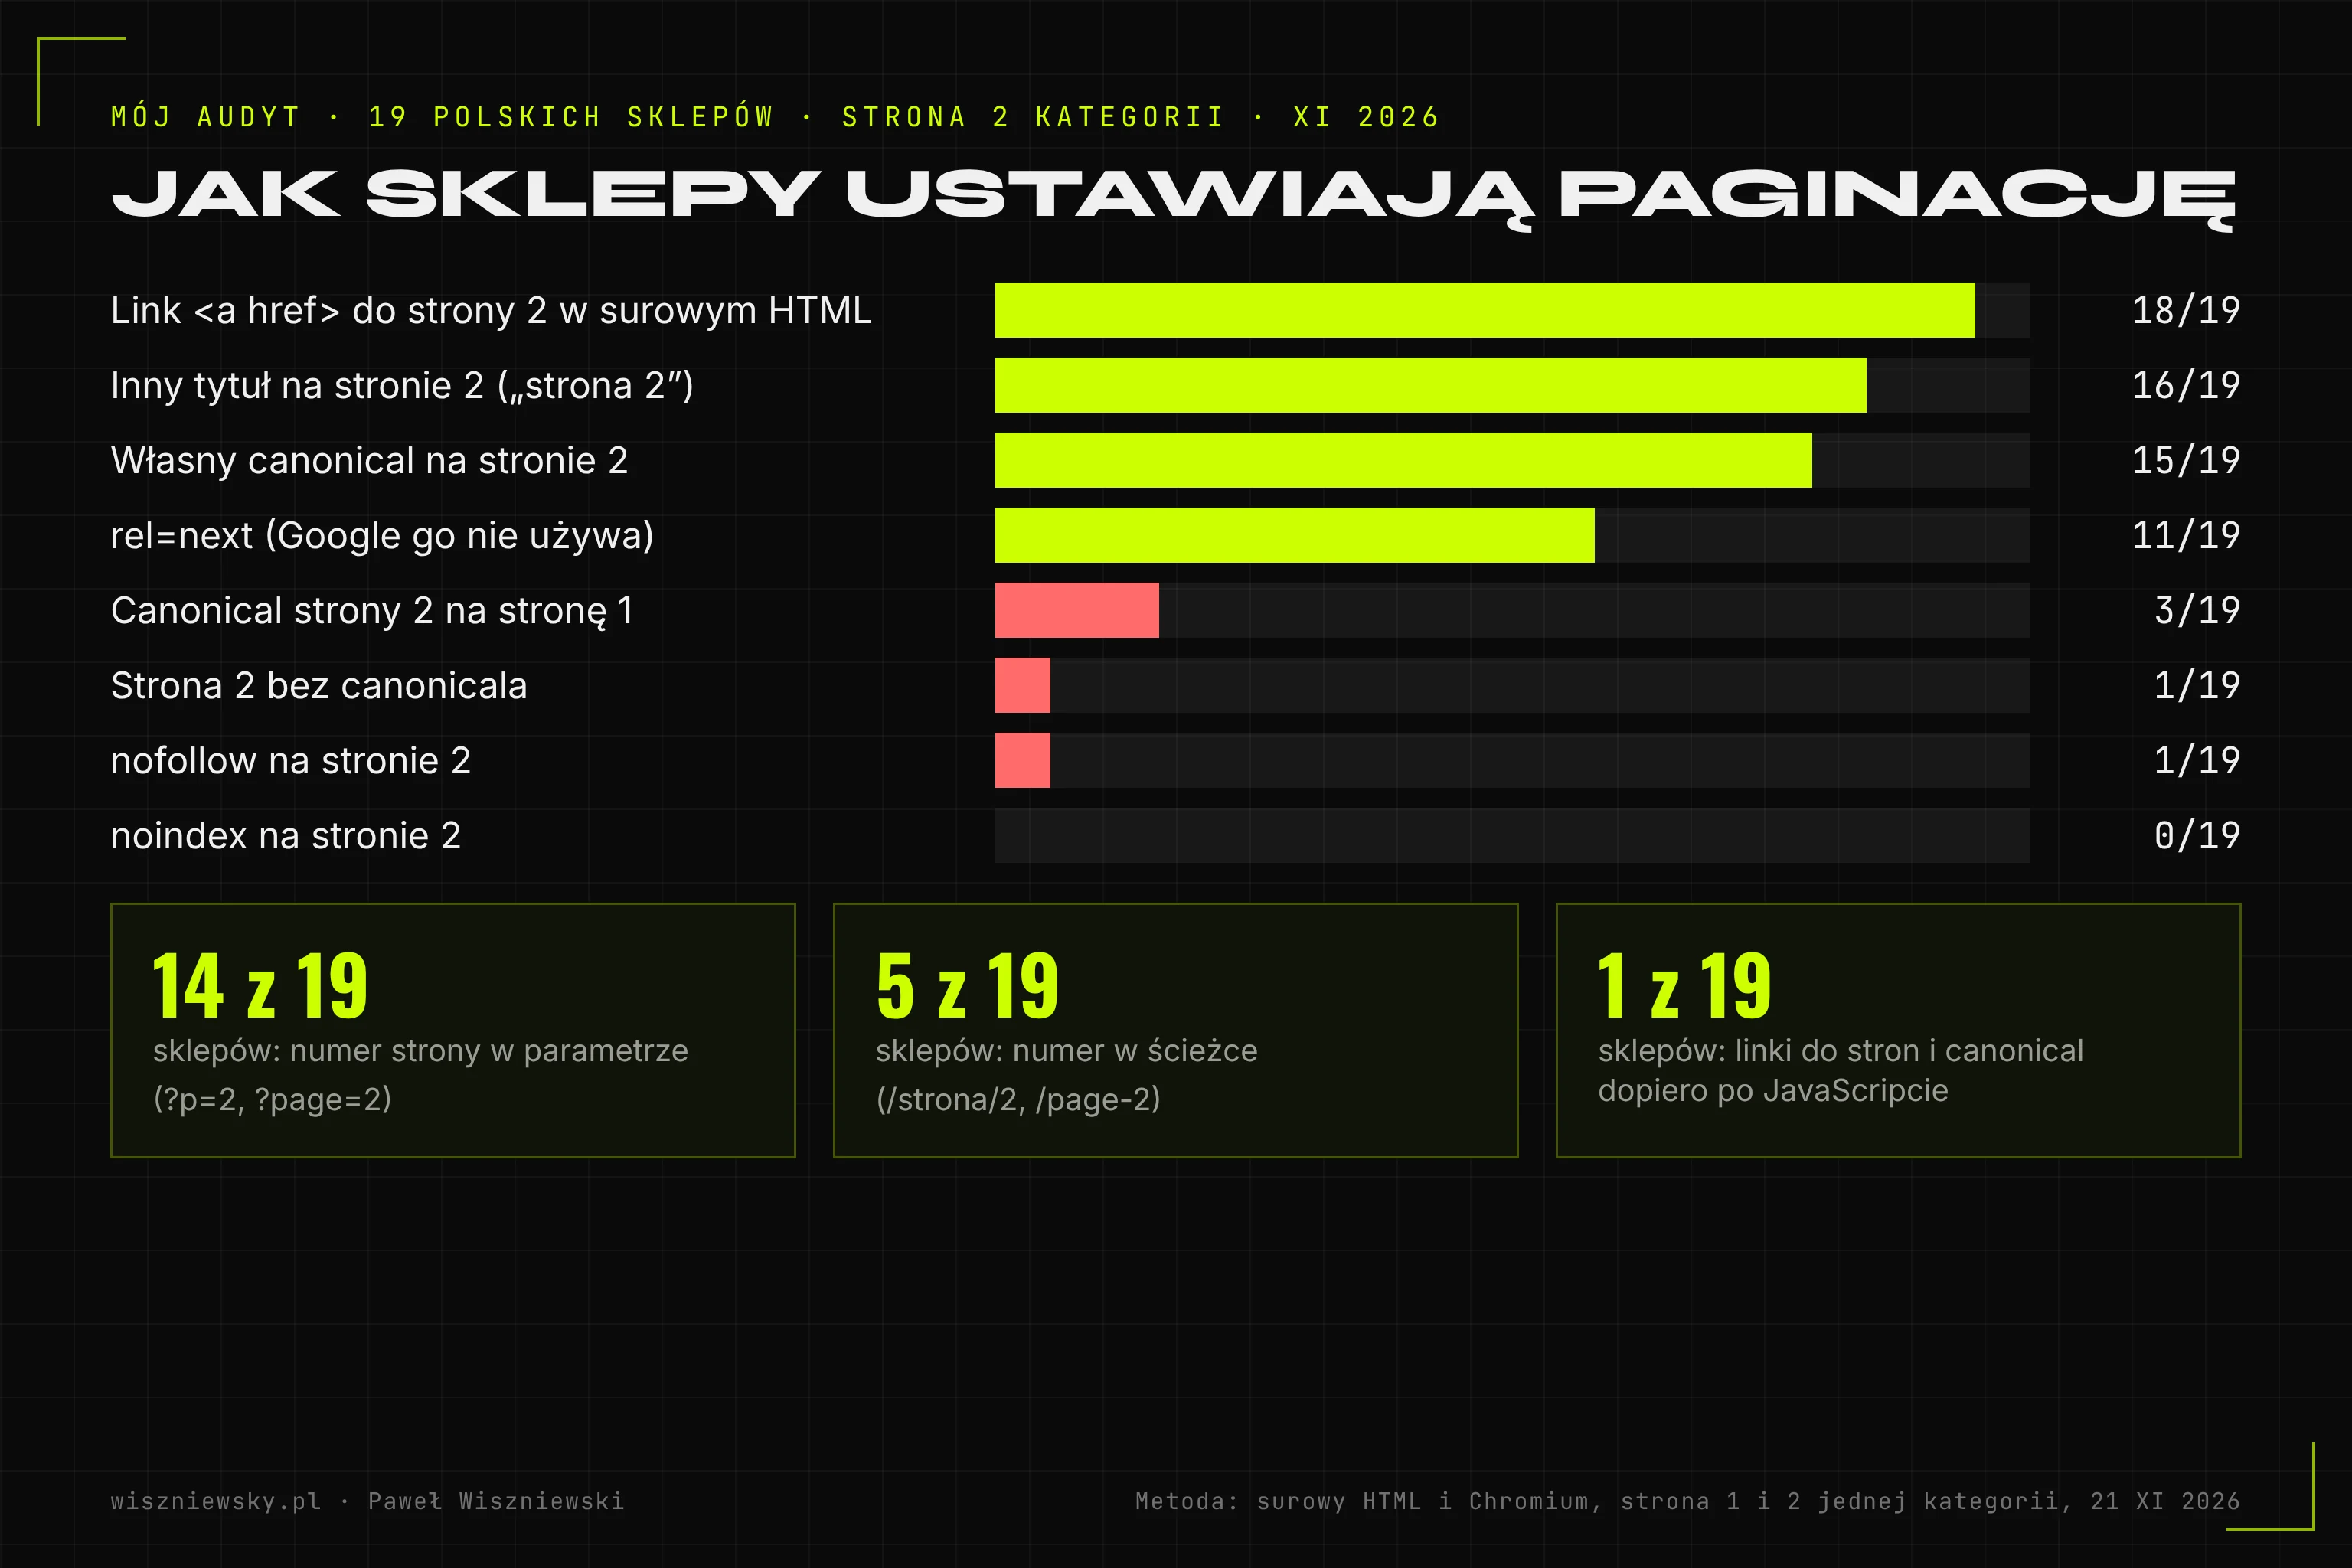
21 listopada 2026 sprawdziłem stronę 1 i 2 jednej kategorii w polskich sklepach (elektronika, drogerie, apteki, księgarnie, moda, meble, zoologiczne). Pobierałem surowy HTML, czyli wersję bez JavaScriptu, i porównywałem ją z wersją wyrenderowaną w Chromium. Paginację dało się sprawdzić w 19 sklepach. W kilku innych dostęp blokowała ochrona przed botami albo nie znalazłem kategorii z drugą stroną, więc nie ma ich w wynikach.
| Element na stronie 2 kategorii | Sklepy | Komentarz |
|---|---|---|
| Link <a href> do strony 2 w surowym HTML strony 1 | 18 z 19 | Jeden sklep pokazuje linki dopiero po JavaScripcie |
| Własny canonical | 15 z 19 | Wzorcowe ustawienie |
| Canonical na stronę 1 | 3 z 19 | W jednym przypadku canonical dodaje dopiero JavaScript |
| Brak canonicala | 1 z 19 | Google sam wybiera wersję kanoniczną |
| noindex | 0 z 19 | Nikt nie wyłącza stron 2+ z indeksu |
| nofollow w meta robots | 1 z 19 | Google nie podąża za linkami do produktów z tej strony |
| rel=next lub rel=prev | 11 z 19 | Google ich nie używa, ale nie szkodzą |
| Inny tytuł niż na stronie 1 | 16 z 19 | Dopisek „strona 2” albo „Strona 2 -” |
| Numer strony w parametrze | 14 z 19 | ?p=2, ?page=2, ?strona=2, ?counter=1, ?start=61 |
| Numer strony w ścieżce | 5 z 19 | /strona/2, /page-2, /2/ |
| Numer strony po # | 0 z 19 | - |
Wybrane sklepy z próby:
| Sklep | Adres strony 2 | Canonical strony 2 | Link w surowym HTML | Uwagi |
|---|---|---|---|---|
| bee.pl | /page-2 | własny | tak | rel=next i prev |
| doz.pl | /strona/2 | własny | tak | rel=next |
| zooplus.pl | ?p=2 | własny | tak | rel=next |
| morele.net | /2/ | własny | tak | tytuł z „strona 2” |
| taniaksiazka.pl | /page-2 | własny | tak | rel=next |
| eZebra.pl | ?counter=1 | własny | tak | numeracja od zera w parametrze |
| drogerienatura.pl | ?p=2 | własny | tak | robots INDEX,NOFOLLOW na stronie 2 |
| rossmann.pl | ?Page=2 | strona 1 | tak | ten sam tytuł co strona 1 |
| empik.com | ?start=61 | strona 1 | tak | rel=next i prev |
| swiatksiazki.pl | ?p=2 | strona 1 (po JavaScripcie) | nie | surowy HTML bez listy produktów |
| smyk.com | ?p=2 | brak | tak | rel=next |
Najważniejsze wnioski z audytu:
- Podstawy są w porządku. 18 z 19 sklepów ma link do strony 2 w surowym HTML, nikt nie stosuje noindex ani numeru po znaku #.
- Canonical na stronę 1 to wciąż spotykany wzorzec. Ma go 3 z 19 sklepów. Duże sklepy zwykle mają produkty także w mapach witryny i w innych kategoriach, więc skutki bywają mniejsze, ale w mniejszym sklepie, gdzie produkt jest linkowany tylko z kategorii, może to oznaczać produkty, do których Google nie dociera.
- rel=next przetrwał w ponad połowie sklepów. Nie szkodzi, ale nie zastępuje linków i nie warto na nim polegać.
- Najgroźniejszy przypadek to lista dopiero po JavaScripcie. W jednym sklepie surowy HTML strony kategorii nie zawiera produktów ani linków do kolejnych stron, a canonical pojawia się dopiero po wyrenderowaniu. Google może to wyrenderować, ale robi to później, a crawlery AI JavaScriptu nie wykonują - więcej w moim wpisie o JavaScript SEO.
Takie sprawdzenie paginacji, filtrów i canonicali na wszystkich szablonach list robię w ramach usługi pozycjonowania sklepów internetowych.
Ile to pracy - dwie skale
| Zakres | Mały sklep (do 1 tys. produktów, gotowa platforma) | Duży sklep (ponad 20 tys. produktów, własny szablon) |
|---|---|---|
| Audyt paginacji | 1-2 godziny (skrypt niżej na kilku kategoriach) | 1-2 dni (crawler, logi serwera, wszystkie szablony list) |
| Poprawka canonicala i robots | Ustawienie w motywie lub wtyczce SEO, 1-2 godziny | Zmiana szablonu i testy, 2-5 dni pracy dewelopera |
| Zamiana „Załaduj więcej” na wersję z adresami stron | 1-2 dni (często gotowe rozwiązanie w motywie) | 1-2 tygodnie (adresy, History API, testy na urządzeniach) |
| Sprawdzenie efektu | Search Console po 2-4 tygodniach | Logi serwera i Search Console po 2-6 tygodniach |
Skrypt: sprawdź paginację na swojej kategorii
Skrypt pobiera stronę 1 i 2 kategorii bez JavaScriptu, czyli tak, jak widzi je crawler przed renderowaniem, i pokazuje canonical, meta robots, rel=next, tytuł oraz to, czy strona 1 ma link <a href> do strony 2. Wymaga tylko Pythona 3.
# Użycie: python3 sprawdz_paginacje.py https://sklep.pl/kategoria https://sklep.pl/kategoria?page=2import re, sys, urllib.requestfrom urllib.parse import urljoin, urlsplitUA = "Mozilla/5.0 (compatible; pagination-check/1.0)"def pobierz(url): req = urllib.request.Request(url, headers={"User-Agent": UA}) with urllib.request.urlopen(req, timeout=20) as r: return r.status, r.geturl(), r.read().decode("utf-8", "ignore")def meta(html, base): head = html.split("</head>")[0] can = re.search(r'<link[^>]+rel=["\']canonical["\'][^>]*href=["\']([^"\']+)', head, re.I) rob = re.search(r'<meta[^>]+name=["\']robots["\'][^>]*content=["\']([^"\']+)', head, re.I) title = re.search(r"<title[^>]*>(.*?)</title>", head, re.I | re.S) return {"canonical": urljoin(base, can.group(1)) if can else None, "robots": rob.group(1) if rob else "(brak)", "rel_next": bool(re.search(r'<link[^>]+rel=["\']next', head, re.I)), "title": title.group(1).strip() if title else None}def linki(html, base): return {urljoin(base, h).split("#")[0] for h in re.findall(r'<a[^>]+href=["\']([^"\']+)', html, re.I)}strona1, strona2 = sys.argv[1], sys.argv[2]s1, u1, h1 = pobierz(strona1)s2, u2, h2 = pobierz(strona2)m1, m2 = meta(h1, u1), meta(h2, u2)print("Strona 1:", s1, m1)print("Strona 2:", s2, m2)print("Link <a href> do strony 2 w HTML strony 1:", strona2 in linki(h1, u1))if m2["canonical"] and m2["canonical"].rstrip("/") == u1.rstrip("/"): print("UWAGA: canonical strony 2 wskazuje stronę 1")if "noindex" in m2["robots"].lower() or "nofollow" in m2["robots"].lower(): print("UWAGA: strona 2 ma noindex albo nofollow")if "#" in strona2: print("UWAGA: numer strony po # - Google ignoruje fragment adresu")
Uwaga: część dużych sklepów blokuje zapytania bez przeglądarki (kod 403 albo strona „Just a moment”). Wtedy sprawdź to samo ręcznie: otwórz stronę 2, wybierz „Pokaż źródło strony” i wyszukaj canonical oraz robots, a w Search Console użyj Sprawdzania adresu URL, które pokazuje wersję widzianą przez Googlebota.
Pułapka produkcyjna: canonical do strony 1 po zmianie motywu albo wtyczki
Najczęstszy scenariusz, który widzę w audytach: sklep miał poprawną paginację, potem zmienił motyw, wtyczkę SEO albo wdrożył nowy szablon listingu i strony 2+ zaczęły wskazywać canonicalem stronę 1. Nikt tego nie zauważa, bo strona wygląda tak samo, a skutki przychodzą po kilku tygodniach: w Search Console rośnie liczba adresów „Strona alternatywna z prawidłowym tagiem strony kanonicznej”, a nowe produkty z końca listy indeksują się coraz wolniej.
Jak się zabezpieczyć:
- 1.Po każdej zmianie motywu, wtyczki SEO albo szablonu kategorii uruchom skrypt z tego wpisu na 3-5 kategoriach.
- 2.Dodaj ten test do listy kontrolnej wdrożenia (albo do testów automatycznych, jeśli sklep je ma).
- 3.Raz w miesiącu sprawdź w Search Console, czy liczba stron paginacji ze statusem „Strona alternatywna z prawidłowym tagiem strony kanonicznej” nagle nie urosła.
Drugi wariant tej samej pułapki: wtyczka „dla porządku” dodaje noindex do stron 2+. Na krótką metę nic się nie dzieje, ale z czasem Google rzadziej odwiedza te strony i produkty linkowane tylko z nich tracą ścieżkę do indeksu.
Czego nie robić
- Nie ustawiaj canonicala stron 2+ na stronę 1.
- Nie dodawaj noindex ani nofollow do stron paginacji.
- Nie umieszczaj numeru strony po znaku # (kategoria#page=2).
- Nie opieraj dalszych produktów tylko na przycisku albo infinite scrollu bez adresów stron i linków w HTML.
- Nie blokuj w robots.txt parametru strony, jeśli paginacja go używa.
- Nie licz na rel=next jako jedyny sposób powiązania stron - Google go nie używa.
- Nie zwracaj pustej listy z kodem 200 dla nieistniejących stron (?page=999).
FAQ
Podsumowanie
Paginacja w sklepie to jedna z tych rzeczy, które po ustawieniu działają latami, pod warunkiem że nikt ich nie zepsuje zmianą motywu. Kontrola zajmuje kilka minut: link <a href> do strony 2 w surowym HTML, własny canonical, brak noindex i nofollow, numer strony bez znaku #. Kolejność wszystkich prac w sklepie opisuję w strategii SEO dla sklepu internetowego. Jeśli chcesz, żebym sprawdził paginację, filtry i indeksację w Twoim sklepie i przygotował poprawki dla szablonów, zobacz usługę pozycjonowania sklepów internetowych.
Usługi powiązane z tym tematem
Potrzebujesz wdrożenia tych koncepcji? Zobacz usługi powiązane z tym tematem.
Źródła
- 01Google Search Central - Pagination, incremental page loading, and their impact on Google Search
- 02Google Search Central - Make your links crawlable
- 03Google Search Central - How to specify a canonical URL
- 04Google Search Central - Managing crawling of faceted navigation URLs
- 05Google Search Central Blog - Infinite scroll search-friendly recommendations (2014)
- 06Google Search Central - JavaScript SEO basics
Powiązane artykuły
Dane strukturalne w sklepie internetowym - Product, Offer, warianty (ProductGroup) i BreadcrumbList w praktyce
Jakie dane strukturalne powinien mieć sklep: merchant listing czy krótki opis produktu, wymagane pola Product i Offer, zwroty i dostawa w Organization, warianty przez ProductGroup, okruszki, oceny, JSON-LD czy JavaScript, audyt 36 kart w 19 polskich sklepach, skrypt i pułapka z ceną promocyjną.
Indeksacja sklepu internetowego - dlaczego Google nie indeksuje produktów i kategorii i jak to naprawić
Dlaczego Google nie indeksuje produktów i kategorii: statusy z Search Console przełożone na przyczyny w sklepie, „Wykryto” czy „Zeskanowano - obecnie nie zindeksowano”, produkty niedostępne i wycofane, warianty, mapy witryn 30 polskich sklepów, skrypt URL Inspection API i pułapka z lastmod.
Filtry w sklepie internetowym a SEO - które indeksować, a które blokować (noindex, canonical, robots.txt)
Które filtry w sklepie internetowym indeksować, a które blokować: reguła z progami, noindex vs canonical vs robots.txt vs nofollow w jednej tabeli, sprawdzenie filtrów w 11 polskich sklepach, ustawienia Shopify, WooCommerce, PrestaShop i IdoSell, liczba adresów przy dwóch skalach, robots.txt, skrypt i dwie pułapki.
Signal received?
Umów bezpłatną konsultację
Zainicjuj protokół. Nawiąż połączenie. Zbudujmy coś głośnego.